


- @qq_45709806


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
自动驾驶控制与规划——Project 5: Lattice Planner

自动驾驶控制与规划——Project 4: MPC车辆控制

自动驾驶控制与规划——Project 3: LQR 车辆横向控制

深蓝学院课程 自动驾驶控制与规划 Project1:车辆纵向控制

深蓝学院 自动驾驶控制与规划——Project 2: 车辆横向控制 Stanley控制器

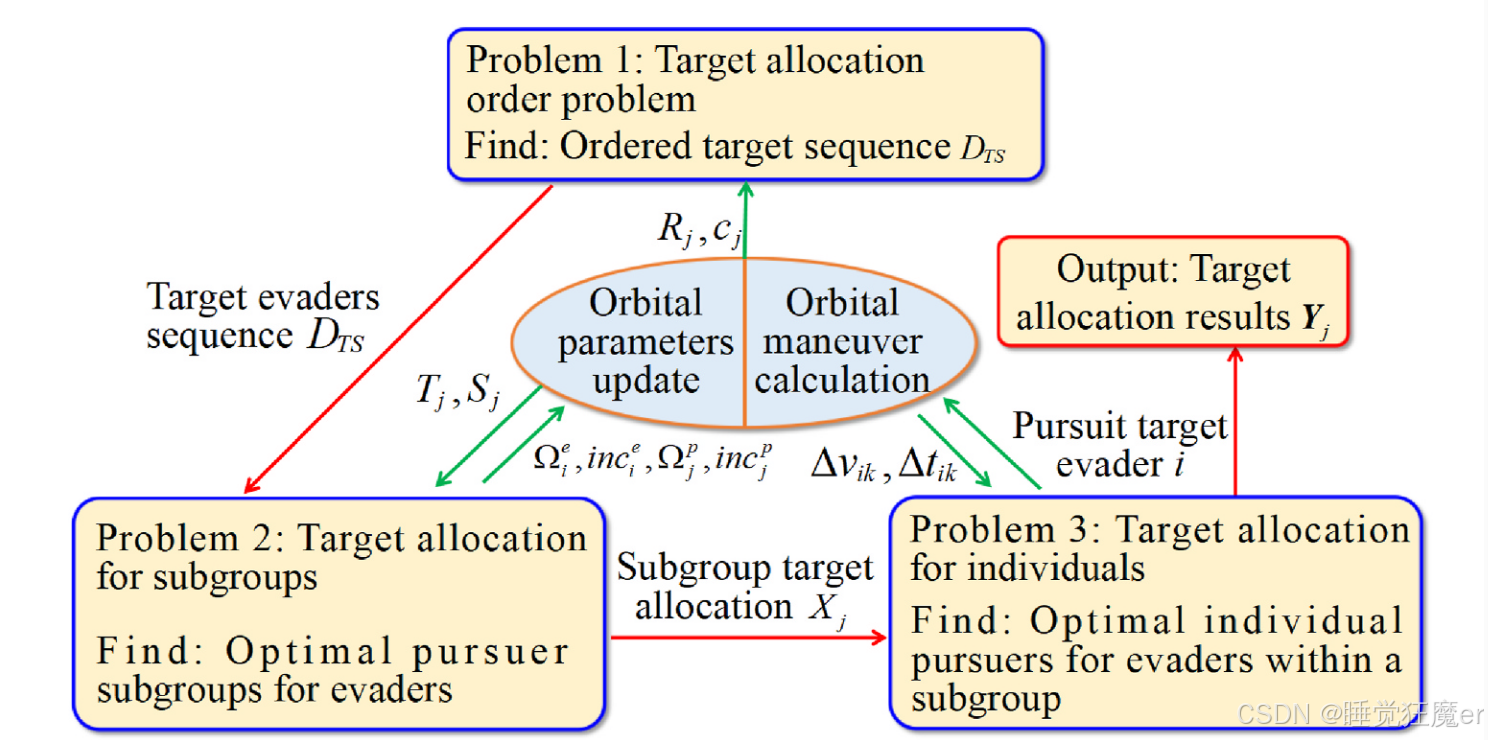
这篇论文研究了一个多对多的轨道追逃博弈场景,追踪星和逃逸星分别位于两个walker星座上(自然而然地由轨道面分为多组)。论文的首先使用双层合同网算法对多对多问题进行目标分配,得到对应关系后,在远距离机动中使用最优兰伯特机动,在近距离博弈机动中使用PPO输出兰伯特转移时间,再使用兰伯特求解器得到三轴速度增量。
该论文提出了一种适用于双人零和马尔可夫博弈的分布式OGDA算法,研究了表格形式的马尔可夫博弈,具有有限时间收敛保证。

直接使用强化学习训练智能体解决部分可观测问题是不成功的,因此论文使用特权学习的方法,将evader的未来轨迹也作为特权信息,首先在仿真环境中训练完全可观测策略(fully-observable policy),并且训练一个用于预测evader未来轨迹的网络,然后使用这一组策略来监督训练机器人上的部分可观测策略和意图预测预测网络。通过这种方法,论文得到了难以处理的分布式部分可观测马尔可夫决策过程的最

论文原文:Task Assignment for Multiplayer Reach-Avoid Games in Convex Domains via Analytical Barriers,解析计算多pursuer多evader的reach avoid博弈的barrier,并且提出了一种通过解析barrier先验信息的0-1规划求解pursuers的任务分配问题

本篇论文考虑在矩形区域上进行的reach-avoid博弈,其中有两名防守者和一名攻击者。攻击者的目标是到达区域边界的特定边缘(ATL),而防御者则努力通过捕获攻击者来阻止这种情况。论文提出了一种Barrier的解析解法,进一步得到了智能体在各自胜利区域以及对方胜利区域内的最优策略,均给出了严谨的证明。
