- @qq_44809804


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
Flink通过"流是根本,批是有界流"的思想革新大数据处理范式。源自2009年柏林工业大学的研究项目,Flink从学术论文走向工业实践,构建了统一的流批执行引擎。其核心架构以流为统一抽象,通过状态管理和时间语义实现Exactly-Once保障。随着云原生化和AI场景扩展,Flink持续演进但保持核心理念不变,推动从计算统一到智能统一的延伸。Flink的成功展现了学术思想与工程实

本文深入解析了Flink作业在Kubernetes集群上的完整提交流程。以Application模式下的WordCount作业为例,详细追踪了从命令行提交到任务执行的关键步骤,揭示了Flink内部各组件如何协同工作,将用户代码最终转化为分布式环境中的实际执行任务。通过源码级分析,展现了Flink在Kubernetes环境下的自动化部署机制和资源管理策略,为理解Flink的分布式执行原理提供了清晰的
Flink调度机制将作业逻辑蓝图转化为物理执行,过程涉及四层图转换:StreamGraph定义逻辑流向,JobGraph合并算子链,ExecutionGraph展开并行子任务,PhysicalGraph在TaskManager上实际运行。JobMaster驱动调度,通过DefaultScheduler协调资源分配和任务部署,采用PipelinedRegion策略实现局部故障恢复。
本文详细介绍了Flink的容错机制,重点解析了Checkpoint、StateBackend和Savepoint三大核心组件。深入剖析了Checkpoint的触发和执行流程,包括Barrier机制、状态快照和故障恢复等关键环节,并对比了Checkpoint与Savepoint的异同。最后总结了Flink通过这套机制确保数据流处理的稳定性和一致性,实现"故障自愈"和"运维灵活"的双重目标。

本文深入解析了Flink的执行模型,重点探讨了StreamTask作为最小执行单元的工作原理。文章首先说明理解执行模型的必要性,然后详细介绍了算子链(OperatorChain)的形成机制及其性能优势。接着剖析了StreamTask的生命周期,包括初始化、运行和终止阶段的核心逻辑。文章指出Flink通过多Task实例水平扩展并发度,同时保持单线程确定性执行的独特设计哲学,为后续分析Shuffle机

Flink的Shuffle机制是分布式流计算的核心,通过ResultPartition、InputGate和Netty组件实现跨节点数据传输。上游Task通过ResultPartition将数据打包缓存,下游Task通过InputGate主动拉取数据,采用信用机制控制流量防止堆积。Shuffle模式分为批处理Blocking和流式Pipelined两种,默认使用信用驱动实现背压控制。整个流程从Ta
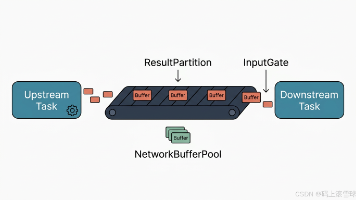
背压是 Flink 流处理中保障稳定运行的重要机制。当下游处理速度低于上游生产速度时,压力会沿链路向上传导,迫使上游减速。其本质通常是网络缓冲区不足,导致数据发送受阻。Flink 通过 Credit-Based 流控机制,由下游反馈可用容量,控制上游发送速率,避免内存堆积和链路失控。背压常表现为吞吐下降、延迟升高、Checkpoint 变慢等问题,可通过 Web UI 的 BackPressure
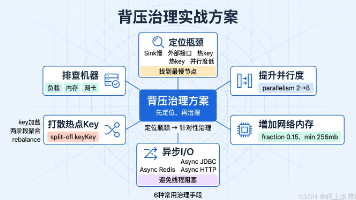
Flink内存机制深度解析与调优指南 Flink性能问题的根源往往在于内存配置不当而非资源不足。本文剖析了Flink1.20的内存模型架构,重点讲解了TaskManager内存的精细划分:包括框架堆内存、任务堆内存、托管内存、网络内存等核心区域。

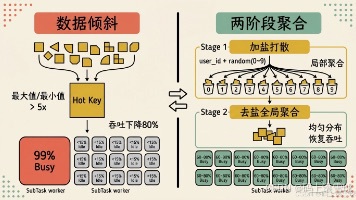
基于真实生产案例,总结Flink性能调优的核心方法论。关键点在于:1)调优不是盲目增加资源,而是通过监控数据找到系统瓶颈;2)常见问题包括数据倾斜、背压传导、Checkpoint超时等,需要针对性解决而非简单调参;3)建立系统化的排查流程,包括监控基线分析、算子级问题定位、参数渐进调整等。文章通过多个典型案例(如热Key导致Sink阻塞、状态膨胀引发Checkpoint失败等),详细演示了从问题发
AI领域的发展速度远超大多数人的学习节奏,很多资深开发者也对AI的核心概念一知半解。这篇文章不聊代码实现、不推导数学公式,而是用工程思维+生活化比喻,帮你把AI、机器学习、深度学习、大语言模型这些概念的关系彻底理清楚。