- @qq_43510916


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
Sink Processors类型包括这三种:Default Sink Processor、Load balancing Sink Processor和Failover Sink Processor。Default Sink Processor是默认的,不用配置Sink group,就是咱们现在使用的这种最普通的形式,一个Channel后面接一个Sink的形式;
题目小明想找到两个正整数 X 和 Y,满足• 2019 < X < Y;• 2019 2 , X 2 , Y 2 组成等差数列。请你求出在所有可能的解中,X + Y 的最小值是多少?Process直接暴力求解即可,也可以直接一层for循环,因为是等差数列嘛,只需要知道公差就可以知道第三个数字啦~Code#include<bits/stdc++.h>//Ausing name
状态转移方程更新的过程简单来说就是:在每次加入新像素点的时候从后往前去试,把新像素和前几个像素放在一起可以使总体的存储位数最少。,表示像素点i的灰度值。状态转移方程的含义是后k个像素点为一组,这k个像素点都按照最多存储长度来算,也就是。除去这k个像素点以外,前面的划分由于其满足最优子结构,还按照原本的来,即。由于多分了一组,新的组需要附加像素点数目l[i]的8位和最大像素存储长度。中,有I[i]个

基于预训练和微调范式的代码生成模型在学术界和工业界都有越来越多的尝试,形成了著名的工业模型,如 Codex、CodeGen 和 PanGu-Coder。为了评估这些模型的有效性,提出了多个现有基准(如 HumanEval 和 AiXBench),其中只包括生成独立函数的情况,即只能调用或访问内置函数和标准库的函数。
若不在,则填充一个特殊方格,将其改变成一个更小的特殊棋盘(子问题),依次递归解决。按照这样来算,对于当前的整个棋盘的四部分来说,有特殊方格那部分不用覆盖,而其余三部分都新增了一个特殊方格,恰好凑成一个L型骨牌,递归直到当前棋盘只有一个方格为止。棋盘覆盖:用4种不同形态(方向不同)的L型骨牌覆盖一个给定的特殊棋盘(即特殊方格的位置已经确定了)上除特殊方格外的所有方格,且任何两个L型骨牌不得重复覆盖。
1.在Chrome浏览器中点击右键选择“检查”命令;2.打开后选择Network;3.按下ctrl+r,在其中找到需要请求的网站,单击后选择Headers;4.得到请求头信息为:Host: www.baidu.comReferer: https://www.baidu.com/?tn=98012088_2_dg&ch=7User-Agent: Mozilla/5.0 (Win...
迪杰斯特拉算法过程维护两个集合S和U,S集合包含已求出的最短路径的点(以及相应的最短长度),U集合包含未求出最短路径的点。由下图可以看出迪杰斯特拉算法实际上就是不断贪心地选择与起点距离最近的点,并将其从U集合中取出加入到S集合中,这个过程不断迭代,直到所有的点都被加入S。给定一个n个点m条边的有向图,图中可能存在重边和自环,所有边权均为非负值。请你求出s号点到每个点的最短距离。
每一个方恪表示迷宫中的一个房间。罗密欧位于迷宫的(p,q)方格中,他必须找出一条通向朱丽叶所在的(r,s)格的路,在朱丽叶方格之前,他必须走遍所有未封闭的房间各一次,而且要使到达朱丽叶方格的转弯次数为最少。将计算出的罗密欧通向朱丽叶的最少转弯次数和有多少条不同的最少转弯道路。第一行有3个正整数n,m,k,分别表示迷宫的行数,列数和封闭的房间数。接下来的k行中,每行2个正整数,表示被封闭的房间所在的
在博客【Hadoop】MapReduce原理剖析(Map,Shuffle,Reduce三阶段)中已经分析了MapReduce的运行过程,以及部分原理。那么这篇博客则是进行一次实践,使用MapReduce统计文本中的单词数量。实际上我们只需要写Mapper和Reducer部分的代码即可,最后在Main中进行一些设置即可。
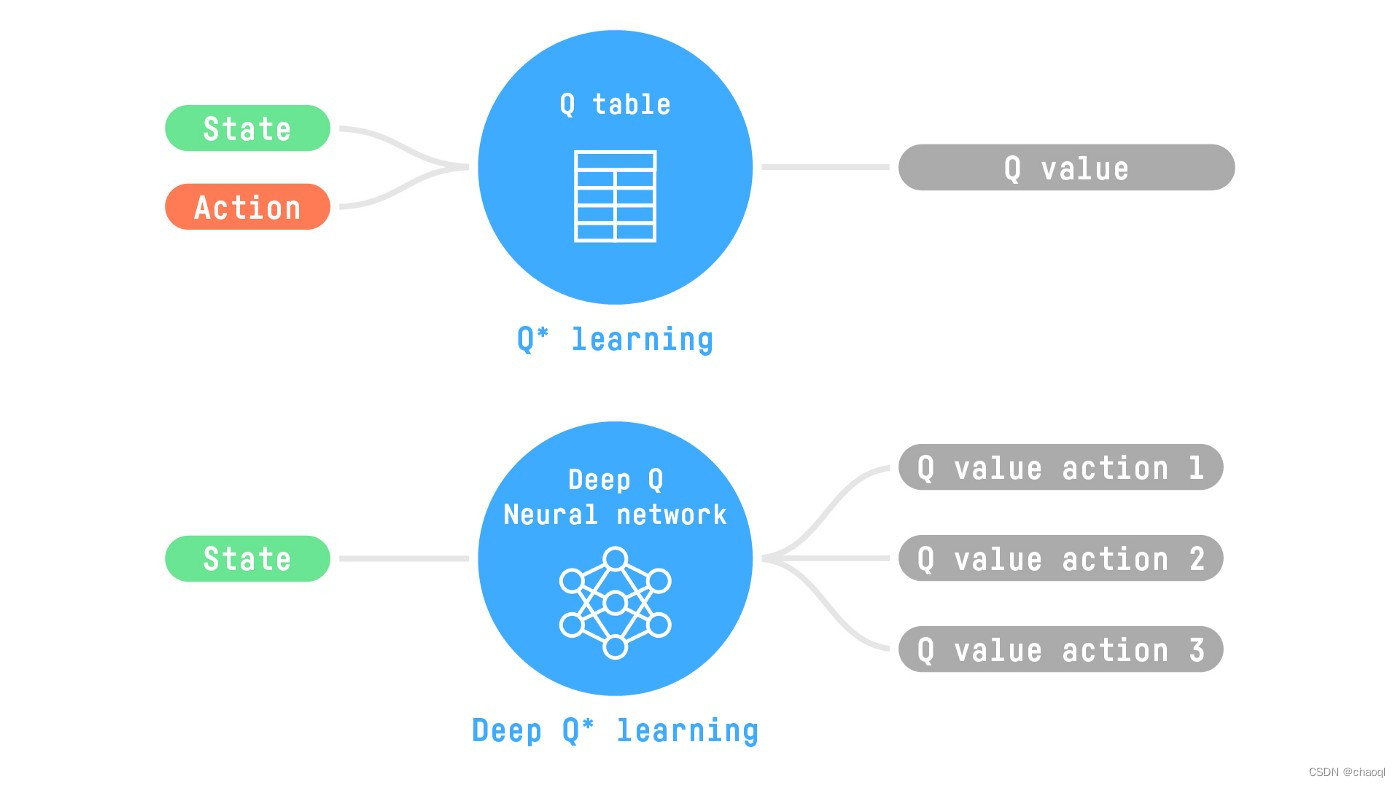
由Experience Replay返回当前状态作为Q网络输入,Q网络使用随机初始化后的参数得到当前状态下可以采用的所有动作所对应的Q值,并按照ε-greedy策略选择要执行的动作输出给Experience Replay,其得到动作后与环境进行交互并得到下一状态以及奖励,并将这一系列数据作为训练数据与第一步产生的部分数据进行存储。在已存储数据中随机选择一批训练数据(S1,a4, R1, S2),将