- @qq_41739364


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
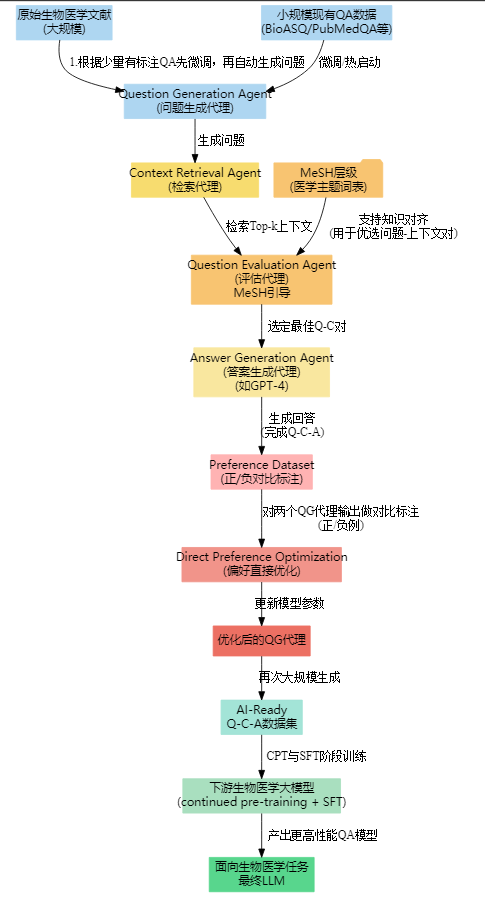
答10论文实验证明,用 m-KAILIN 生成的数据给生物医学大模型做连续预训练 (CPT) 或监督微调 (SFT),模型在各种医学 QA 任务上精度显著提升。甚至在一些场景下,小参数模型也能和更大规模的商用模型接近或超越。总结m-KAILIN 的核心思路把海量医学文献先“提取+转换”成问答格式再用先进 LLM 去“填”答案,最终持续迭代生成一个规模庞大、质量高的生物医学问答训练集。通过多智能体协
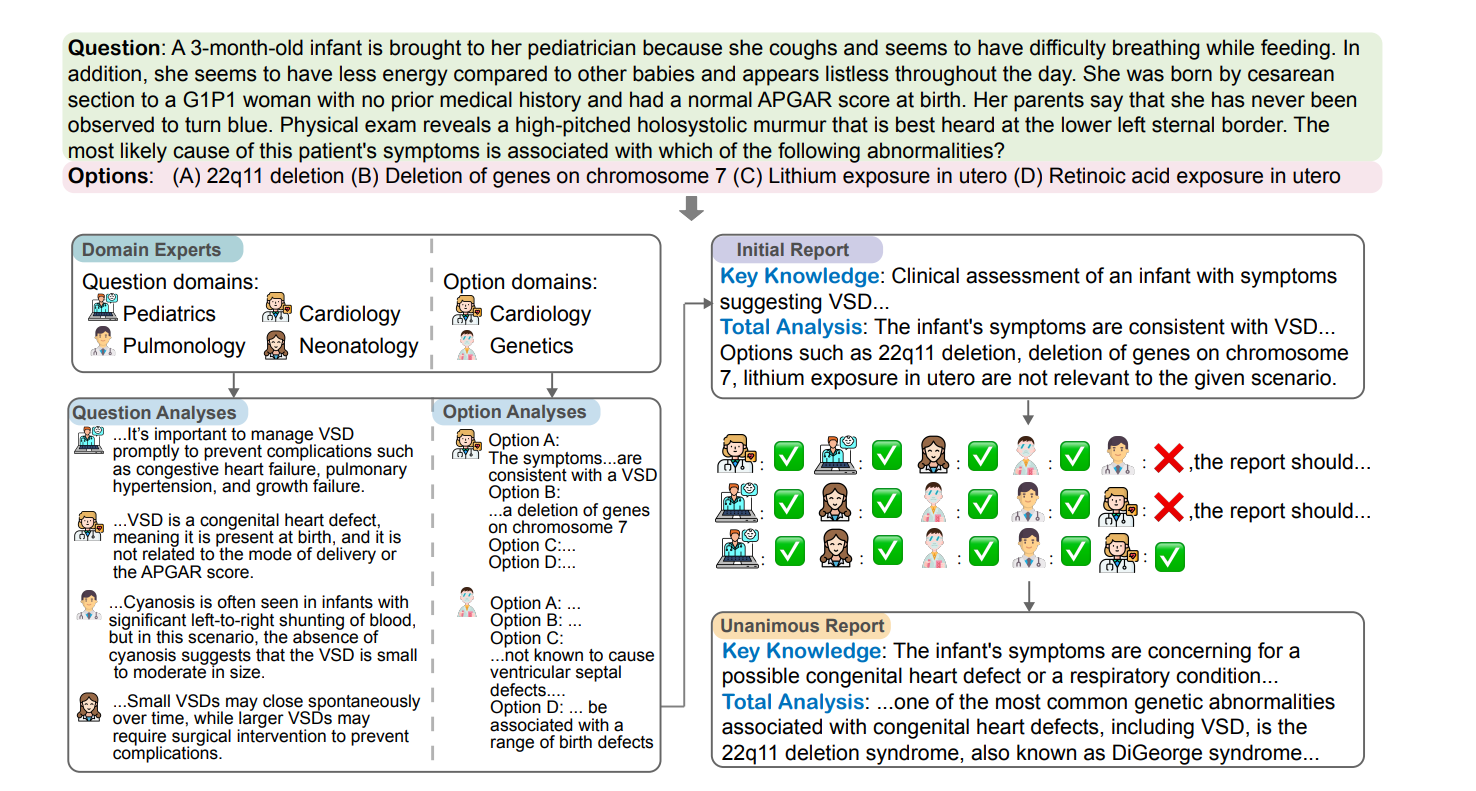
论文:MEDAGENTS: Large Language Models as Collaborators for Zero-shot Medical Reasoning代码:https://github.com/gersteinlab/MedAgents类比理解:就像真实医院中的多学科会诊——不同专科医生从各自专业角度提供意见,最后达成共识诊断方案。MEDAGENTS模拟了这个过程。主要步骤:1)
第一步:我听到什么?内容概述:ArgMed-Agents是一个多代理框架,结合了大型语言模型(LLMs)来提供解释性的临床决策支持。系统通过模拟临床讨论的形式,整合生成器、验证器和推理器这三种角色,不断迭代,以形成合理且连贯的治疗建议。功能复述:ArgMed-Agents通过对临床情境的深入分析,生成关于患者治疗的多种建议,这些建议经过验证和推理过程的筛选,最终提供最合适的治疗方案。第二步:我想到

【代码】AI + 渗透测试思路关联分析。
数据探索阶段流程:读取 → 匹配 → 可视化数据准备阶段流程:读取 → 复制整理 → 保存重组 → 张量转换 → 可视化 → 导出结果↓ ↓ ↓ ↓ ↓(备份) (标准化) (深度学习) (验证) (持久化)
问55:D3是什么意思?答55:3D的意思,表示三维U-Net。问56:为什么继承Dataset?答56:PyTorch要求,实现和__len__接口。问57:transformer是什么?答57:图像变换操作,如缩放、裁剪。])问79:Compose是什么?答79:组合多个变换,按顺序执行。问80:为什么缩放到96×96?答80:原始512×512太大,3D卷积内存消耗巨大。问81:96这个数字
上表主要聚焦中文数据集(和少量混合),其中个别英文数据集或多语数据集也附在最后以便参考。更多“英文”数据集将在后文的**“1.2 英文/多语言数据集”**或“其他附录”中进一步列出。当前出现了大量专注“图像+文本多模态”的医疗模型与评测,主要解决放射学影像、内窥镜图像、病理图像等结合文字报告的多模态理解、问答和生成。的医疗/生物医学相关数据集,涵盖问答、对话、知识图谱、文本抽取等任务。除上述大语言
在 Cursor 中找到 Fearures 打开 composer(允许用户通过自然语言命令,进行多文件编辑和代码生成)。现在写代码方面 Cursor 和 Claude 3.5 结合,不需要编程技能就能编程,太好用了!就在 Cursor 中运行,出了问题,一直丢报错信息、你的预期和现状,最终就能完成了。在 Cursor 找到 AI 聊天界面,把需求给 TA,代码是 python。然后点击这个插件,

LangGraph 下一代 公司:开发多智能体员工,打造 1 人 超级 AI 公司
共享表征学习梯度平衡策略任务相关性验证性能监控和调整。