- @qq_26645205


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
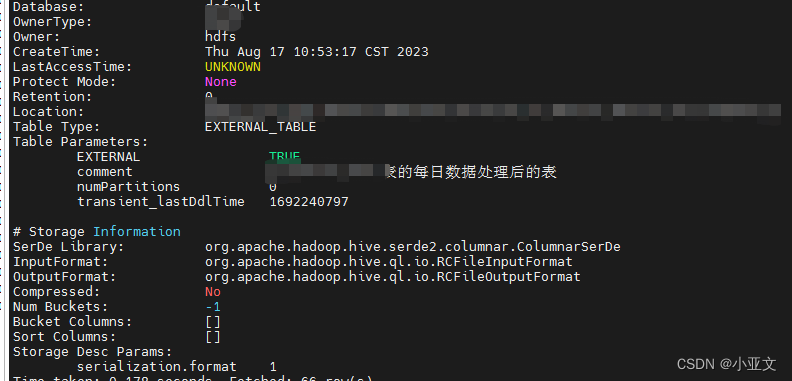
增加之后的注释,会在元数据库(一般在MySQL 中的 hive 库)中的 TABLE_PARAMS 表中显示,该表存储 表/视图 的属性信息。注意:comment一定要是小写的,不能是COMMENT,且必须要加单引号!4.字段名修改添加注释。
解决办法:目录:data-integration\system\karaf\etc\config.properties文件中下部有一行 org.osgi.framework.bootdelegation=(一堆参数)在末尾处加上,javax.crypto,javax.crypto.*Mongo就可以正常连接读取数据了。
import pandas as pdfileTest ='chapter9/test.xls'dataT =pd.read_excel(fileTest,encoding='utf-8') #读取数据,指定编码#将I II III IV V VI 转换为数字dataT.loc[(dataT[u'空气等级']=='I'),u'空气等级']=1dataT.loc[(dataT[u'空...
数据模型构建抽取80%作为训练样本,剩下20%作为测试样本此案例是《python数据分析与数据挖掘》的第九章,在p200我们可以看到特征的取值范围都在0~1之间,换句话说,如果我们直接输入SVM模型的话,彼此之间的区分度会比较小,因此我们需要做一个放大处理,当然放大系数K不能过大或者过小,经反复试验,我们发现30时,效果比较好。代码如下:import pandas as pd...
Boltzmann 机也称为模拟退火算法,它是一种无监督网络。该算法和BP算法都是神经网络家族中的核心算法,这两个算法构成了后来深度学习算法的框架基础。该网络最早来源于对退火过程的一种模拟,使用了著名的玻尔兹曼能量函数,因此而得名。该网络的优势在于能够跳出函数的局部最小值,如果迭代次数足够,即可找到函数的近似最大值。它常用于求解路径最优的函数算法,目前应用仍很广泛。
import pandas as pdfileTest ='chapter9/test.xls'dataT =pd.read_excel(fileTest,encoding='utf-8') #读取数据,指定编码#将I II III IV V VI 转换为数字dataT.loc[(dataT[u'空气等级']=='I'),u'空气等级']=1dataT.loc[(dataT[u'空...
数据模型构建抽取80%作为训练样本,剩下20%作为测试样本此案例是《python数据分析与数据挖掘》的第九章,在p200我们可以看到特征的取值范围都在0~1之间,换句话说,如果我们直接输入SVM模型的话,彼此之间的区分度会比较小,因此我们需要做一个放大处理,当然放大系数K不能过大或者过小,经反复试验,我们发现30时,效果比较好。代码如下:import pandas as pd...
解决方案:删除该nodemanager所在机器的 /var/lib/hadoop-yarn/yarn-nm-recovery/yarn-nm-state 文件夹下的全部信息。

定义自组织特征映射神经网络(Self-Organizing Feature Map,也称Kohomen映射),简称为SOM网络,主要用于解决模式识别类的问题。SOM网络属于无监督学习算法,与Kmeans算法相似。所不同的是,SOM网络不需要预先提供聚类数量,类别的数据由网络自动识别出来。它的基本思想是:将距离小的个体集合划分为同一类别,而将距离大的个体集合划分为不同的类别。2.
1.进入hue,首先创建一个shell脚本,点击hdfs进入文件目录。2.然后进入editor 你想要的脚本,比如一个shell脚本。3.进入Scheduler中的workflow。点击右边new,创建文件夹或者文件。点击下方红框按钮可以直接运行。选择文件,右边出现文件浏览。