- @qq_16763983


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
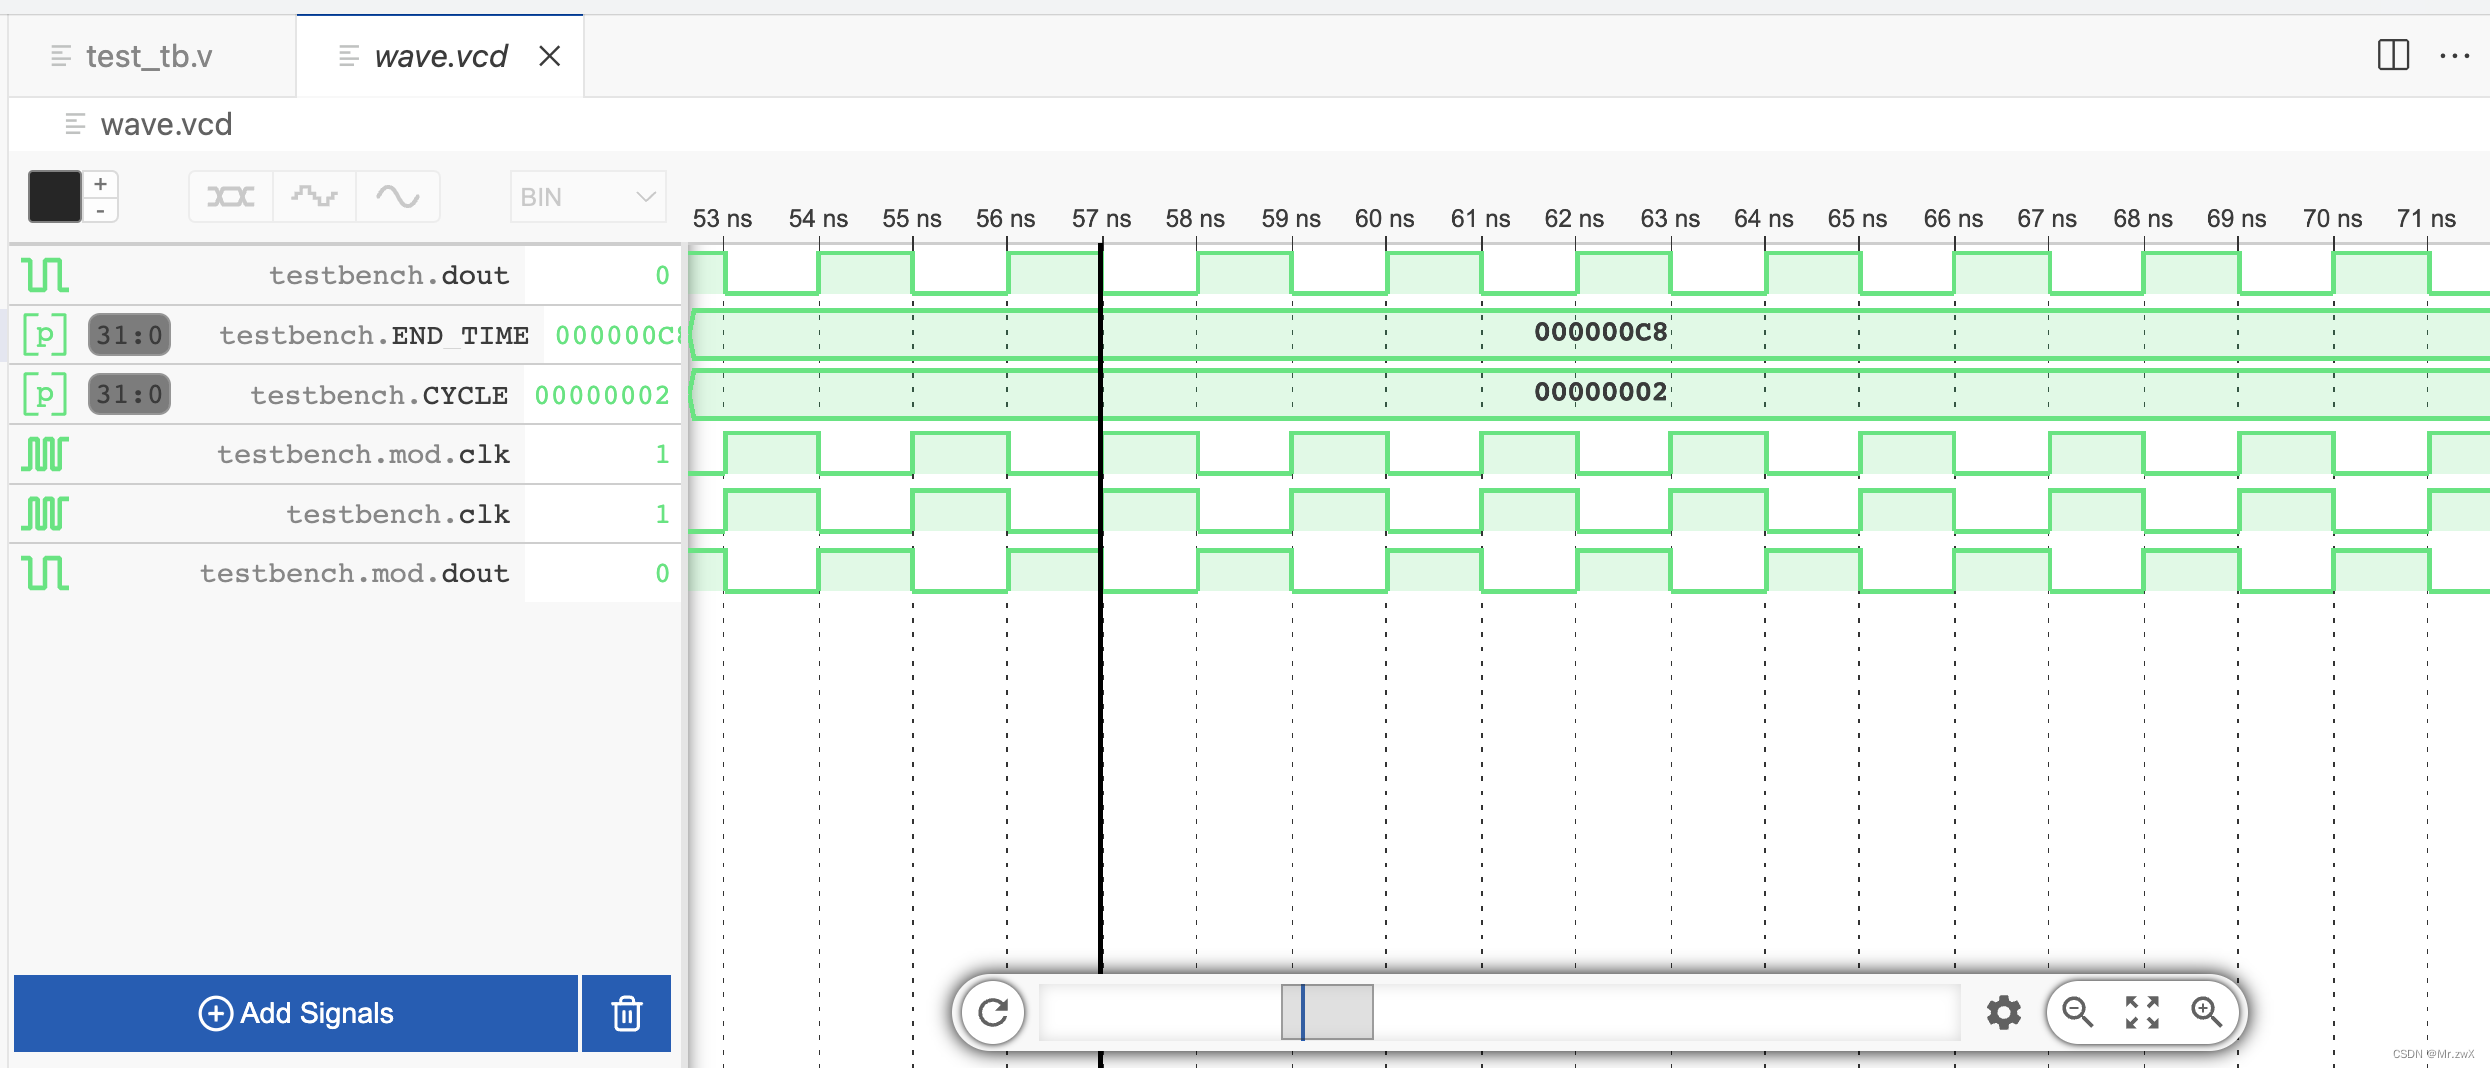
MacBook使用iverilog进行数字电路仿真
1、删除指定范围内结点题目:已知线性表中的元素(整数)以值递增有序排列,并以单链表作存储结构。试写一高效算法,删除表中所有大于mink且小于maxk的元素(若表中存在这样的元素),分析你的算法的时间复杂度。链表结点定义如下:struct _lnklist{ElemType data;struct _lnklist *next;};typedef struct _lnklist Node;typed
Paper: SIRNN: A Math Library for Secure RNN InferenceCode: https://github.com/mpc-msri/EzPC.2PC在整数上运算比在浮点数上运算更高效,在定点运算数中,⌊r2s⌋mod2l\lfloor r2^s\rfloor mod 2^l⌊r2s⌋mod2l,其中lll就是bitwidth,sss是scale。安全参数:
一、前言如果有人问,数学建模带给我的是什么?我想说:数学建模带给我的是一种奇妙的归属感,数学建模让我心智迅速成长,数学建模向我指明数学在应用领域的方向。从第一次参加2019年底电子科大举办的数学建模美赛模拟以来,还参加了接下来2020年5月的校级正式赛和2020年底的美赛模拟赛。在这三次比赛中,均有获奖,有拿过最高奖项,也有拿过次高奖项。虽然我承认,参加的三次比赛都仅仅是校级比赛层面,可能没有省级
1 配置好Python环境这个默认是已经配置好了,也能在编辑器正常编译运行Python程序。同时,也能正常使用pip包管理工具进行第三方库的下载安装。或者,根据自己的环境需要,能进入到自己的Python虚拟环境下工作,命令:activate env_name。如上均是下载安装whl文件的前提条件,这里不会展开说明…2 安装wheelpip install wheel3 下载whl轮子文件(重点是如
文章目录一、算法介绍二、距离度量三、K值的选择四、算法流程一、算法介绍KNN(K Near Neighbor):k个最近的邻居,即每个样本都可以用它最接近的k个邻居来代表。KNN算法属于监督学习方式的分类算法,我的理解就是计算某给点到每个点的距离作为相似度的反馈。简单来讲,KNN就是“近朱者赤,近墨者黑”的一种分类算法。要区分一下聚类(如Kmeans等),KNN是监督学习分类,而Kmeans是无监
不能太小,如果他们足够大,那么根据目前的计算机技术和其他工具,至今也没能从。足够大(1024足够),基本上不可能从公钥信息推出私钥信息。最大公因数为1(互质),因此保证step 4生成解密密钥。首先选取两个互为质数的数。也就是说,只要密钥长度。根据欧拉函数,不大于。
本文介绍了DeepSeek的稀疏注意力机制DSA,包含Lighting Indexer和Token Selection两个模块。DSA采用FP8低精度计算、ReLU激活和更少头数来降低复杂度,并通过top-k选择重要token。训练分为两步:CPT阶段先预热Indexer使其接近原始attention分布,再训练模型适应稀疏模式;后训练阶段结合专家蒸馏和混合RL训练(GRPO算法),融合推理、工具
DeepSeek推出创新多模态模型DeepSeek-OCR,通过将文本视为图像模态处理,有效解决长文本推理难题。该模型采用双模块架构:DeepEncoder(380M参数)负责视觉特征提取,DeepSeek-3B-MoE解码器(激活570M参数)实现多模态生成。实验显示,其OCR解码精度在10倍压缩率下达97%,在OmniDocBench测试中超越现有模型。模型还支持图像理解、PDF转换等功能,单
摘要:GPT-OSS模型针对大模型推理中的attention sink问题提出创新解决方案,通过可学习bias项修正注意力机制。该方法在QK计算后添加head-wise的bias token,调整softmax分母,有效规避无效的初始token过度关注现象。同时采用分层混合策略,交替使用全注意力(GQA)和滑动窗口注意力(window=128),在120B大模型中实现高效推理。数学上相当于给注意力