- @oHuangBing


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
通过两种方式获取我们当前的UserAgent,至于那种方式方便,需要我们根据实际情况判断。UserAgent在线查找工具不仅能够获取Useragent,也能够解析Useragent。这两种方法是不是很简单,赶快试试吧!https。...
主要介绍了useragent在线查找工具的具体用法,同时也一个示例看出useragent在线查找工具能够查询出useragent的那些信息,可以帮助我们检查日志中的一些爬虫信息。https。
我们在网站运营的时候,最大的问题就是:我们自己花费几个小时甚至是几天辛辛苦苦创作作的内容,被爬虫只需要 1s 就抓去了。为了保卫我们创作的成果,也为了网站的稳定运行,我们需要对爬虫说:No,我们在反爬虫的过程中最重要的就是如何识别爬虫。为了识别识别爬虫,常用的有以下几个方法:所谓的真人检测也就是出现一个验证码,让你输入验证码的内容,这些验证码对于人类来说很容易识别,但是对于机器来说却很难识别,例如
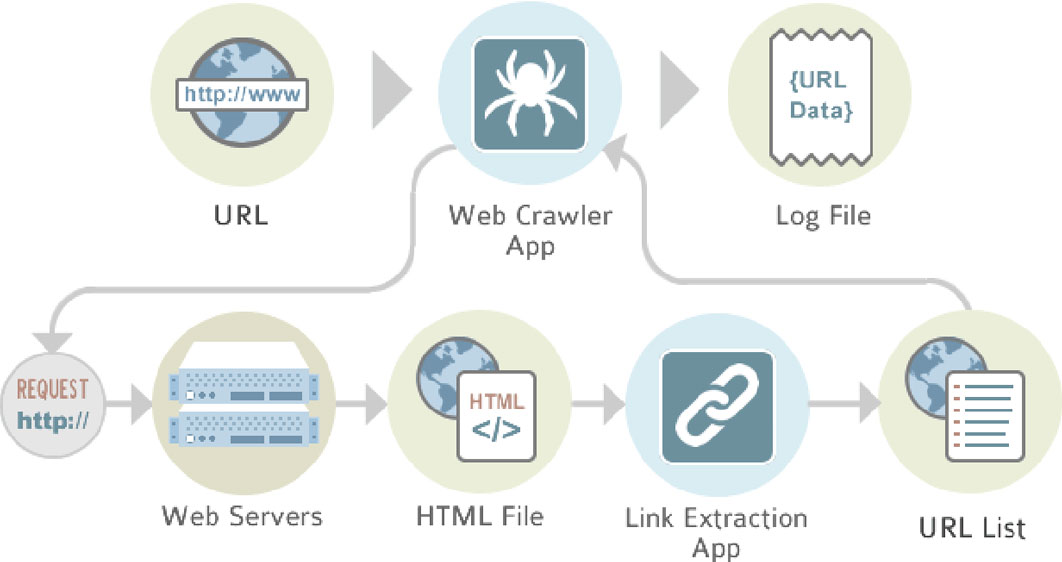
经常有小伙伴需要将互联网上的数据保存的本地,而又不想自己一篇一篇的复制,我们第一个想到的就是爬虫,爬虫可以说是组成了我们精彩的互联网世界。网络搜索引擎和其他一些网站使用网络爬虫或蜘蛛软件来更新他们的网络内容或其他网站的网络内容索引。网络爬虫复制页面以供搜索引擎处理,搜索引擎对下载的页面进行索引,以便用户可以更有效地搜索。这都是爬虫数据采集的功劳。这篇文章我总结了爬虫数据采集的说有流程,从最开始的最
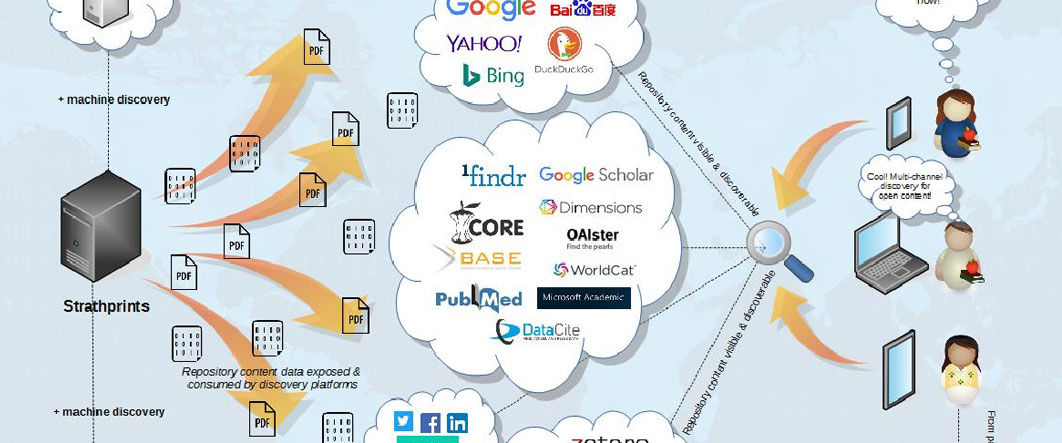
我们常常说 robots.txt 协议防君子不防小人。robots.txt 协议防什么样的君子,又防不了什么样的小人呢?就听我给你一一道来。
上一期我们讲解了使用Python 读取 CSV、PDF、Word 文档相关内容。前面我们已经介绍了网络数据采集的一些基础知识,现在我们将进入高级数据采集部分。到目前为止,我们创建的网络爬虫都不是特别给力,如果网络服务器不能立即提供样式规范的信息,爬虫就不能采集正确的数据。如果爬虫只能采集那些显而易见的信息,不经过处理就存储起来,那么迟早要被登录表单、网页交互以及 Javascript 困住手脚。总
通过 IP 判断爬虫如果你查看服务器日志,看到密密麻麻的 IP 地址,你一眼可以看出来那些 IP 是爬虫,那些 IP 是正常的爬虫,就像这样:在这密密麻麻的日志里面,我们不仅要分辨出真正的爬虫 IP ,同时也要分辨出伪造的爬虫 IP,实属不易。如果查看服务器日志,我们可以先通过 User-agent 大致判断出是爬虫还是正常用户,例如:Mozilla/5.0 (compatible; Semrus
在大数据深入人心的时代,网络数据采集作为网络、数据库与机器学习等领域的交汇点,爬虫技术已经成为满足个性化网络数据需求的最佳实践。而数据采集采集就需要使用到网络爬虫(Web crawler),网络爬虫也会被称为:网络铲(Web scraper,可类比于考古用的洛阳铲)、网络蜘蛛(Web spider),其行为一般是先“爬”到对应的网页上,把需要的的信息“铲”下来。网络搜索引擎和其他一些网站使用网络爬
baidu spider 是百度搜索引擎的爬虫代理。有朋友经常问这个 IP 是不是 baidu spider 的 IP 地址?而对于只有一个 IP 的情况,我们应该如何去判断是不是 baidu spider 的 IP 地址呢?我们可以使用爬虫识别这个工具网站来查询具体的 IP 是 baidu spider 还是假 baidu spider,下面是示例:例如我们查询这个 IP 地址:220.181.