


- @neardi_dev


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
本文解析了NPU算力的核心维度(峰值TOPS、精度INT8/FP16、效率带宽),指出厂商宣传的TOPS值(如RK3588的6TOPS)是理想状态下的理论峰值,实际性能受多重因素制约。通过拆解TOPS计算公式(MAC单元数×频率×操作次数×位宽加速比),揭示了INT8精度下算力显著提升的原理。文章强调,终端AI设备的实际表现不仅取决于TOPS数值,更与模型量化质量、内存带宽、软件优化等密切相关,需
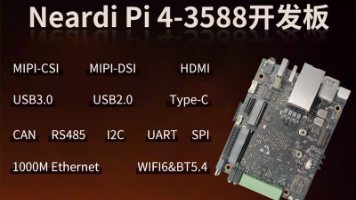
NeardiPi4-3588开发板搭载瑞芯微RK3588芯片,具备8核CPU、6TOPS AI算力和8K编解码能力,支持多屏显示与多路摄像头接入。提供丰富工业接口(双千兆网口、WiFi6、CANFD等)和多种系统支持(Android/Ubuntu等)。适用于AI视觉、工业控制、智慧显示等领域,提供商业级和工业级版本选择,配套完整SDK和技术支持,助力快速产品量产。
边缘AI市场迎来爆发期,国产芯片厂商迎来发展机遇。随着AI算法向本地和边缘设备迁移,智能摄像头、车载终端、工业相机等设备对边缘计算需求激增。当前边缘AI芯片呈现SoC一体化与独立AI加速器两种技术路径,瑞芯微、海思等国产厂商通过差异化布局抢占市场。不同于单纯追求算力提升,边缘AI设备更注重接口适配与场景优化,在安防、车载、工业等领域形成特色解决方案。国产芯片厂商正凭借对细分场景的深度理解,在多媒体

站在十字路口,你只需极短的一瞥,大脑就能瞬间给视野里的东西打上“标签”:那辆红色的巴士正在进站,人行道上的小孩在奔跑,侧方还有外卖车在加速。这种近乎直觉的反应,计算机曾学得极为吃力。直到 YOLO 横空出世。You Only Look Once——在画面捕捉的瞬间,分类与定位同步完成。让目标检测告别了地毯式搜索,像人的直觉一样,真正赋予了机器实时思考的灵魂。

站在十字路口,你只需极短的一瞥,大脑就能瞬间给视野里的东西打上“标签”:那辆红色的巴士正在进站,人行道上的小孩在奔跑,侧方还有外卖车在加速。这种近乎直觉的反应,计算机曾学得极为吃力。直到 YOLO 横空出世。You Only Look Once——在画面捕捉的瞬间,分类与定位同步完成。让目标检测告别了地毯式搜索,像人的直觉一样,真正赋予了机器实时思考的灵魂。
海思Hi3516CV610芯片通过AIISP技术突破传统图像处理瓶颈,实现低照度降噪、120dB动态范围和60fps流畅处理。LCH3516CV610核心模块集成1.0TOPS算力,支持4K超清处理及ViT模型加速,适配OpenHarmony系统。配套LKD3516CV610开发板集成Wi-Fi6和工业接口,提供完整SDK支持快速开发。该方案可应用于智能安防、工业质检、智慧零售等多个领域,显著提升

随着边缘AI设备应用场景的复杂化,单芯片算力瓶颈日益凸显。Rockchip推出的RK1820协处理器与RK3588主控芯片形成协同架构,通过PCIe/USB接口实现高效分工:RK3588负责任务调度与流程管控,RK1820专注20TOPS的AI推理计算。这种"轻管控+重计算"模式在多任务推理、视频分析等场景下实现算力叠加,使系统性能提升30-70%,同时降低主控负载和整机能耗,

本文介绍了一个基于YOLOv11框架的菜品识别项目开发过程。作者在RK3576开发板上实现了对小炒肉、米饭和西红柿炒蛋的精准识别。重点分享了数据采集技巧(避免视频抽帧、保持光线真实、平衡样本量)、标注注意事项(英文命名、精细标注)以及模型训练优化(最终5.5MB模型达到0.964的mAP50-95)。特别说明了如何在RK3576开发板上进行模型转换和部署,包括NPU优化、ONNX导出和RKNN格式

本文对比了GPU与NPU两种处理器的特性与用途。GPU作为通用型处理器,擅长并行计算和图形渲染,广泛应用于游戏、科学计算等领域;而NPU是专为AI推理设计的处理器,通过矩阵乘加阵列和量化技术实现高效低功耗运算,适用于终端设备的实时AI任务。两者在AI生态中分工明确:GPU主导训练与复杂计算,NPU专注边缘推理。现代SoC常同时集成两者,以满足不同场景的计算需求。

边缘AI市场迎来爆发期,国产芯片厂商迎来发展机遇。随着AI算法向本地和边缘设备迁移,智能摄像头、车载终端、工业相机等设备对边缘计算需求激增。当前边缘AI芯片呈现SoC一体化与独立AI加速器两种技术路径,瑞芯微、海思等国产厂商通过差异化布局抢占市场。不同于单纯追求算力提升,边缘AI设备更注重接口适配与场景优化,在安防、车载、工业等领域形成特色解决方案。国产芯片厂商正凭借对细分场景的深度理解,在多媒体