- @m0_73202283


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
后面这项叫作正则化项,可以对需要求出的参数θ的大小进行抑制加入L2正则化项后,线性规划问题的解析解前面不再是X.T与X的乘积,加上λI后,从半正定变成了正定矩阵,从而确保了矩阵有逆我们有时希望得到的模型参数更稀疏,即参数中的数量尽可能多。由于L0范数衡量的是向量中非零元素的个数,因此,我们可以选用L0范数来进行正则化,最小化范数就会使向量中的非零元素尽可能少。然而,L0范数中含有示性函数II,并不
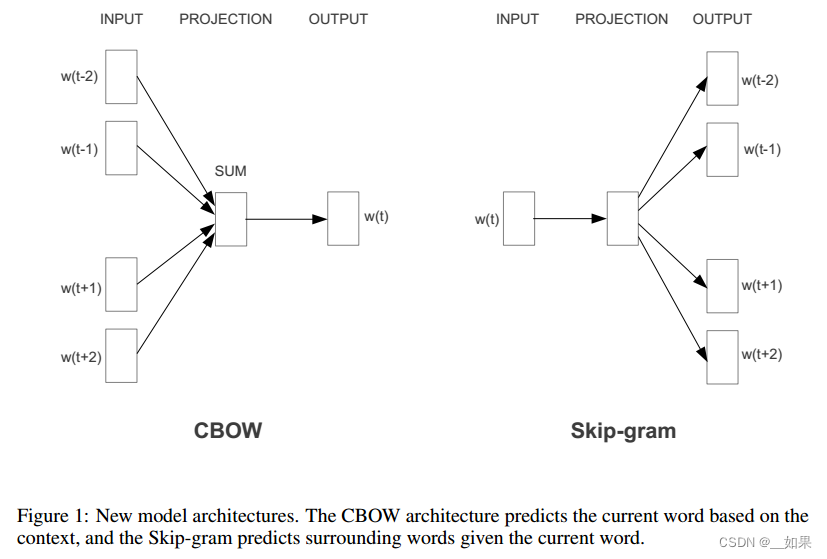
我们提出了两种新的模型架构,用于计算来自非常大的数据集的单词的连续向量表示。在单词相似度任务中测量这些表示的质量,并将结果与先前基于不同类型神经网络的最佳表现技术进行比较。我们观察到在更低的计算成本下,准确率有了很大的提高,即从16亿个单词数据集中学习高质量的单词向量只需要不到一天的时间。此外,我们展示了这些向量在我们的测试集上提供了最先进的性能,用于测量句法和语义单词相似度。生成词向量又快又好。
小白级手把手教程+全代码实战

5.HC:把transformer中的一次残差变成一次四条残差路径,让当前 block 从四条残差路径里按比例读(A),A是由当前四条路径的内容共同决定的,不同的token有不同的A;3.把mixed RL换成OPD,先练很多的领域专家,也就是各领域的teacher,每个专家先 SFT,再 GRPO,最后让这些专家(10个以上)一起对统一模型这个student进行On-Policy Distill
4.Qwen2.5-VL用的是MRoPE,在temporal、horizontal、vertical三维(t、h、v)进行旋转,但把它们分配到连续的 embedding chunks(TTTT HHHH WWWW),会让三个坐标轴覆盖的旋转频率不平衡,可能会出现一个轴可能偏低频,一个轴偏中频,一个轴偏高频,会损伤长视频能力和局部细节能力。因此Interleaved MRoPE把t、h、v交叉着分配
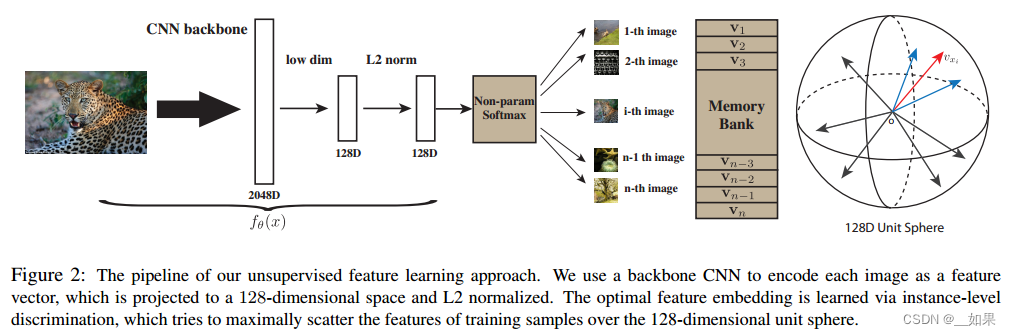
把每个实例(也就是图片)都看作一个类别,目标是学一种特征,从而让我们能把每一个图片都区分开来。
数据:包含 OCR 1.0 数据(多语言 PDF 文档、Word 数据、自然场景 OCR 数据)、OCR 2.0 数据(图表数据、化学公式数据、平面几何数据)、通用视觉数据和 10% 文本数据的混合数据集。(5)模型预训练时学到了先验,或许视觉token的效果不好,但是模型根据部分正确的表征还原了信息,需要破坏视觉输入的文字顺序等方法测试,例如图片从“我喜欢你”->“你欢欢我”(3)确实压缩了to
非书中全部内容,只是写了些自认为有收获的部分。
根据以上定义可知:交叉熵是用来衡量两个分布之间的差异的。a:投票法,f1将w1作为正类,w2、w3作为负类。最小化KL散度其实就是最小化两个分布的交叉熵。区别在于用的损失函数不同,导致模型不同。概率越大,信息量越小,熵越小,编码越短。所以最小化交叉熵就是求对数似然的最大值。而pr(y|x)是one-hot向量。取log是因为要满足自信息的可加性。当p的分布未知时,设q为概率分布。缺点:把文本中的语
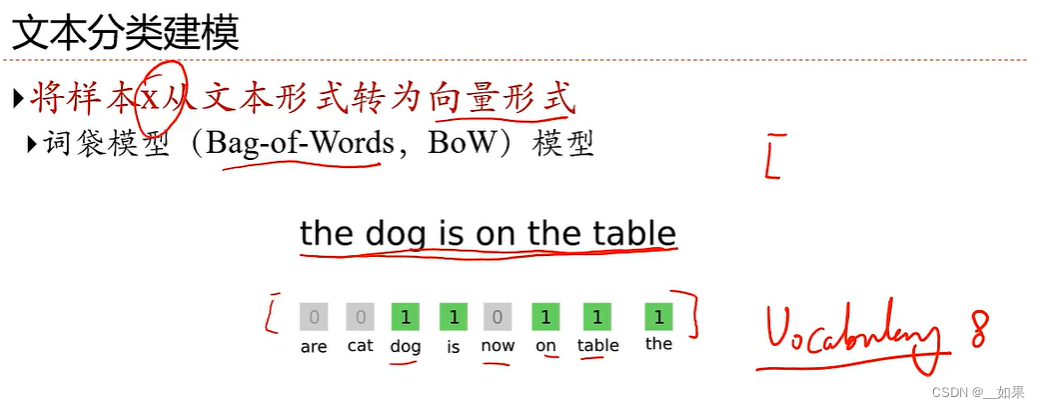
非书中全部内容,只是写了些自认为有收获的部分。