


- @kingdom_java


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
LangChain(87.4k 颗星)AutoGen(27.4k 颗星)ChatDev(24.1k 颗星)SuperAGI(14.8k 星)AutoGPT(163k 颗星)dify(34.1.7k 颗星)BabyAGI(19.5k 星)FastGPT(14.6k 星)Bisheng(7.8k 星)MetaGPT(41k 星)CrewAI(16k 颗星)XAgent(7.8k 星)CAMEL(4.7
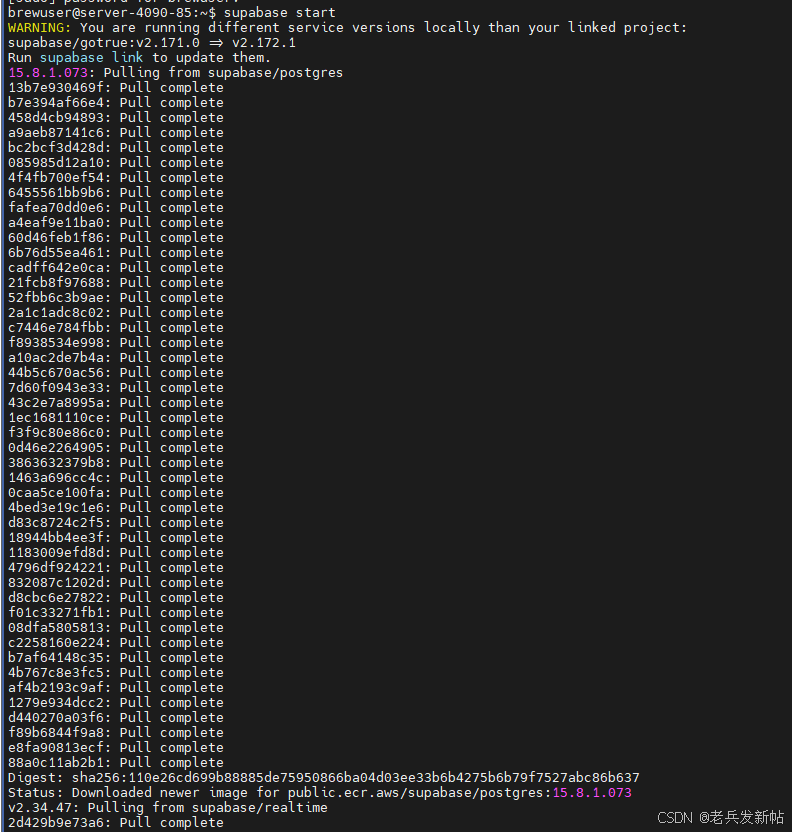
• Supabase 依赖关系:Supabase CLI 在本地启动时会调用 Docker 创建多个容器(如数据库、存储服务),需完整的 Docker 控制权限。• 开发环境隔离:使用 Docker Compose 或 NVM 管理本地环境,避免全局依赖冲突。• Docker 权限模型:Docker 默认通过 Unix 套接字通信,非。• 风险提示:此操作会降低安全性,仅建议临时测试使用。• 权限
https://github.com/x1xhlol/system-prompts-and-models-of-ai-tools#
前几天一直在研究Openmanus,对比而言,Openmanus更像一个只有基础框架的完备度小于10%的产品,Manus在同样的任务上,超出预期,完美的完成任务;

自注意力机制中的分别是和的缩写。它们是理解Transformer模型及其衍生大语言模型(如GPT、BERT等)如何工作的核心概念。为了帮助您快速建立整体认知,下表清晰地展示了它们的分工与合作。
LoRA/QLoRA 正与动态秩调整(DyLoRA)、视觉Transformer适配(ViT-LoRA)等结合,进一步推动高效微调发展。
为了帮助您全面了解当前主流大模型生态,我整理了下面这份详尽的对比分析表。它涵盖了开源与闭源、国内与国外的代表性模型,并从核心原理到实战调参等多个维度进行了梳理。
简单来说,您的理解是。大模型的预训练、SFT(监督微调)、蒸馏以及LoRA微调,其根本的确实都是基于“下一个词的预测”,但它们在上存在关键差异。下面的表格可以帮您快速把握这几种技术的联系与区别。
这样既保证了训练效率,又保证了训练稳定性!
1、本地启动,H100上,速度非常快;4、秦始皇等历史问题能正常回答;2、能进行简单的对话;