


- @junshan2009


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
folium是python的一个用来绘制地图,并在地图上打点,画圈,做颜色标记的工具类。简单易学,和pandas可以很好的融合,是居家必备良品。一 基本功能演示importfoliumimportwebbrowserm=folium.Map(location=[40.009867,116.485994],zoom_start=10) # 绘制地图,确定聚焦点folium.Mar...
为什么要截取90000,因为如果请求超过vllm的max_len 会报错,所以最好限制一下,不要超过vllm起服务时候的最大长度。下载toolkit和 kernels, 我是910b,如果是310请选择对照的版本。安装完了vllm以后呢,torch会被重新装一下,版本可能和你的驱动不搭配。安装完了以后,再安装一下这几个包,推荐使用conda安装。然后vllm-ascend版本和vllm版本要对照。
2)description 很重要,大模型能不能关联到这个工具,以及是否过度关联错误, 都需要这里描述. 主要描述这个工具的功能是什么, 什么查询意图下,调用这个工具,以及工具需要提取的参数什么格式.3)parameters这个是你提取的参数的格式,重点要解释清楚提取什么格式的参数,传入到函数中.这一步是含住的构建函数,也是核心的逻辑处理程序, 主要是接收parameters之后的处理过程,也可以
结果分析:background_color,pure_color的准确率不高,主要是业务方的定义,白色并不是要求纯白色,而是模拟真实拍照场景的白色,有一定的灰度,这个灰度不好控制,模型容易误判。第一步:生成训练数据,我们使用qwen3-vl-235b-a22b-thinking 作为教师模型,进行模型打标。使用ms-swift框架,需要48GB显存,进行full训练,不建议用lora训练。尤其是坐
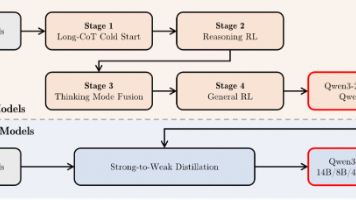
3) Qwen3密集模型的架构类似于Qwen2.5,包括使用Grouped Query Attention(GQA), SwiGLU, Rotary Positional Embeddings(RoPE),和 RMSNorm与预归一化。此外,我们删除了Qwen2中使用的QKV-偏差 ,并将qk-norm引入到注意力机制中,以确保qwen3的稳定训练。Qwen2.5-32B-Base,其激活参数是Q
310p不支持bf16格式,所以加载最新的模型,容易报错。首先获取sudo权限。(本文默认sudo安装)把上面的5个文件都下载完以后。或者按照自己的需求,去安装不同的容器。然后可以docker pull 了。目标驱动CANN 9.0.0。
310p不支持bf16格式,所以加载最新的模型,容易报错。首先获取sudo权限。(本文默认sudo安装)把上面的5个文件都下载完以后。或者按照自己的需求,去安装不同的容器。然后可以docker pull 了。目标驱动CANN 9.0.0。
为什么要截取90000,因为如果请求超过vllm的max_len 会报错,所以最好限制一下,不要超过vllm起服务时候的最大长度。下载toolkit和 kernels, 我是910b,如果是310请选择对照的版本。安装完了vllm以后呢,torch会被重新装一下,版本可能和你的驱动不搭配。安装完了以后,再安装一下这几个包,推荐使用conda安装。然后vllm-ascend版本和vllm版本要对照。
docker run -it-p 8004:8004--name cuda128--gpus all-v /home:/app你的镜像id/bin/bash。你也可以拉取cuda13系列的,都可以的,这里我使用cuda12.8。注意:可能2026年5月的时候vllm 0.22.0可以直接安装支持,不需要nightly版本了。这个可能需要自己装一下cudnn,为什么nvidia的镜像里面没用cudn
接下来我们开始配置vllm服务,注意国内不能直接连接,需要从modelscope上面下载好,模型之后本地加载,我这里使用了deepseek-r1-qwen-7b,你可以换成其他的模型。然后下面的代码,你把模型的路径换成你自己的模型文件路径 注意,windows不支持vllm。对于嵌入生成,我们将使用mxbai-embed-large,这是一个针对语义相似性优化的 334M 参数模型。对于每个文档,