- @jdjhcn


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
在人工智能技术蓬勃发展的今天,深度学习模型(如CNN、Transformer)在人脸识别领域占据主导地位。然而,在计算资源有限或需要快速部署的场景中,经典算法依然展现出独特的价值。LBPH(Local Binary Patterns Histograms) 作为一种基于纹理特征的人脸识别算法,凭借其简洁的原理、高效的实现和对光照变化的鲁棒性,成为传统方法中的代表性技术。LBPH的核心思想源于对图像
目标检测作为计算机视觉的核心任务之一,其算法性能的优化始终是研究热点。YOLO系列模型凭借其高效的实时检测能力广受关注,但传统方法在密集目标检测、多尺度适应性及后处理冗余框抑制等方面仍存在局限。YOLO-v4作为该系列的重要升级版本,融合了多种前沿技术改进,从网络结构设计、特征融合机制到后处理策略均进行了系统性优化。通过引入DIOU-NMS解决重叠框误删问题,采用CSPNet与SPP增强特征表达能
预计要实现的效果:观察下面的文件截图,我们希望将红楼梦每一回的文件内容存在文件中,将文件的“上卷 第一回 甄士隐梦幻识通灵 贾雨村风尘怀闺秀”第几回,这一整行作为文件的名字,每一回作为一个文件,储存到指定的路径下。此处代码为上面的整合,去除了部分注释,可以将其放在一个.py文件中,安装好指定的库即可运行,需要注意文件的路径与你自己的文件路径对应,数据集文件可以到我的数据集中获取(有单独的一篇文章注
人脸关键点定位(Facial Landmark Detection),也称为人脸特征点检测或人脸对齐,是计算机视觉领域的一项基础任务。它的核心目标是在一张包含人脸的图像中,自动地、精确地定位出人脸上一系列预定义的关键解剖点的位置坐标(通常是二维像素坐标)。人脸关键点定位是让计算机“看懂”人脸结构的基础技术。它通过精确定位一系列预定义的面部特征点,为众多上层应用(人脸识别、表情分析、美颜滤镜、AR特
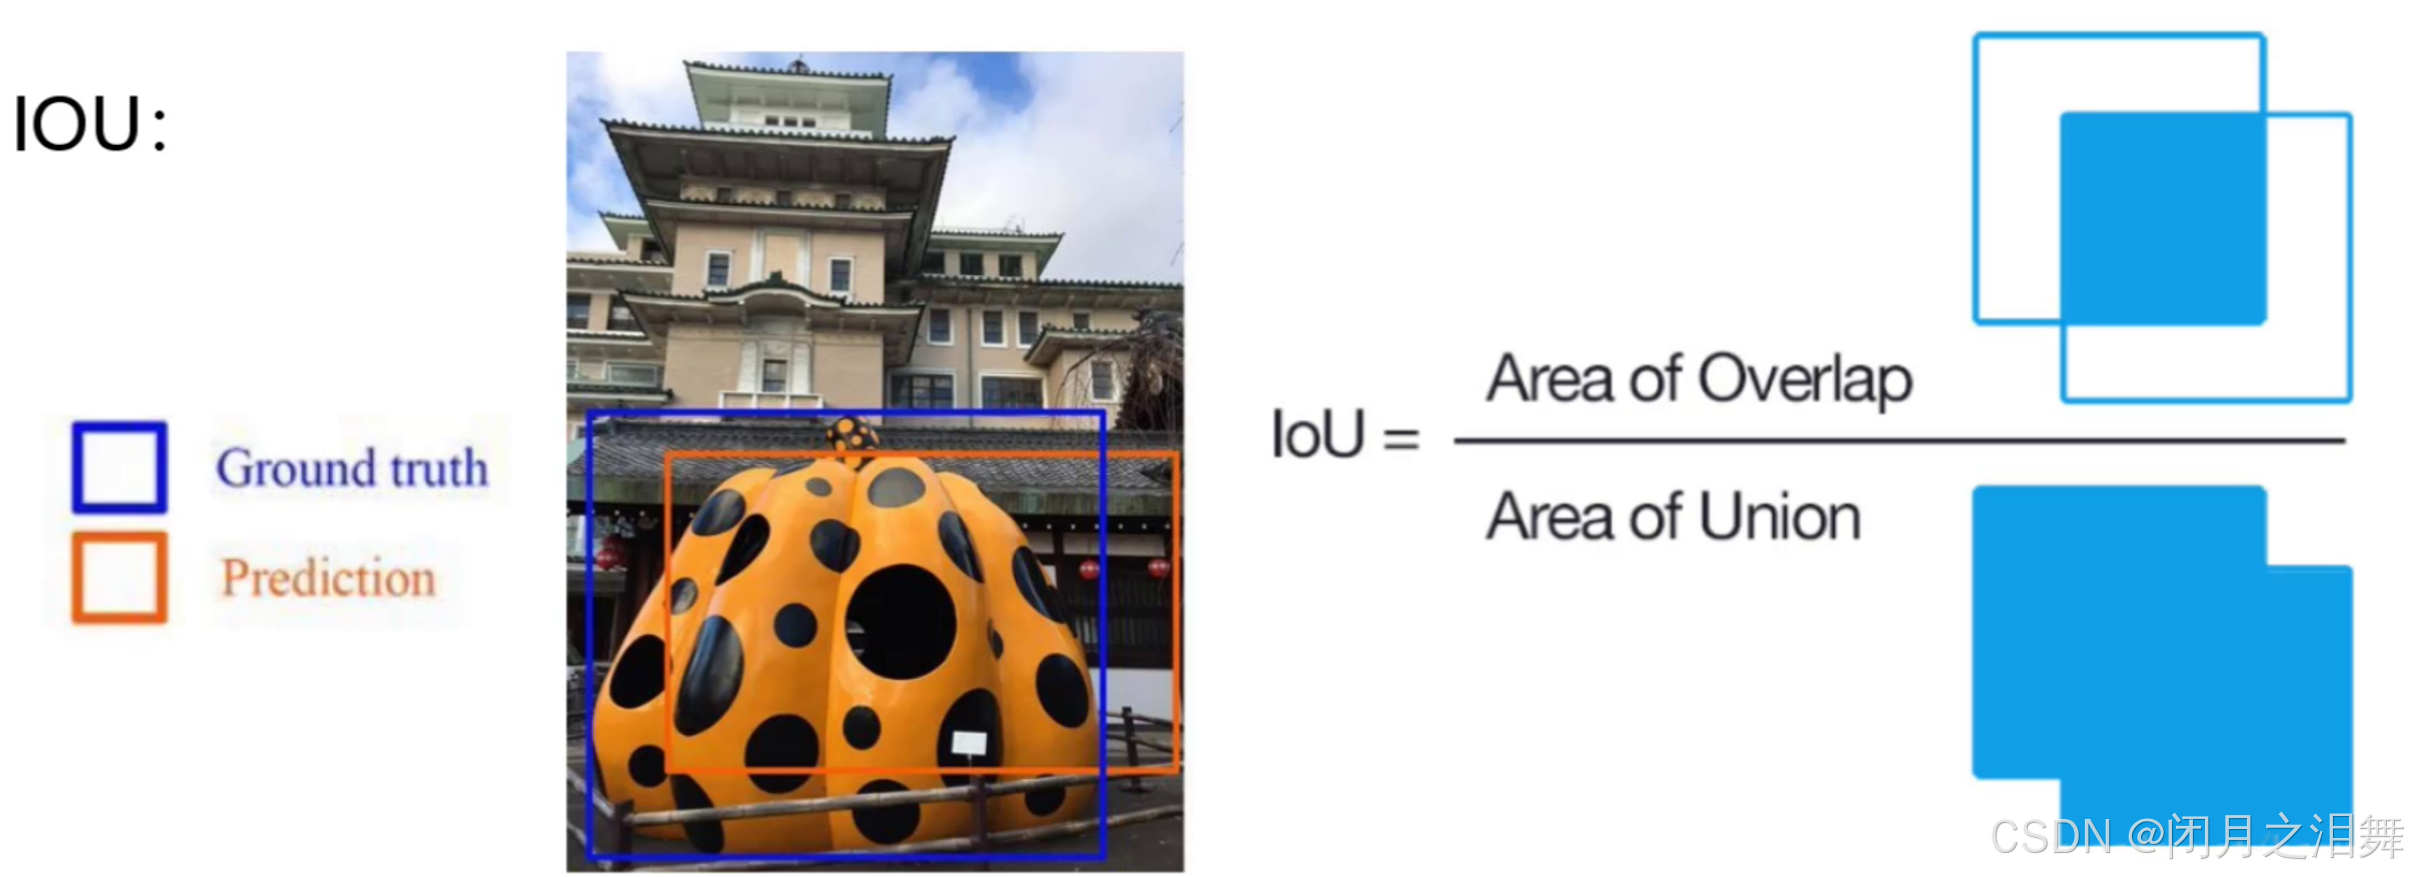
不同类型的模型,评估指标各有侧重。分类模型中,准确率反映预测正确的整体比例;精确率关注预测正例中实际正例的占比;召回率衡量实际正例被正确预测的程度;F1 值综合精确率与召回率,适合样本不均衡场景。回归模型里,均方误差计算预测值与真实值误差平方的均值,能体现平均差异;平均绝对误差以误差绝对值平均,对异常值敏感度低;聚类模型中,轮廓系数综合凝聚度和分离度,值近 1 代表聚类佳。那么我们今天学习的YOL
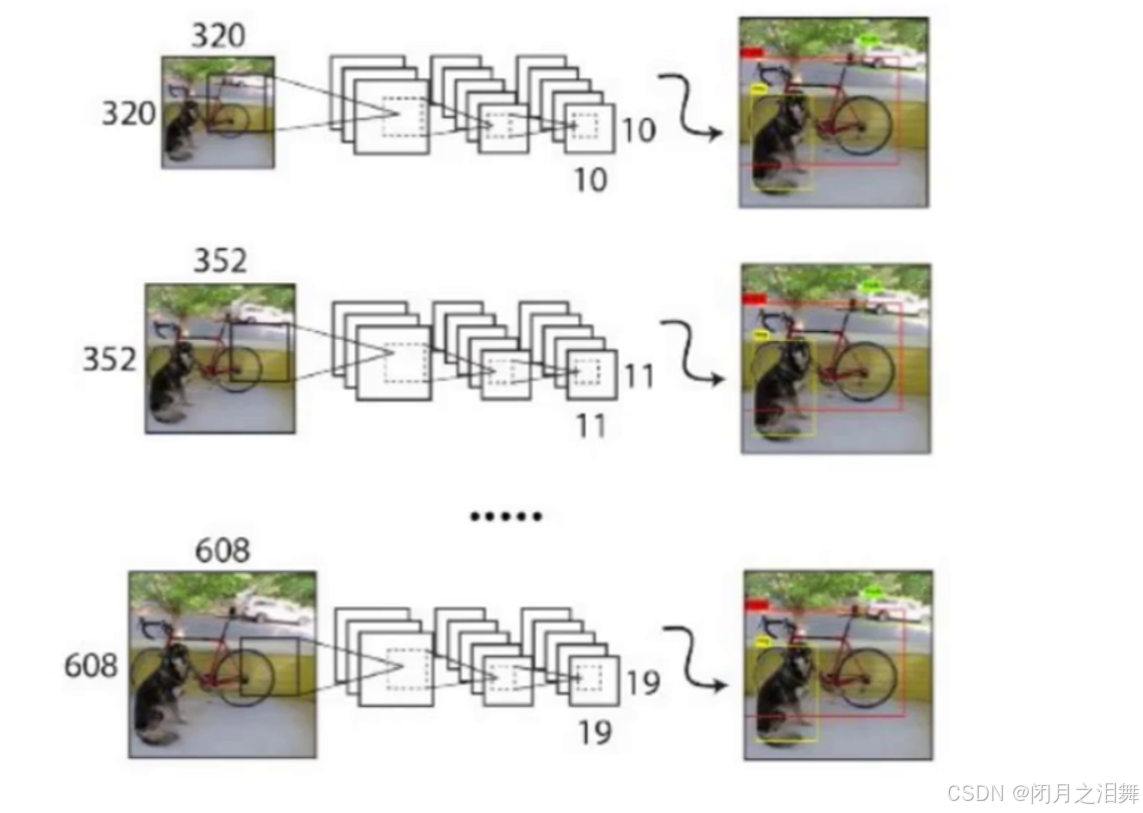
YOLO v2 通过引入锚框、改进网络结构、优化训练策略等方式,在检测精度、速度和泛化能力上都有显著提升,为后续 YOLO 系列(如 YOLO v3、v4、v5)奠定了基础。YOLO v2 相比 YOLO v1 引入了锚框机制(含 K-means 聚类确定锚框尺寸)、批归一化、Darknet-19 全卷积骨干网络、多尺度训练、细粒度特征融合(passthrough 层)、直接位置预测优化训练稳定性
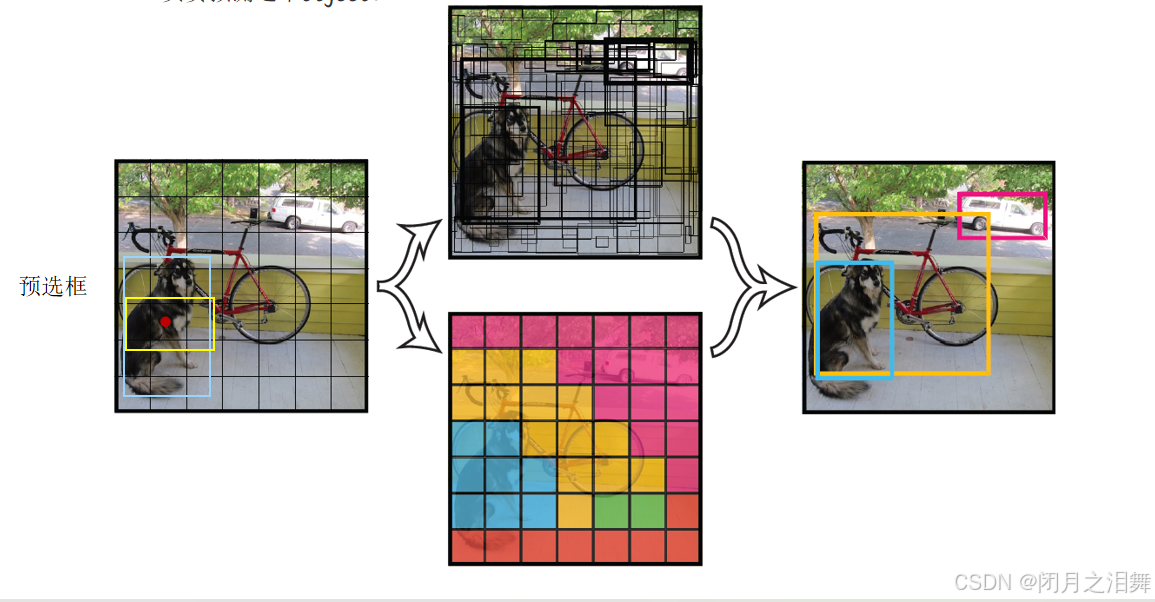
YOLO(You Only Look Once)算法是一种目标检测算法,是经典的one-stage方法。YOLO v1 开创了单阶段目标检测的先河,其简洁的架构和高效的推理为后续版本(YOLOv2-v8)奠定了基础。尽管存在小目标检测和定位精度的局限性,但其“端到端”的设计思想深刻影响了目标检测领域的发展。YOLO-v1通过回归思想革新了目标检测流程,以速度和全局信息优势成为实时检测的里程碑。
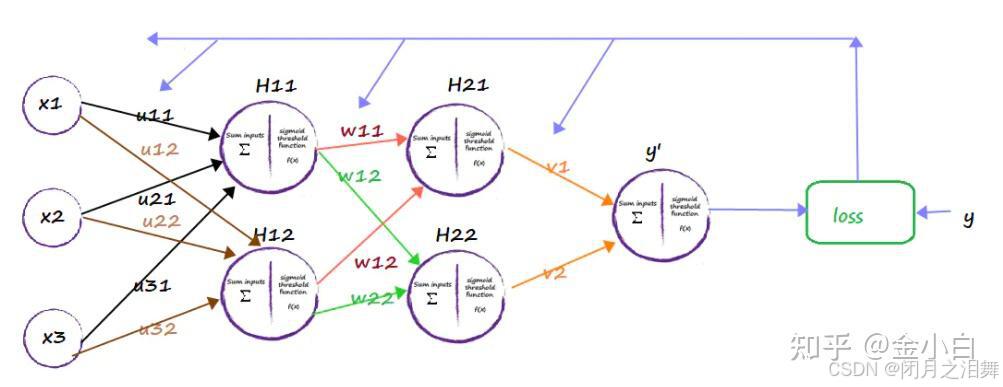
处理非线性问题:通过多层隐藏层和非线性激活函数,BP 网络可拟合任意复杂的非线性映射(万能近似定理)。梯度消失问题:早期 BP 网络使用 Sigmoid/Tanh 激活函数时,深层网络的梯度会随着反向传播逐渐衰减,导致底层参数更新缓慢(可通过 ReLU 激活函数、批量归一化、残差连接等缓解)。监督学习:需标注数据训练,依赖损失函数的梯度计算。
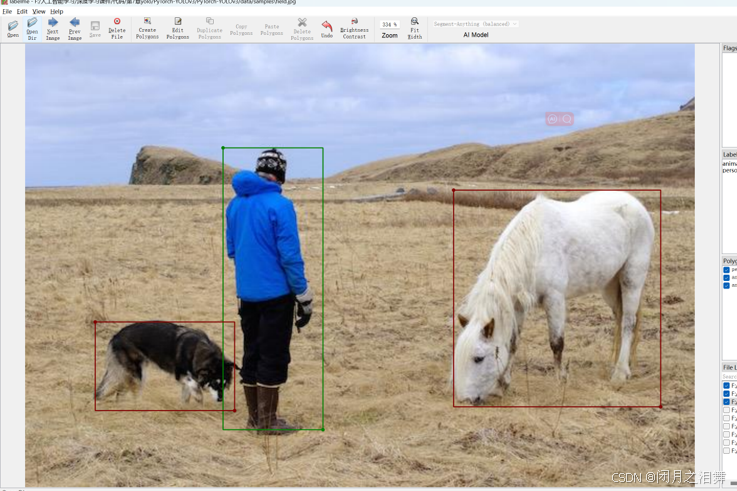
在YOLO等目标检测模型中,对图片进行打标的核心目的是为监督学习提供训练数据,通过标注目标物体的边界框和类别标签,使模型能够学习识别和定位目标的规律。打标数据为模型训练提供监督信号,通过对比预测结果与真实标注值,计算定位损失、分类损失和置信度损失,驱动模型参数优化;同时,标注数据也是评估模型性能(如mAP、精度、召回率)的基础,确保模型在多样场景(如多尺度目标、遮挡、复杂背景)中具备泛化能力。此外
人脸识别作为生物特征识别技术的重要分支,凭借其非接触性与便捷性,广泛应用于安防、金融等领域。传统方法依赖几何特征或局部纹理分析,但对光照、姿态变化敏感,泛化能力受限。1991年Turk与Pentland提出的EigenFace算法,开创性地将主成分分析(PCA)应用于人脸识别,通过构建低维“特征脸”空间实现高维人脸数据的高效表征,为统计学习方法奠定了基石。尽管深度学习已在识别精度上实现突破,但Ei