- @daihaoguang


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
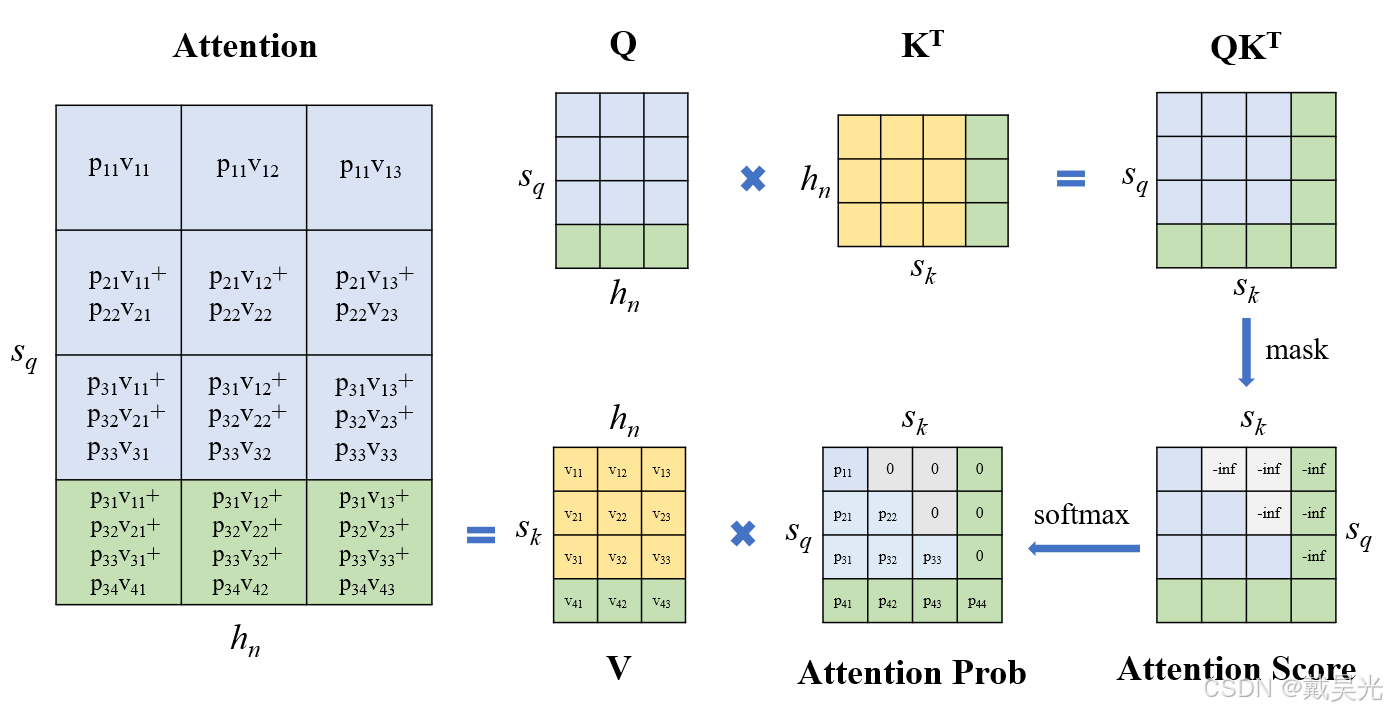
KV Cache是一种为大模型量身定制的推理加速技术。为什么?因为大模型推理的逻辑是:根据当前轮输入tokens预测并输出下一个token,这两者拼接就得到了下一轮的输入,每一轮只比上一轮增加了一个token。这意味着当前轮包含了上一轮的部分计算。上一轮中每一层的key和value被当前轮复用,而不是重新计算,就能加速推理过程,这就是KV Cache的作用。随着KV Cache的广泛使用,大模型的
项目要求实现web端的人脸比对,即对比两张图片中的人脸是否为同一个人。此问题可以通过人脸识别相关模型来实现,比如经典的FaceNet。然而,图片中通常不止包含人脸,为了更好的提取人脸嵌入向量,就需要先借助人脸检测算法(如RetinaFaceMTCNN)抠出人脸部分;其次,实践发现人脸倾斜对最终的效果有较大的影响,因此还需要关键点检测算法对人脸进行对齐操作。简言之,整体流程为:1)人脸检测,2)关键
前面一篇已经讲了LLM和LLMEngine的初始化阶段,包括设备初始化,模型加载和cache初始化等等,本篇来讲解LLMEngine的生成阶段,功能包括请求的调度以及模型的推理,初步分析调度器Scheduler是怎么工作的,也就是下图的Scheduler部分。本篇介绍了和这两个方法。尤其是后者,其中调度器Scheduler扮演了非常重要的角色,在调度预算和显存限制下,按照指定策略调度了用户请求,进

一个request请求通常对应一个或者多个序列,在vllm中,使用Sequence来表达一个序列,同一个请求中的所有序列构成了一个序列组,用来表达。尽管它们本身并不难懂,但是涉及到了序列的状态标记(是WAITING还是FINISHED)、所处阶段(是Prefill还是Decode)以及对应的逻辑块等等。理解它们,对后续分析vllm调度以及block的分配等问题有着重要作用。另外,本系列之前没有对(

经过前面两篇的铺垫,终于来到了解析LLMEngine的篇章。如下图所示,LLMEngine主要有两部分构成,右边部分包括Worker和等重要的类,它们在LLMEngine的初始化阶段就会用到,工作内容包括模型加载,KV Cache初始化等等,这是本文中重点;左边部分包括Scheduler和,用于调度用户请求,并在过程中管理显存和内存,这部分发生在LLMEngine的(generate)生成阶段,将

项目要求实现web端的人脸比对,即对比两张图片中的人脸是否为同一个人。此问题可以通过人脸识别相关模型来实现,比如经典的FaceNet。然而,图片中通常不止包含人脸,为了更好的提取人脸嵌入向量,就需要先借助人脸检测算法(如RetinaFaceMTCNN)抠出人脸部分;其次,实践发现人脸倾斜对最终的效果有较大的影响,因此还需要关键点检测算法对人脸进行对齐操作。简言之,整体流程为:1)人脸检测,2)关键
本篇文章将介绍如何在web端实现基于yolov7的实时目标检测任务。内容主要包括1)项目的介绍,2)https服务的构建,3)手机端的调试。
随着大模型参数量的增加,其推理加速成为一个重要的研究方向。比如我们在vLLM系列中有讲到,vLLM在内存(显存)管理上使用了技术,再结合的调度策略,大大提高了在面对多个请求时GPU的使用率,这种系统层级上的优化提高了吞吐,降低了延迟。大模型推理之所以低效,主要是因为自回归解码过程受到内存带宽限制(在解码阶段,模型需要频繁从内存中读取和写入数据,而内存带宽又比较有限,因此有较高的延迟。为了突破该性能

经过上一篇关于的铺垫,本篇来讲一下《Fast Transformer Decoding: One Write-Head is All You Need》这篇论文。其在摘要部分的这句表述(如上所示)就强调了大模型在增量推理,也即Decode阶段由于导致的推理效率低下的问题。作者提出了技术,加速了大模型推理。是的变体,本篇跟随论文的思路,分析对比和的性能,最后根据一个demo实测一下效果。关于注意力机

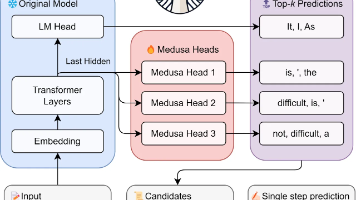
上一篇我们对工作《Fast Inference from Transformers via Speculative Decoding》进行了讲解,对大模型推理加速范式有了基本的认识。尽管上述工作设计简洁,但在实际场景中有如下问题需要克服:1)需要额外训练一个,且尽可能保持其输出分布与一致;2)将一同集成到分布式系统中具有挑战性。对于1)补充说明一下:尽管开源模型系列通常包含不同尺寸的模型,且它们的