


- @cocoack


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
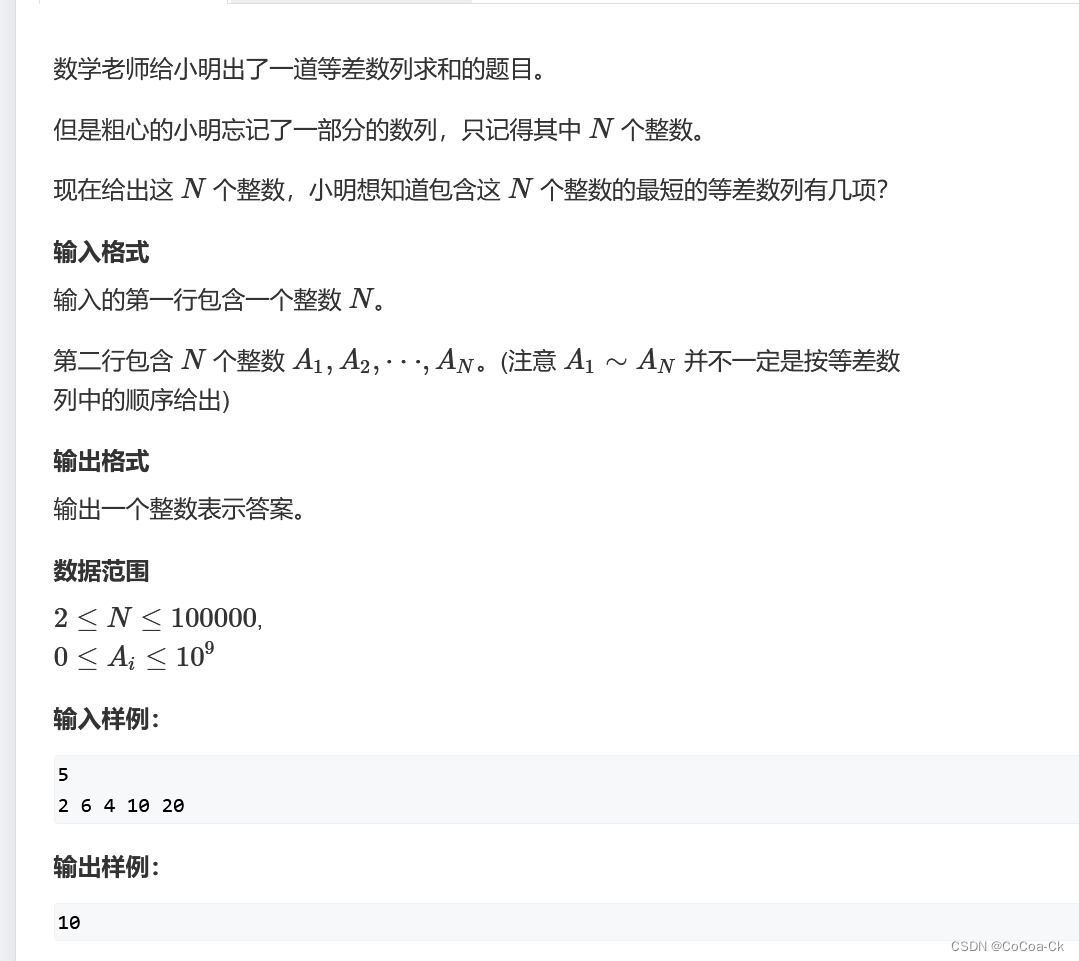
我们要让倍数尽量的小,假如我们乘合数,那么它一定可以分成跟小的质数,假如质数不存在就不选,否则就乘质数,因此我们可以得到一个结论:每次乘p1\p2,因此长度就是a1+a2。分析一下,由等差数列的性质,个数=(an-a1)/d+1,其中an与a1是固定的,因此我们就是让dmax,我们先排一下序,d就是相邻两个数差的gcd,(注意特判0的情况),同时为了方便求,我们让它与a[0]做差即可(答案显然是对
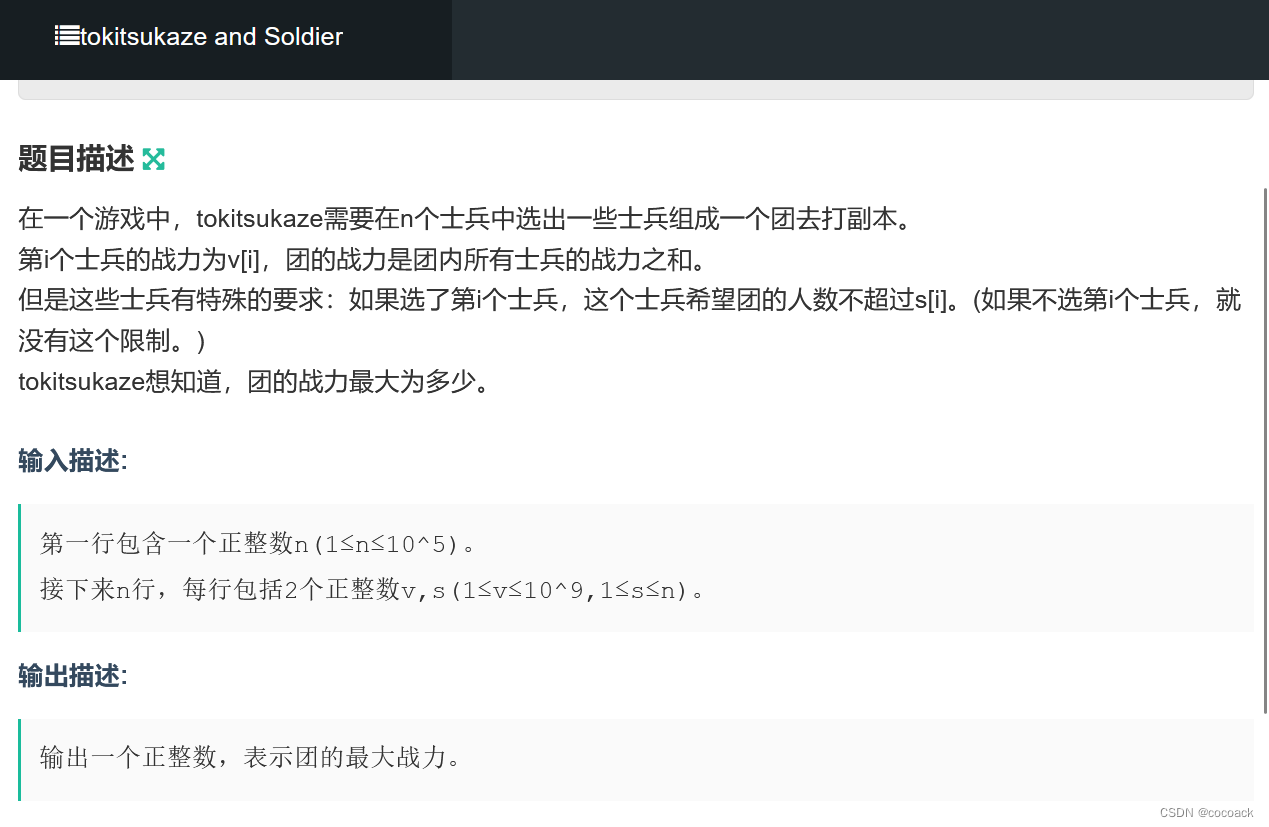
很显然,我们在整体上以s[i]为基准,先把士兵按s[i]排好。最后,举个形象的例子:我们的成长就是从一开始的幼稚不断地经历岁月的打磨,见识的增长,不断优化,最终走向成熟。让我们总结一下,本专题围绕利用优先队列解决贪心选择上的“反悔”(或优化)问题(常用于固定枚举一个基准值)类似的,我们指定一个基准,我们按deadline升序排好,从小的开始枚举。如果前面的时间加当前所需没超当前建筑的deadlin
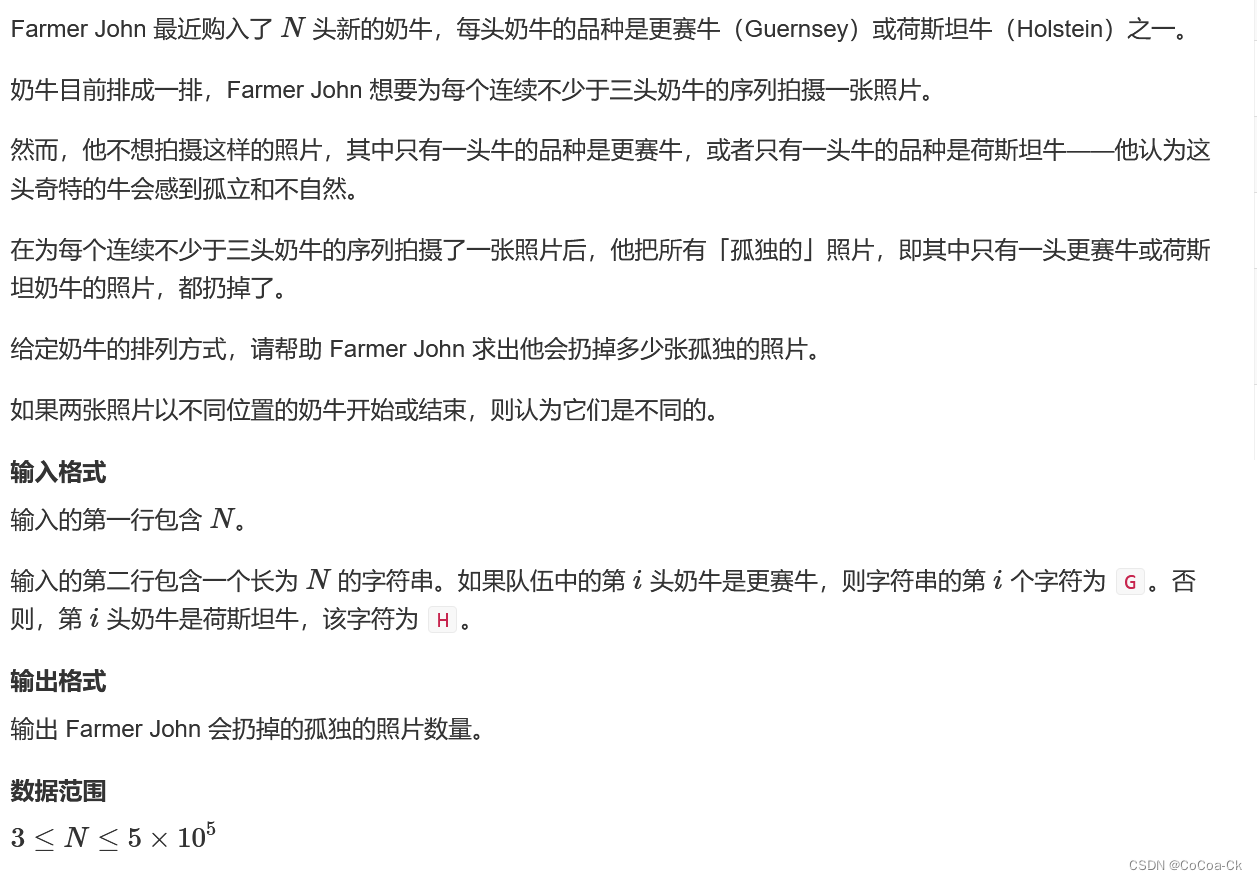
我们可以先枚举区间再统计次数,但这显然TLE。我们可以发现,每一个孤独的区间对应一个孤独的牛,因此我们考虑枚举每一个牛对答案的贡献。跟第一题差不多,我们只要统计出它左边倒数第二次出现的位置以及往右第一次出现的位置即可。我们只要统计一下它左边与右边连续的个数,相乘即可,若左无,那么就是右边的。这是一种数学思想,就是看每一个元素对总和的贡献。分别为L*R,L-1,R-1.
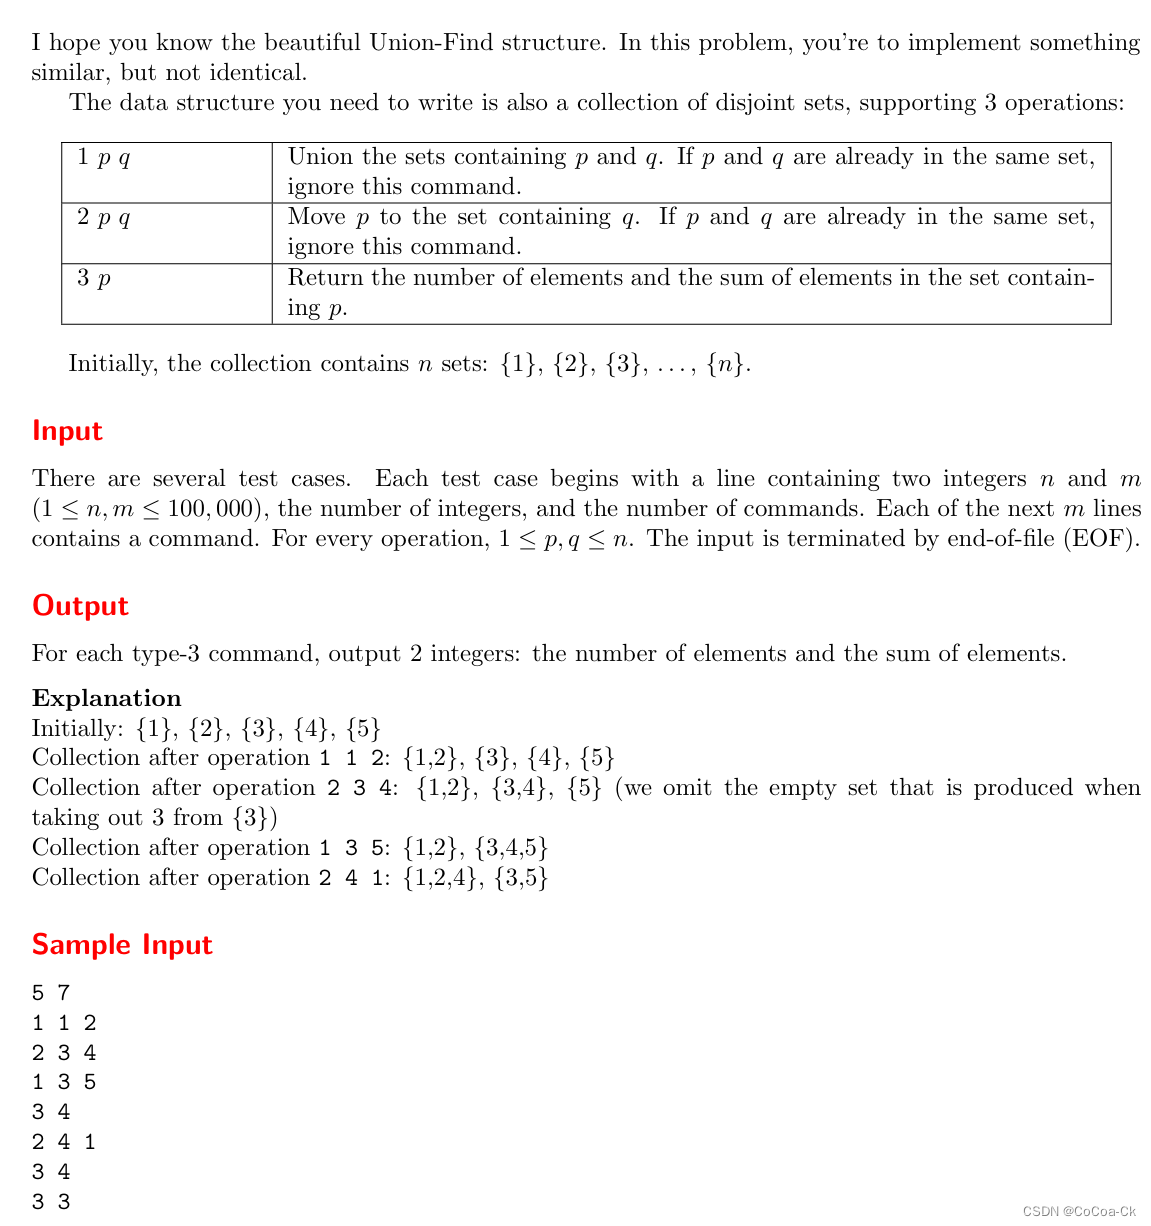
以前有讲过,这里找到了个题目算是填坑了。我们先记录删的,把删的全删了,这样从反方向就是创建了。题目比较模板,但是也扩展了许多以前不知道的知识点,记录一下比较有启发性的题。
何为二分?形象的说,就是单调函数求零点。我们先对二分查找简单的分析一下(主要是模板及易错点)1.找>=x的第一个位置:2.找<=x的第一个位置:while(l<r){while(l<r){mid=(l+r)/2;

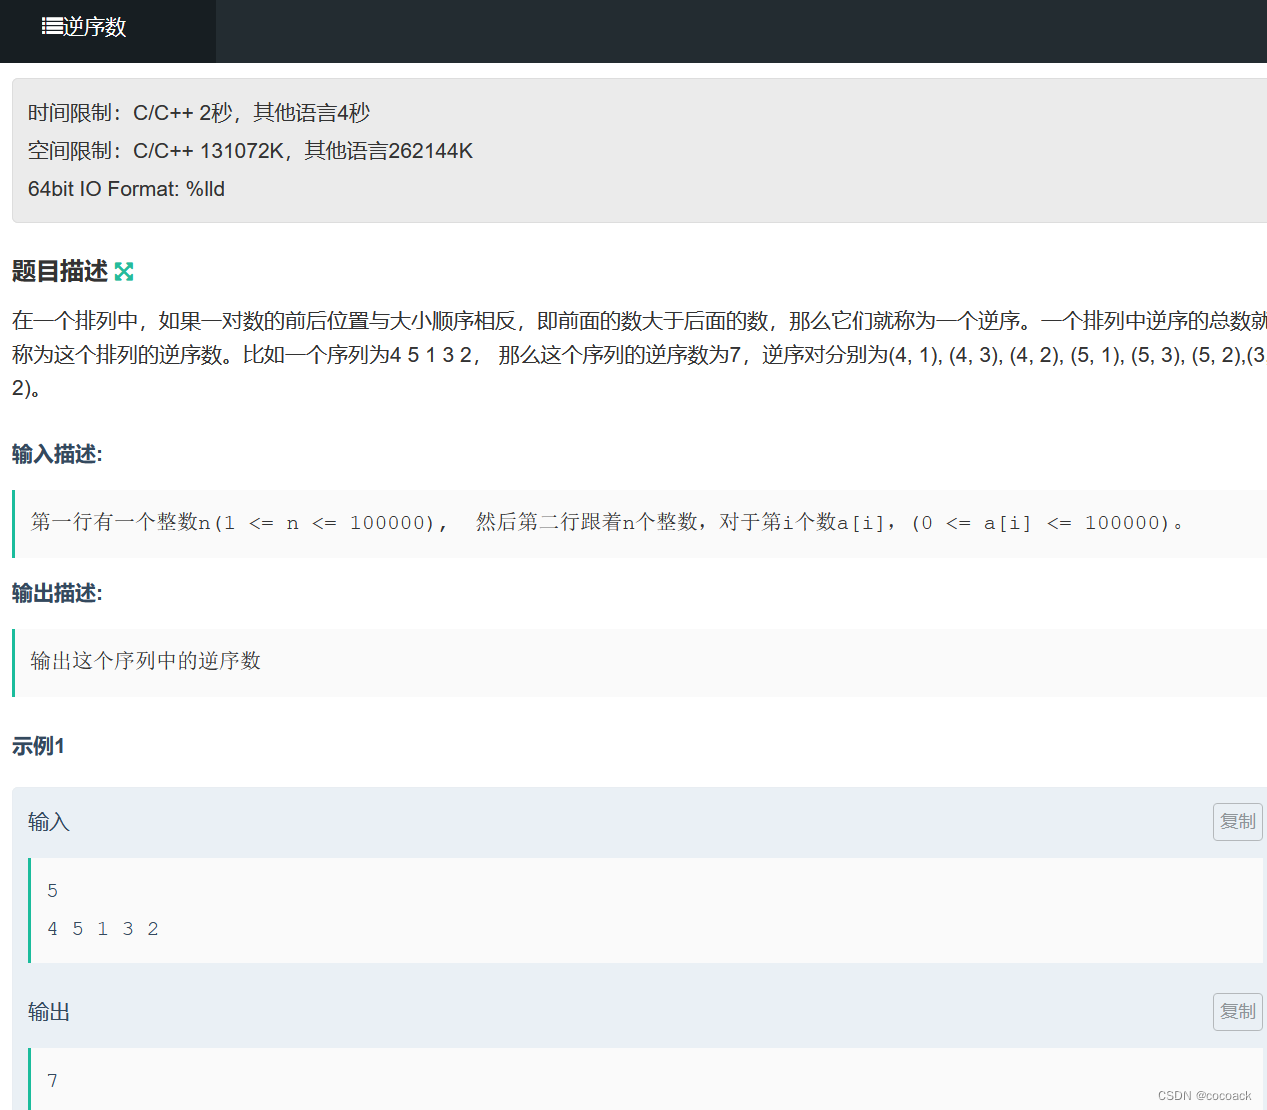
首先,我们知道这可以用冒泡排序的思想,交换的个数即为逆序对的个数(所有的排序都是在消灭逆序对),但这n方的复杂度显然不符合要求,于是我们可以转用归并排序的思想。我们可以先快排,不过这样肯定超时了。这里我们其实不需要关注全局,在快排中舍弃对一些没必要的排序即可。归并的合并过程也是在消灭逆序对。什么是递归呢,就是不断地调用自身函数。
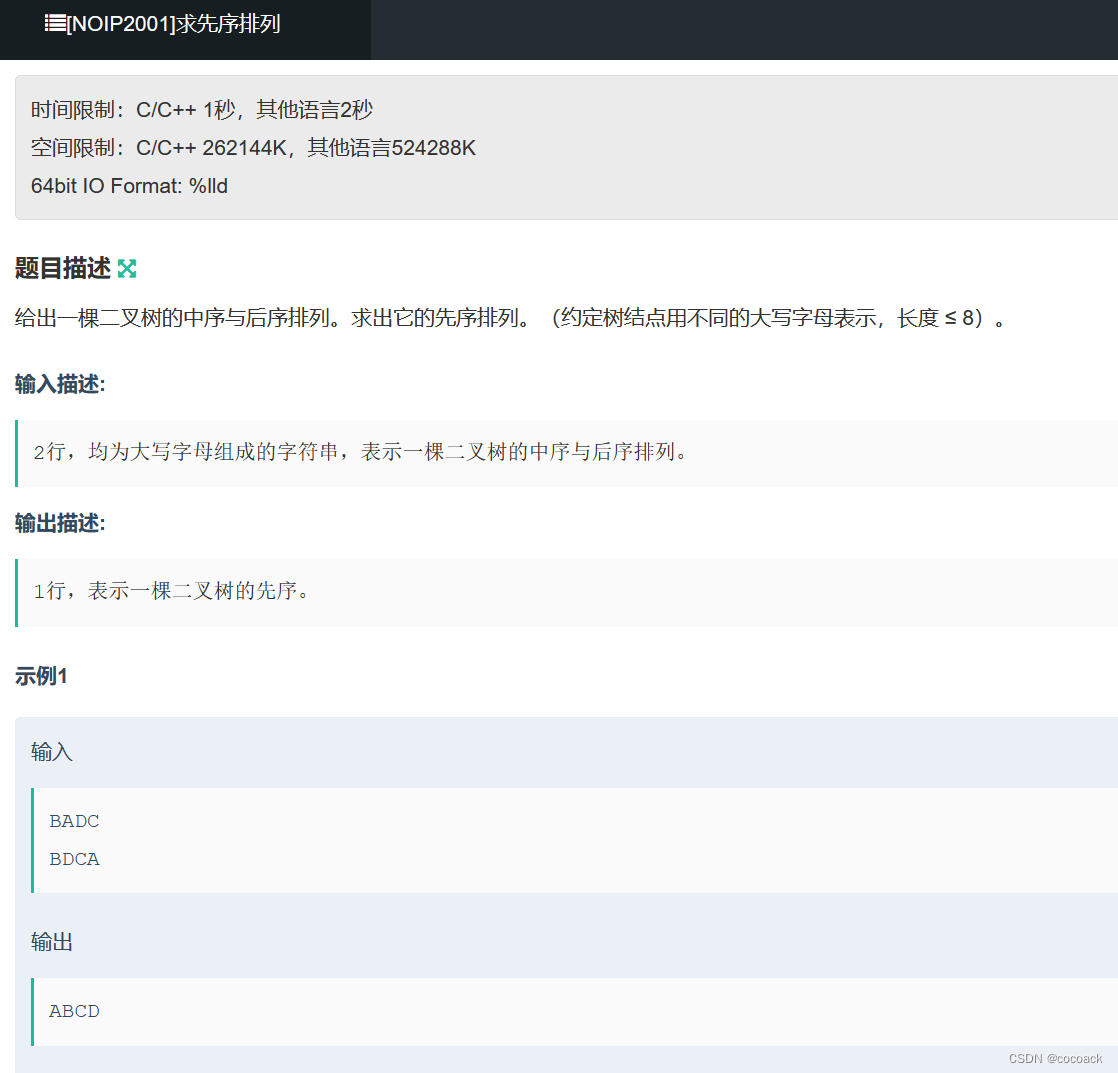
1.在以pos分界,我们把其左右看成一个整体,于是原来s1的左边部分在s2中位于最左边,再根据其个数及连续性可推算出其右界。2.pos找根节点,它可能落在最右或最左边即无左子树或右子树,于是需要对其特判。3.如果l1=r1,说明就一点,直接输出即可。
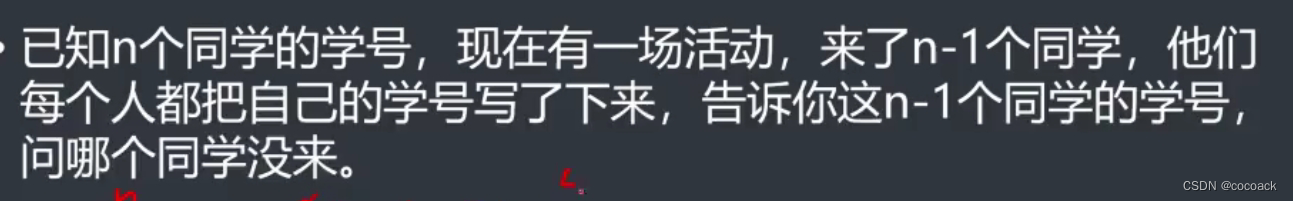
当然,我们可以开个long long 来对学号进行加法运算,再把n-1个同学的学号减去,剩下的即为没来的同学,那n如果很大,时间肯定超。因此,在那一位上,没来的同学一个是1,一个是0.我们按这个把全部的学号分成两组,每一组一定有一个没来的同学,再分别对其上面的操作即可。我们可以创建一个数组,让其从后往前遍历,对于每个字符出现的最新位置更新并把信息赋给当前的字符即可。首先,对于每一个B,其每一个字符
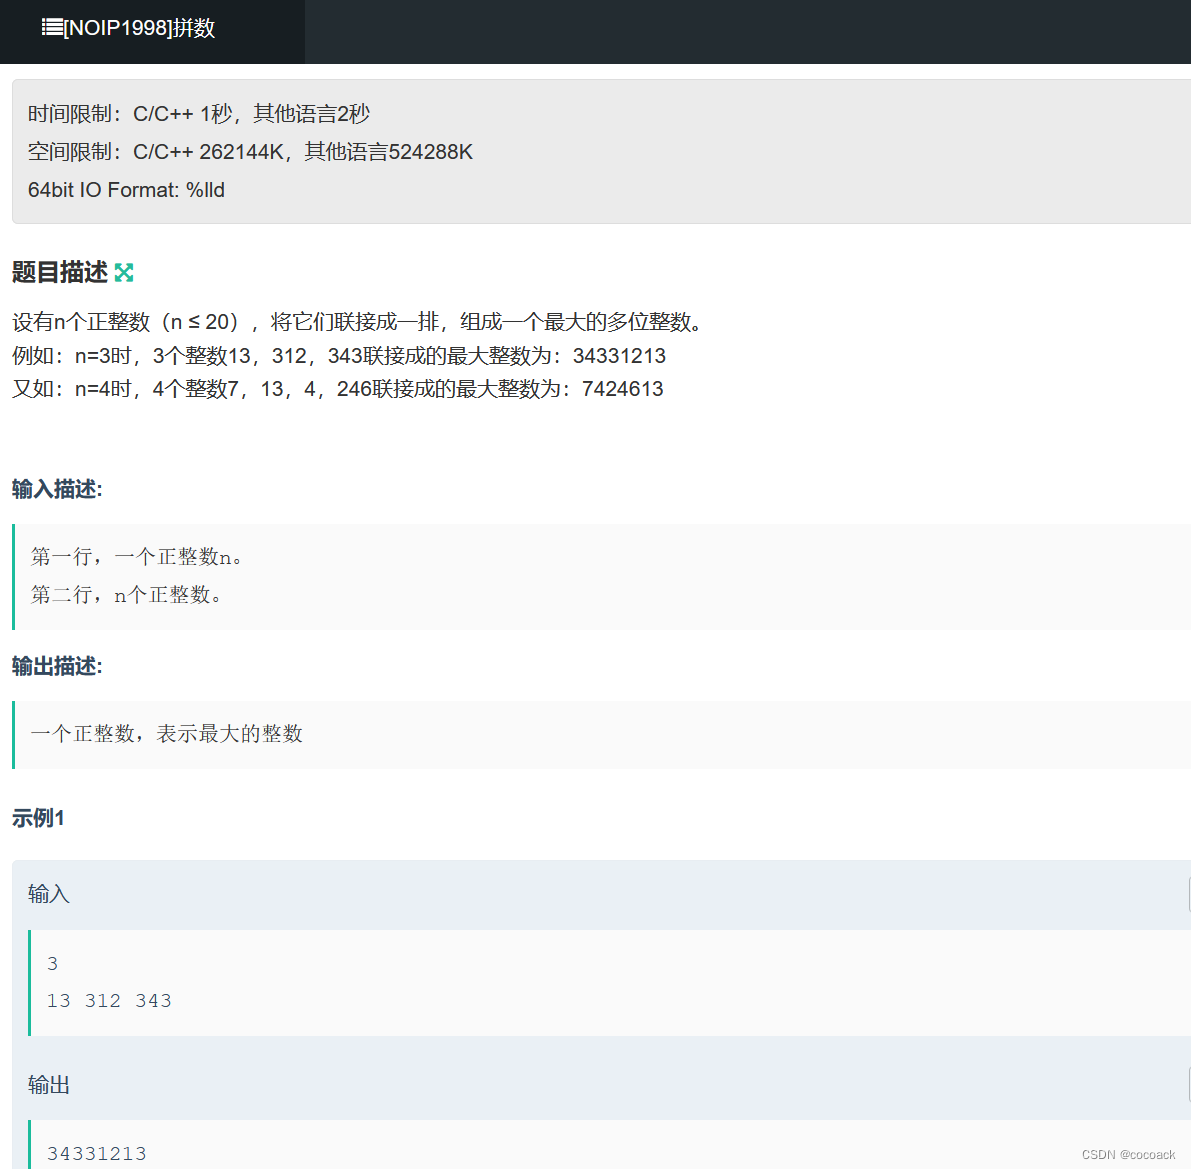
事实上,设a,b为两个字符串,如果a+b>b+a,那么,我们把a放在b的前面,那如果中间插了其他字符串还是这样吗?首先,很容易想到按字典序排列,但是,像233与2332331这样一个数包含于另一个数前缀的数据就会出错。我们可以知道他们中间插入的c一方面a+c>c+a,另一方面,c+b>b+c。所以a+c+b>b+c+a。但是,当你选权值最大的一排,然后再清0,与其他方案相比,他们形成的图不一样。因
很显然,我们先按任务的X排序(因为x起决定作用),然后从大到小按照能选就选的贪心,一方面,这保证钱最多,另为保证强对强,匹配数最多。当两个都可以时,用二分找最近任务y的值,于是用map的二叉搜索树即可。
