- @chengxf2


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
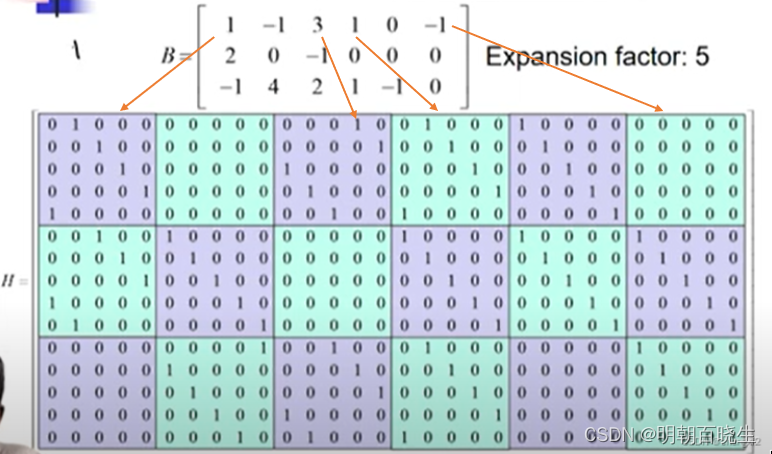
前言下面LDPC 介绍主要参考印度NPTEL,具体可以到外网阅读一下原文,分为8篇博客介绍完毕hello and welcome to this course on LDPC and polar codes in 5g .most of us use cellular phones and smartphones maybe many of usare using 4G cellular phon
前言贝叶斯也是一种常用的分类器,主要用于垃圾邮件分类,文本分类,智能监控的背景建模,人脸识别等方面目录基本概念贝叶斯决策朴素贝叶斯分类器正态贝叶斯分类器例子一 基本概念先看一个问题:盒子白球黑球抽中概率A23...
SpotFi是一种利用商用WiFi芯片已暴露的信息进行高精度室内定位的系统。它不需要对WiFi硬件或固件进行任何修改,即可实现与最先进定位系统相同的定位精度。SpotFi通过结合超分辨率算法和新颖的滤波及估计技术,能够准确计算多径分量的到达角(AoA)并识别出目标与接入点(AP)之间的直接路径。该论文提出了一种基于多维性的被动室内Wi-Fi追踪技术(mD-Track),该技术利用无线信号在人体上的

前言参考文档https://www.cnblogs.com/pinard/p/10825264.html目录:向量对向量的链式求导标量对向量的链式求导标量对多个矩阵链式求导一 向量对向量的链式求导这里默认为分子布局,雅克比矩阵假设其中向量向量向量则下面...
值迭代(Value Iteration)是解决马尔可夫决策过程(MDP)的经典动态规划算法。其核心基于,通过迭代方式求解最优价值函数。1.2矩阵形式V(s)r(s,a)通过采取行动a目的是找到最优策略使得状态值V最大通过contraction mapping 理论,可知道最优状态值可以通过迭代更新求解。
本章节并未介绍新的强化学习算法,而是重点讲解了随机逼近的基础知识,如Robbins-Monro(RM)算法和随机梯度下降(SGD)算法。与许多其他求根算法相比,RM算法的独特优势在于。研究证明,SGD算法实质上是RM算法的一个特例。均值估计作为贯穿本章的核心议题,其算法(6.4)成为本书介绍的首个随机迭代算法。我们通过分析表明,该算法可视为特殊形式的SGD算法。后续第七章将揭示时序差分学习算法具有
在强化学习的浩瀚海洋中,我们最熟悉的莫过于 Q-Learning 和 DQN。这类算法属于方法,即先学习状态的价值,再根据价值选动作。但在很多复杂场景(如机器人控制、大型策略空间)中,直接学习策略往往更直观、更有效。这就是方法的由来。今天我们就来聊聊其中的经典——,并重点剖析两个让他“脱胎换骨”的技巧。
值迭代(Value Iteration)是解决马尔可夫决策过程(MDP)的经典动态规划算法。其核心基于,通过迭代方式求解最优价值函数。1.2矩阵形式V(s)r(s,a)通过采取行动a目的是找到最优策略使得状态值V最大通过contraction mapping 理论,可知道最优状态值可以通过迭代更新求解。
作为 Gym 中最硬核的机器人控制任务之一,BipedalWalkerHardcore-v3 对强化学习算法的鲁棒性提出了严峻考验。其训练曲线在后期呈现明显的高方差特性,这也使其成为剖析 PPO 参数细节与调试策略的理想案例。我们将以此为切入点,记录一次完整的调参与优化实战。
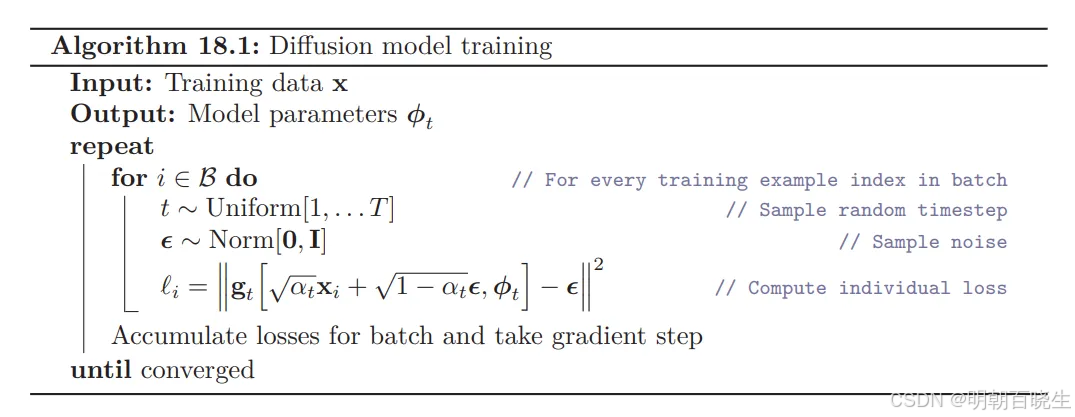
生成模型里面发展: AE->VAE->GAN ->WGAN -> Diffusiong本篇我们重点是推导一下Diffusion 模型用的3个公式:下面红色的是用到了VAE重采样的原理。