- @bylander


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
Transformer模型在前向传播中对每个token均匀分配计算资源,这在处理不同的语言建模问题时并不高效,因为并非所有token和序列都需要相同的计算量来进行准确预测。MoD模型旨在解决这一问题,通过动态分配计算资源,以更高效地使用计算预算。

OpenAI最新发布《A practical guide to building agents》,比较有指导意义,做一个介绍。
如何将LMM应用于通信领域,这是我作为通信专业人士,必须关心的一个话题。这篇文章,总的来说,关于已有探索的局限性分析的不错,关于后面的开放性问题也总结的不错。但是文章提出的框架,还是有些过于概念化。

推荐系统和RAG(Retrieval-Augmented Generation)确实在某些方面有相似之处,尤其是在处理信息检索和生成任务时

谷歌最新论文《Leave No Context Behind: Efficient Infinite Context Transformers with Infini-attention》,提出了一种新的方法来扩展基于Transformer的大型语言模型(LLMs),使其能够高效处理无限长的输入序列,同时保持内存和计算资源的有界性
当大模型只会“被动答题”已不够,阿里通义实验室最新论文《WebDancer》给出一条“从数据到算法”的端到端配方,让开源模型也能像OpenAI Deep Research一样,自主规划、翻网页、多跳推理,完成复杂信息检索任务。
信息论角度探讨语言模型的本质,指出预测next token的过程实际是对语言信息的高效压缩。压缩程度反映预测准确性,条件概率越精准,信息压缩越接近极限。因此,语言模型通过预测token实现了对语义空间的建模,其预测能力与信息压缩效率直接相关。
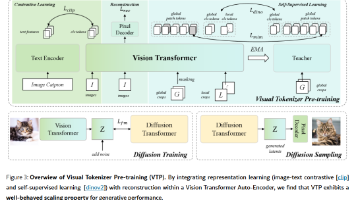
图像生成模型,包括两部分,先通过VAE,将原始图像变换到隐空间,然后在隐空间进行图像的生成,最后再通过VAE的解码变换到图像域。但是传统的方式,对于VAE部分,也就是论文说的Pre-training of Visual Tokenizers部分,无法scaling——而且,token部分的scaling还与下游的模型生成出现相反的效果。论文分析,这里的原因,在于,传统的的token部分,主要是进行
2026年春节,国产大模型迎来密集发布潮,DeepSeek、字节跳动、智谱AI等厂商纷纷推出新一代模型,技术竞争从参数规模转向工程化落地。DeepSeek-OCR 2实现百万级长文本处理,字节Seedance 2.0视频生成模型引发关注,智谱GLM-5参数达7450亿。行业呈现超长上下文、多模态融合、Agent工程化等趋势,API进入"厘时代"。与此同时,OpenAI发布GPT
VSCode中就可以安装,点击两下,非常容易就完成了安装