- @akb48fan710


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
端侧 AI 与本地 Agent 正在快速落地,各类端侧硬件的 NPU 推理算力也得到大幅提升。但不少开发者在实际落地时依旧要面对重重门槛,整个流程耗时长、上手门槛高,阻碍了端侧大模型与 Agent 项目的快速验证。LlamaPi 的思路是把复杂的部署流程封装简化,为开发者提供一套开箱即用的离线私有 Agent 推理底座。
目 录概述 1代码编译及下载 1uboot 编译步骤 1kernel 编译步骤 2Android 编译及固件生成步骤 2刷机说明 4补丁 55. 蓝牙:蓝牙串口使用 uart1 56. CAMERA 使用的是 OV5695,调整方向 57. WAV 及 APK 内音频使用 nu_player,避免尾音 58. 距离传感器支持 69. EVB 为物理竖屏,如果要默...
这不是一颗和 RK3588 竞争的产品——它的规格在另一层。RK3588 是边缘 AI 的中坚力量,6 TOPS NPU、8K 编解码、双千兆,覆盖了当前 80% 边缘计算场景。而 QCS8550 把 NPU 算力拉到 48 TOPS,加上 Adreno 740 GPU、4 路 CSI、三路 M.2 扩展——它瞄准的是需要更大算力储备的边缘场景:多模态大模型推理、多路高清视频 AI 分析、云游戏渲
200 TOPS NPU、36GB ECC 内存、8 路 GMSL2、-40℃~85℃——这不是服务器参数,这是一台巴掌大的边缘 AI 盒子。AIBOX-9075 采用高通 IQ-9075 处理器,是目前天启智能算力最高的边缘 AI 产品。它把旗舰手机的 NPU 算力和工业级接口做在了一起。
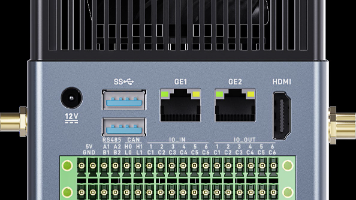
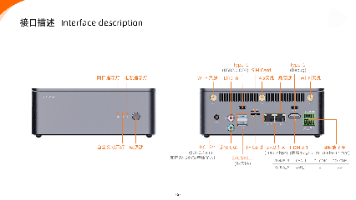
48 TOPS NPU、Adreno 740 光追 GPU、8K@60fps 编解码——这些手机 SoC 旗舰参数,被天启智能装进了一台铝合金盒子。AIBOX-8550 是一台基于高通 QCS8550 的边缘 AI 计算盒,整机采用全铝合金外壳 + 格栅散热设计,可直接部署在工业现场或边缘机柜中。
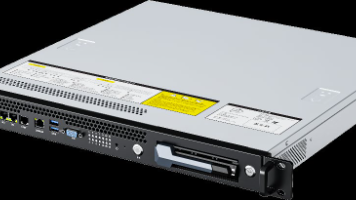
10 个 SpacemiT Key Stone K3 计算节点 + 1 个 RK3588 控制节点,1U 机架、600 TOPS SquareINT4 算力、整机功耗 150W~300W——CSB1-N10SPK3 是 RISC-V 架构在边缘算力场景里的一次高密度落地。
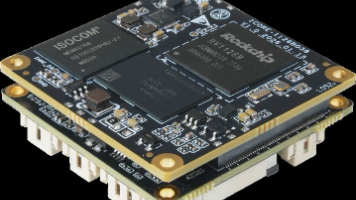
天启这套 38mm 模组平台的策略有点东西。CAM-3576 和 CAM-1126B 共用一套 PCB 封装和接口定义,但分别瞄准了「AI 算力」和「AI 视觉」两个不同的市场方向。RK3576 的优势是通用算力 + 大模型 + 车规;RV1126B 的优势是 AI-ISP + 超低功耗 + 加密 + 超编码。如果你只需要在摄像头端侧做轻量 AI 分析、省功耗、过国密合规,RV1126B 是更精准
维度RK3566 能 / 不能备注跑 1~2 Hz 重型策略✅ 充裕A55 4 核 @1.8 GHz 足够 50 Hz多模态融合(IMU+ToF+Camera)✅ 充裕I²C / SPI / MIPI-CSI / USB 全在多进程协作✅ 充裕Linux 标准进程模型板上训练 / 在线学习❌ 不建议数据中心级算力更适合1 TOPS NPU 加速 ONNX✅ 可用rknn-toolkit 一键转换长
传统边缘盒子,AI 推理和视频处理挤在同一颗芯片上,算力一紧张就互相抢资源。AIBOX PRO 把活儿拆了:主模组(Core-3588JD4 / Core-3576JD4)负责任务调度和数据预处理——说白了就是「大脑」;副模组专门负责 AI 推理的核心算力输出,两者通过板载 PCIe 高速互联,做模型并行、多任务协同。这套设计对机器人导航、多模态感知这类场景很实用:感知和决策能分到不同模组上跑,延
要在边缘端本地跑 7B~35B 级别 LLM/VLM;数据不能上云,必须本地推理;对功耗和体积敏感;未来有扩展到双卡、跑更大 MoE 的需求。只跑 CV 小模型,RK1828 性价比更高;完全不能接受量化精度损失;需要 CUDA/OpenVINO 之类的通用 GPU 生态。整体体验下来,LQ50 给 AIBOX PRO 的定位非常明确:它不是为了替代服务器 GPU,而是把"35B 以内大模型的本地