
副模组 LQ50 实战:把 35B 大模型塞进一块 M.2 加速卡是什么体验
副模组 LQ50 实战:把 35B 大模型塞进一块 M.2 加速卡是什么体验
边缘端跑大模型这件事,过去听起来像把大象塞进冰箱。但最近把后摩 LQ50 插进 AIBOX PRO 跑了一圈之后,我的感受是:只要软件栈跟得上,35B 以内的模型在边缘盒子里落地,已经不再是 PPT 能力了。
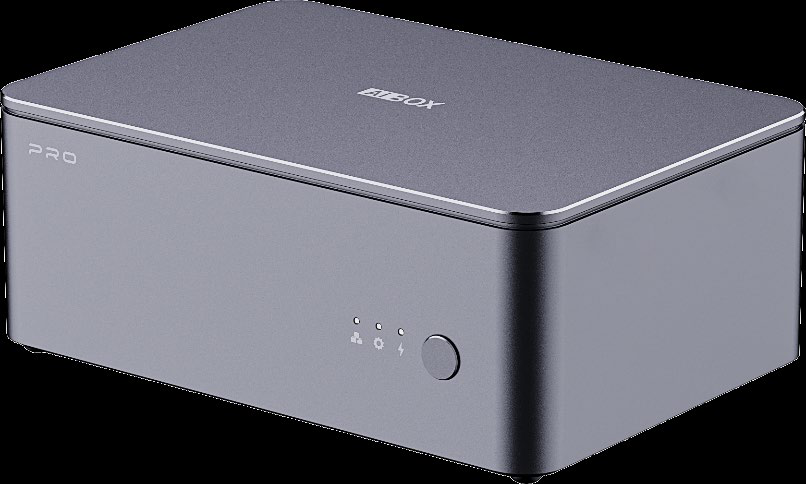
一、为什么给 AIBOX PRO 配 LQ50?先看副模组定位
AIBOX PRO 用的是主-副异构架构:主模组 RK3588/RK3576 负责调度、多媒体编解码和丰富的 IO;副模组走 PCIe 高速互联,专门负责 AI 推理算力输出。规格书里列得很清楚,副模组支持 RK1828、RK1820 和后摩 LQ50 等多种加速卡。
我简单理解这个分工就是:主模组当"班长",副模组当"体育委员",一个统筹任务,一个输出算力。
| 角色 | 模组 | 定位 | 典型能力 |
|---|---|---|---|
| 主模组 | RK3588 | 任务调度 / 编解码 / IO | 6 TOPS INT8,8K 编解码 |
| 副模组 | RK1828 | 轻量 AI 推理 | 5 GB DRAM,20 TOPS,可跑 ≤7B 模型 |
| 副模组 | 后摩 LQ50 | 大模型推理 | 48 GB LPDDR5,160 TOPS,可跑 ≤35B 模型 |
LQ50 是一块 2280 规格的 M.2 M-KEY 卡,AIBOX PRO 内部正好有两个这样的槽位。也就是说,单卡是 48 GB / 160 TOPS,双卡就是 96 GB / 320 TOPS,这个扩展空间对边缘设备来说已经相当夸张了。
二、硬件上手:一张 M.2 卡,48 GB 显存
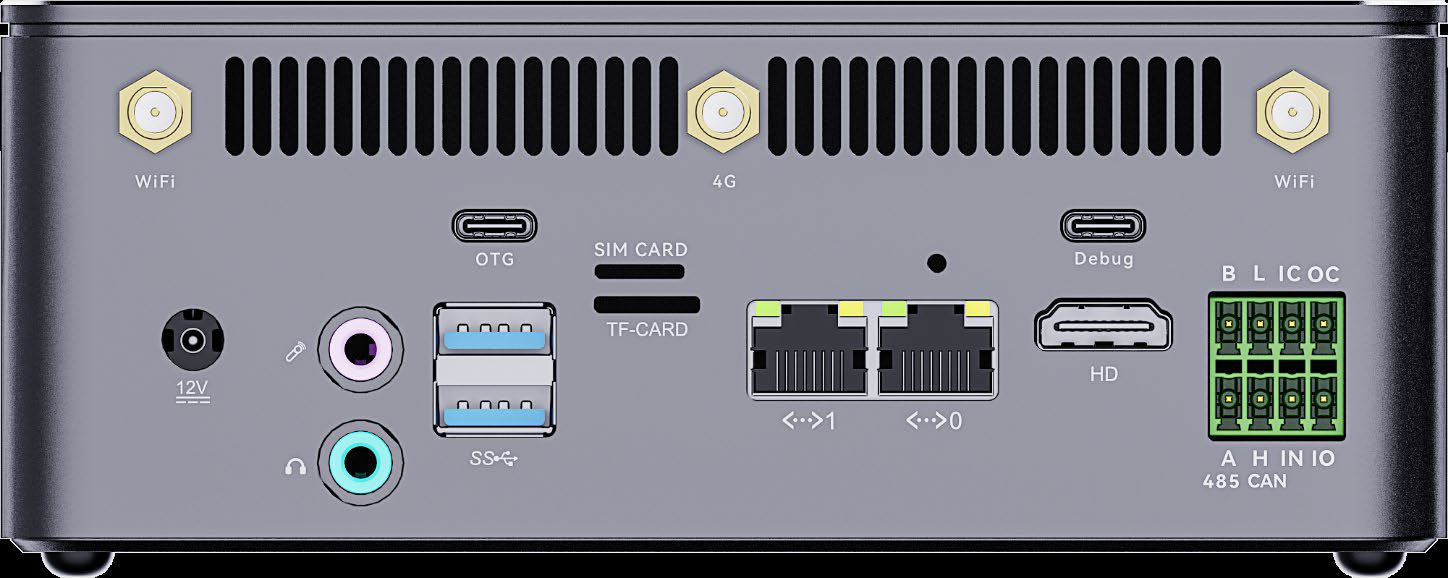
第一次把 LQ50 插进 AIBOX PRO 时,有点不真实感:这么一张跟 NVMe SSD 差不多大的卡,背面塞着 48 GB LPDDR5 和一颗 M50 存算一体芯片。它不需要外接电源,直接靠 M.2 供电和 PCIe 通信,对整机集成非常友好。
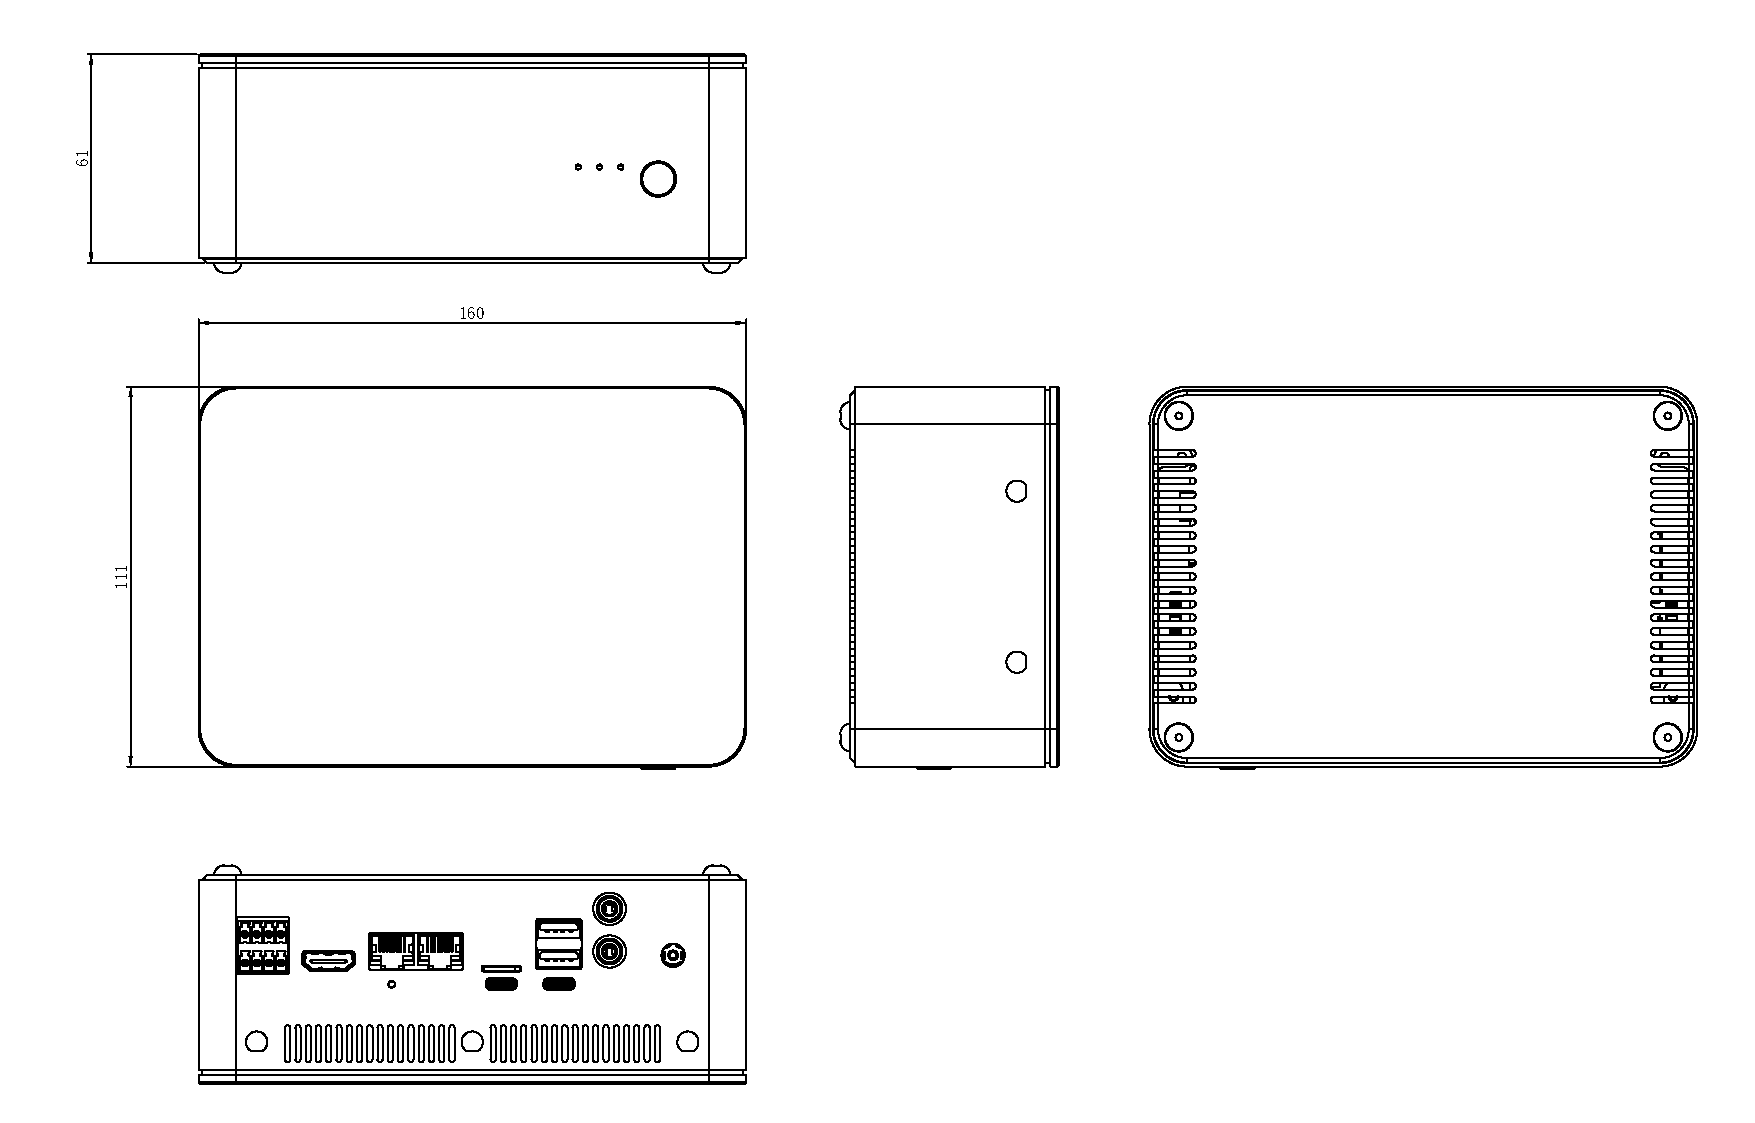
AIBOX PRO 整机尺寸是 160 mm × 111 mm × 61 mm,全铝合金外壳带风扇。这个体积塞下 RK3588 + 1 块 LQ50,再加一个扩展位,对于需要"本地跑大模型"的机器人、工业质检、智能安防等场景来说,体积和接口都是及格的。
装机后第一件事是确认设备被识别。Linux 下用 lspci 能看到后摩设备,Windows 下则走后摩提供的驱动安装包。驱动装完后,SMI 工具可以直接读到芯片温度、功耗和固件版本,这套工具链对排障很友好。
三、软件栈:后摩大道不是单一工具,而是一整条流水线
后摩给 M50 系列配的是"后摩大道"软件平台,它是一套从底层固件到上层推理的完整栈。根据软件平台概览,整个栈大致可以分成四层:
- 芯片固件与驱动层:芯片固件、Linux/Windows/Android 驱动、HMDML 设备管理库、SMI 系统管理接口、HmUpdateTool 固件升级工具。
- 模型量化、编译与推理层:HMQuantool 量化工具、TCIM 模型编译器、TCIM Runtime 推理引擎、Profiler 性能调试工具。
- 开发环境与工具:基于 Ubuntu 24.04 的 Docker 标准镜像、Windows MSVC Runtime SDK、Android Native 运行时、部署环境检测工具和模型评测工具集。
- 应用软件开发套件:后摩揽月 AI 开发套件,包含 HLIE 推理框架、HLAW 中间件等。
要在 LQ50 上跑一个大模型,标准流程是三步:
- 量化:用 HMQuantool 做 PTQ 量化。对 LLM 来说,通常调用
LLMConverter.from_pretrained(),配合Qwen2ConvertConfig或Qwen2VLConvertConfig之类的模型配置,把 fp16/bf16 模型转成后摩内部格式。精度上常用w4a8(权重 4-bit,激活 8-bit),在显存和精度之间取得平衡。 - 编译:用 TCIM 把量化后的模型编译成
.hmm执行文件。TCIM 基于 MLIR,会做算子融合、异构计算单元映射、内存规划和执行路径优化。 - 推理:TCIM Runtime 加载
.hmm,提供 C++ 和 Python API。对于 LLM,还支持 MTP 多 token 投机解码、Prefix Caching 等加速手段。
四、实测数据:单卡能跑多远?
光聊流程没意思,直接看官方 M50 模型性能数据。测试环境是 Ubuntu 24.04 Docker 镜像、Intel i7-12700 主机、IPU 核频率 1400 MHz。单卡对应的是 LQ50 M.2(1 颗 M50 芯片),双卡对应 LQ50 Duo(2 颗 M50 芯片)。
| 模型 | 参数量 | 量化精度 | 芯片数 | Decode (tps) |
|---|---|---|---|---|
| Qwen3.5 | 0.8B | w8a16 | 1 | 87.79 |
| Qwen3.5 | 2B | w8a16 | 1 | 45.38 |
| CoPaw-Flash | 9B | w4a8 | 1 | 20.52 |
| Gemma 4 | 26B-A4B (MoE) | w4a8 | 1 | 27.10 |
| Gemma 4 | 31B (dense) | w4a8 | 2 | 10.38 |
| Qwen3-next | 80B-A3B (MoE) | w4a8 | 2 | 23.40 |
几个让我印象深刻的点:
- MoE 架构在边缘端是降维打击:Gemma 4 的 26B-A4B MoE 在单卡上就能跑到 27 tps,而同系列的 31B dense 模型必须上双卡才勉强跑到 10 tps。同样 30B 级别,MoE 的内存效率和吞吐都更好。
- w4a8 是大模型的甜点精度:4-bit 权重能显著降低显存占用,8-bit 激活又比纯 INT4 更稳。看数据也知道,官方 benchmark 里大模型基本默认 w4a8。
- 单张 LQ50 的甜点区间是 7B~35B:小到 Qwen3.5-2B 的 45 tps,大到 26B-A4B MoE 的 27 tps,单卡都能舒服地跑;超过 35B 的 dense 模型或更大的 MoE 就需要双卡了。
五、双 LQ50 的想象空间
AIBOX PRO 有两个 M.2 M-KEY 槽位,这是它最被低估的设计。单卡 48 GB,双卡就是 96 GB;单卡 160 TOPS,双卡就是 320 TOPS。
更关键的是 TCIM Runtime 支持单模型多设备部署,能通过芯片间互联做 Pipeline Parallel 和 Tensor Parallel。这意味着可以把一个 80B 级别的 MoE 模型拆开跑在两张 LQ50 上。Qwen3-next 80B-A3B 在双卡上 Decode 能到 23.4 tps,这个水平放在边缘盒子里已经很能打了。
所以我的判断是:如果你现在只需要跑 14B 以内的模型,单卡 LQ50 足够;如果你未来要跑 30B~80B 的 MoE,或者想同时跑多个模型,AIBOX PRO 的双 M.2 槽位就是预留的升级路径。
六、功耗与散热:不是只有跑分
规格书上 RK3588 + 1×LQ50 的典型功耗是 8.4W(12V/700mA),最大功耗 28.8W(12V/2400mA)。实测跑 LLM 推理时,功耗会动态变化:Prefill 阶段短时冲高,Decode 阶段相对平稳。
后摩提供了功耗和热管理工具,支持 DVFS 动态调频。我的实战经验是:
- 日常服务场景用默认 DVFS 就够了,兼顾性能和功耗;
- 对首 token 延迟敏感的场景,可以把 IPU 核锁在最高频率;
- AIBOX PRO 机箱自带风扇,长期满载建议竖放或留足通风空间;
- 用 SMI 随时看结温和功耗,比盲调靠谱。
七、踩坑与建议
- 量化精度别盲选:小模型可以用 w8a16 保精度,大模型必上 w4a8,否则 48 GB 也扛不住。
- 校准数据要贴近业务:HMQuantool 的 PTQ 对校准集敏感,别拿跟实际输入分布差太远的数据凑数。
- 开发环境首推 Docker:后摩提供的 Ubuntu 24.04 Docker 镜像里工具链齐全,比自己从零配环境稳得多。
- 双卡注意 PCIe 带宽:AIBOX PRO 主副模组通过 PCIe 互联,超大模型 Prefill 阶段的卡间通信会吃掉一部分吞吐,跑 benchmark 时要把这个因素算进去。
- SMI 是排障神器:固件版本、驱动版本、温度、功耗,一条命令全看到,很多问题不用猜。
八、总结:LQ50 适合谁?
适合:
- 要在边缘端本地跑 7B~35B 级别 LLM/VLM;
- 数据不能上云,必须本地推理;
- 对功耗和体积敏感;
- 未来有扩展到双卡、跑更大 MoE 的需求。
不太适合:
- 只跑 CV 小模型,RK1828 性价比更高;
- 完全不能接受量化精度损失;
- 需要 CUDA/OpenVINO 之类的通用 GPU 生态。
整体体验下来,LQ50 给 AIBOX PRO 的定位非常明确:它不是为了替代服务器 GPU,而是把"35B 以内大模型的本地推理能力"塞进一个边缘盒子里。对机器人、工业边缘、智能安防这些场景来说,这种"主控+大模型推理卡"的异构方案,可能是目前最务实的落地路径之一。
更多推荐


 6
 0
- 0


 已为社区贡献9条内容

所有评论(0)