


- @ab977a1081268482


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
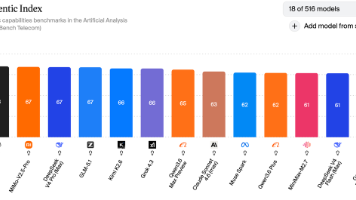
基于独立评测机构Artificial Analysis发布的最新AI模型基准测试结果,本文围绕Agentic智能指数与Coding Agent指数两大核心维度展开横向对比。这两项指标与日常代码开发需求和OpenClaw、Harness等通用Agent场景高度契合:Agentic能力直接决定模型自主规划复杂任务、调度外部工具、驱动自动化流程的水平Coding Agent能力则是评估模型代码生成、调试
模型的生成效果高度依赖于超参数的设置。(温度)、top_p(核采样)和是最常用的三个调节旋钮。:控制随机性。设为 0 时模型倾向于选择概率最高的词,输出确定但可能枯燥;设为 0.7-0.9 时,输出更具创造性和多样性,适合创意写作;超过 1.0 则可能导致逻辑混乱。Top_p:与 Temperature 配合使用,限制候选词的范围。例如top_p=0.9表示只从累积概率达到 90% 的词集中采样,
对比智谱、OpenCode、MiniMax、Kimi、字节方舟、DeepSeek、Codex、Claude Code、Ollama、阿里百炼等 AI 编程平台,梳理 2026 年 8 月下旬的套餐价格、模型能力、限购状态、综合单价与支付网络门槛,并按订阅、按量 API 和实际使用场景给出选型建议。
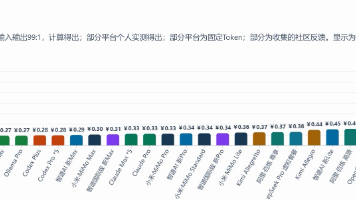
对比智谱、OpenCode、MiniMax、Kimi、字节方舟、DeepSeek、Codex、Claude Code、Ollama、阿里百炼等 AI 编程平台,梳理 2026 年 8 月下旬的套餐价格、模型能力、限购状态、综合单价与支付网络门槛,并按订阅、按量 API 和实际使用场景给出选型建议。
DeepSeek V4 Pro 正式版上线,性能提升显著 8月13日,DeepSeek V4 Pro 正式版在APP、网页端和API同步上线,支持专家模式及多项API功能(Tool Calls、JSON Output等)。官方评测显示,V4 Pro在Agent/Coding任务上多数超越Claude Opus 4.8,整体接近Claude Fable 5,DeepSWE得分达63%。API定价采用
DeepSeek V4 Pro 正式版上线,性能提升显著 8月13日,DeepSeek V4 Pro 正式版在APP、网页端和API同步上线,支持专家模式及多项API功能(Tool Calls、JSON Output等)。官方评测显示,V4 Pro在Agent/Coding任务上多数超越Claude Opus 4.8,整体接近Claude Fable 5,DeepSWE得分达63%。API定价采用
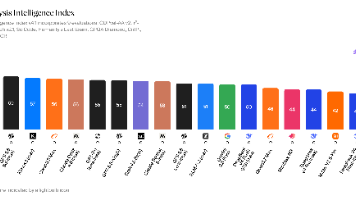
2026年8月AI模型评测摘要:根据Artificial Analysis最新基准测试,Claude Opus 5以61分登顶Intelligence Index榜首,Qwen3.8 Max以55.4分成为Agentic Index首款国产冠军。GPT-5.6 Sol(59分)代表OpenAI旗舰性能,Kimi K3(57分)领跑国产综合能力。DeepSeek V4 Flash 0731以50分展
智谱发布GLM-5.2大模型升级,编程能力显著提升 2026年6月13日,智谱AI正式推出GLM-5.2大模型,面向GLM Coding Plan用户全面开放。本次升级主要包含三大改进: 上下文窗口扩展至100万tokens,显著提升长代码处理能力 新增High/Max双档思考强度,复杂任务建议使用Max模式 保留GLM-5.1高速版,形成高低搭配 私有测试数据显示: 在Code V3基准测试中综
在本期 19 款集合中 Intelligence / Coding / Agentic 三项均为第一。GLM-5.2开源 Intelligence 达 51,Agentic 75.9 超过 GPT-5.5,成为国产最值得关注的新旗舰。上线,走编程专项 + highspeed 路线;横向 Coding 仍略低于 K2.6。国产 Agentic 第一集团仍由MiniMax-M3GLM 系列共同构成,与

2026年6月AI大模型评测: 最新基准测试显示,GPT-5.5以59.1分蝉联Coding指数榜首(代码生成与调试能力),Claude Opus 4.8以77.8分登顶Agentic智能指数(复杂任务规划与工具调用)。国产模型表现亮眼:Qwen3.7 Max(50.1分)跻身全球代码能力第七,DeepSeek V4 Pro、Kimi K2.6等6款国产模型同时入围两大榜单前十。
