


- @Q530778539


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
xilinx polar/ldpc ip、fpga 5g polar方案/ldpc方案等调试问题解决相关事宜本人从事FPGA行业多年,拥有行业内少有的资源可提供包括以下及其他资源及相关调试方案:5G NR polar、5g NR ldpc、5G polar ip、5g ldpc ipxilinx ip调试问题解决、xilinx ldpc ip、fpga 5g polar方案、fpga 5g ldp

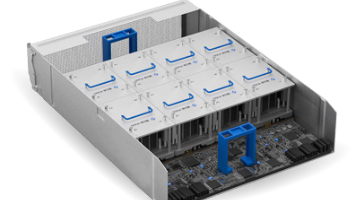
摘要:随着AI算力需求激增,基于OCP OAI开放标准的高密度加速器组成为提升数据中心效率的关键方案。这类模块化设计集成多个OAM计算模组,支持FP16/INT8等全精度计算,单节点可达1PFLOPS算力,适用于大规模训练和高吞吐推理。其200GB/s高速互联与GDDR6内存池优化了分布式计算性能,但需考量散热、功耗及软件生态等部署因素。开放标准架构为AI基础设施提供了模块化、标准化的发展路径,选
本文深入剖析了XCZU47DR-2FFVE1156I异构计算芯片的技术特性与应用价值。该芯片采用双轨处理器子系统与可重构硬件加速引擎,通过深度异构架构实现高可靠性与实时性处理。其强化级可靠性设计、内生安全体系和SoC集成特性,使其成为自动驾驶、科学仪器等前沿领域的核心解决方案。文章指出,该芯片不仅拓展了系统设计边界,更推动了智能化边缘计算的发展,为开发者提供了应对复杂工程挑战的关键技术平台。

昆仑芯发布K200 AI加速卡,算力跃升至256 TOPS,专为云端AI训练与推理设计。基于成熟XPU-K架构,配备16GB HBM内存和512GB/s带宽,支持千亿参数模型训练。相比前代K100,K200实现算力翻倍,兼容现有开发环境,填补国产高端AI算力空白。其全高全长双槽位设计面向数据中心场景,支持从计算机视觉到NLP的多领域应用,为企业提供从训练到部署的一站式国产化解决方案。

国产AI加速卡R200技术解析:基于7nm XPU-R架构,提供256 TOPS(INT8)至32 TFLOPS(FP32)的多精度算力,配备16/32GB GDDR6显存(512GB/s带宽)和PCIe Gen4接口。其特色包括108路视频解码能力、150W被动散热设计,适用于AI推理、视频分析等场景。选型需重点考量算力精度匹配度、内存配置、视频处理需求及部署兼容性,为AI计算需求提供新选择。
