- @Jsjendndn


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
安全访问中心 - 洛谷
云剪贴板 - 洛谷 | 计算机科学教育新生态 (luogu.com.cn)
把WPS卸载了之后就变成白色了,然后在注册表中把word的地址改成office word的地址之后图标变成这样了,怎么办。

很多初学深度学习的人,都能看懂代码、会调用优化器,但始终搞不懂最底层逻辑:损失函数到底有什么用?为什么求梯度、反向更新参数,就能让模型越来越准?本文从零拆解,讲透线性分类/神经网络通用的训练底层逻辑。当前位置下,自变量W小幅变动时,损失L的变化趋势与变化幅度。Loss:量化模型的错误程度;梯度:告知模型怎么调W会变得更差;梯度下降:反着梯度方向更新W,持续降低错误;所有神经网络、分类模型的训练,底
1:3表示左闭右开,::3表示三个一跳要想改变一个张量的形状而不改变元素数量和元素值,可以调用reshape函数X使用全0、全1、其他常量,或者从特定分布中随机采样的数字torch.randn(3, 4)正态分布常见的标准算术运算符(和**)都可以被升级为按元素运算dim=0在0维合并(按行),dim=1按列通过逻辑运算符构建二元张量X == Y对张量中的所有元素进行求和,会产生一个单元素张量X.
结构大体是。
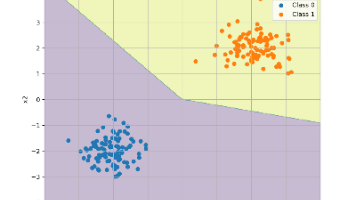
很多初学深度学习的人,都能看懂代码、会调用优化器,但始终搞不懂最底层逻辑:损失函数到底有什么用?为什么求梯度、反向更新参数,就能让模型越来越准?本文从零拆解,讲透线性分类/神经网络通用的训练底层逻辑。当前位置下,自变量W小幅变动时,损失L的变化趋势与变化幅度。Loss:量化模型的错误程度;梯度:告知模型怎么调W会变得更差;梯度下降:反着梯度方向更新W,持续降低错误;所有神经网络、分类模型的训练,底
仅负责分工与去重不负责画框。
这些指标从训练进度、训练拟合度、泛化性能、学习节奏看epoch知训练进度,看train/xxx知模型在训练集的学习效果;看知模型真实检测能力(最关键),看val/xxx判断过拟合;看lr/pg0~pg7知学习率调度是否合理,为超参数调整提供依据。先看和曲线类图片,判断模型整体性能(mAP、F1 是否达标);再看和,直观找检测问题(漏检、误检、框不准);最后用混淆矩阵和labels.jpg,定位具体