


- @INTSIG


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
近期,TextIn团队开发的PDF转Markdown插件已经上架Coze平台。今天我们抛砖引玉,介(an)绍(li)几种PDF转Markdown插件的有趣玩法!

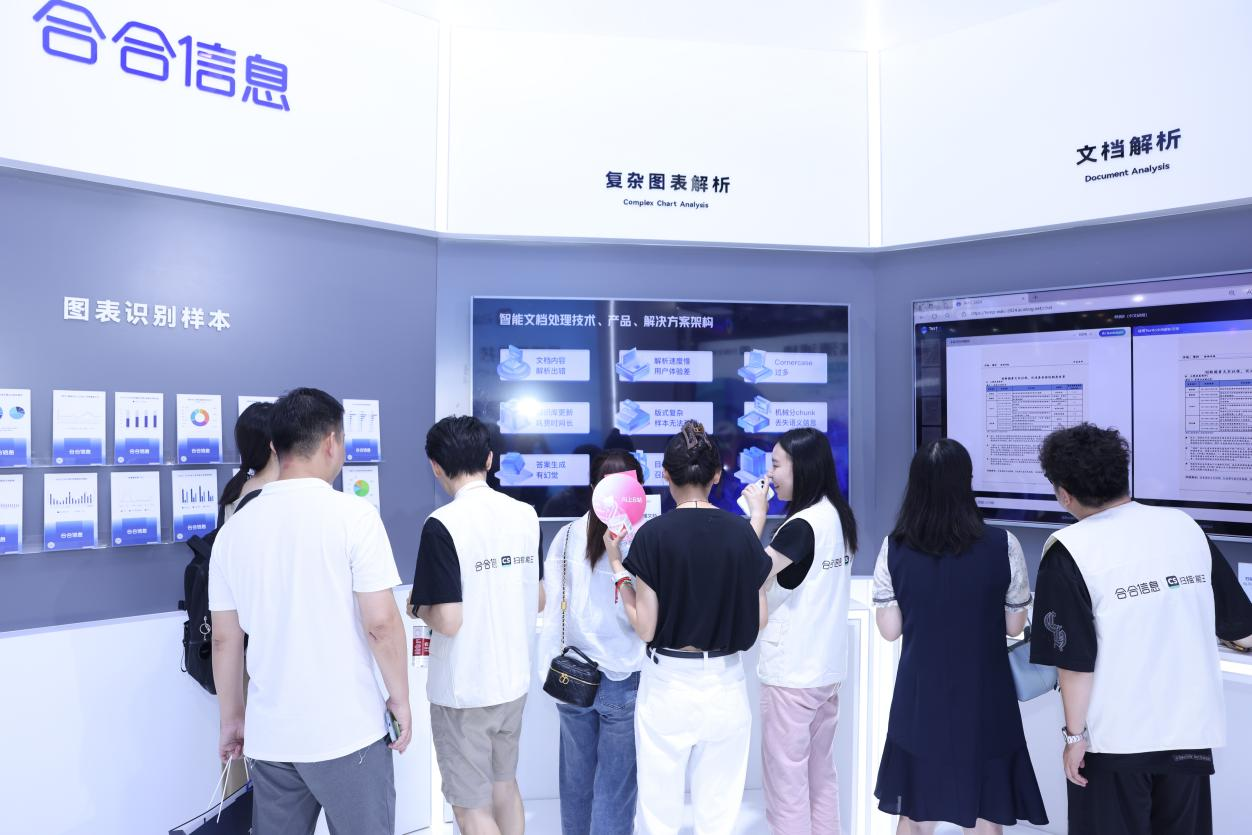
合合信息在2024waic上展示了大模型“加速器”解决方案。据了解,在大模型训练的上游阶段,“加速器”中的文档解析引擎将助力大模型突破在书籍、论文、研报等文档中的版面解析障碍,从源头为模型训练与应用输送纯净的“燃料”,助力大模型跑得更快;“加速器”还加载了行业领先的acge文本向量化模型,助力大模型解决“已读乱回”的“幻觉”问题,让大模型在正确的航线上行驶得更远。
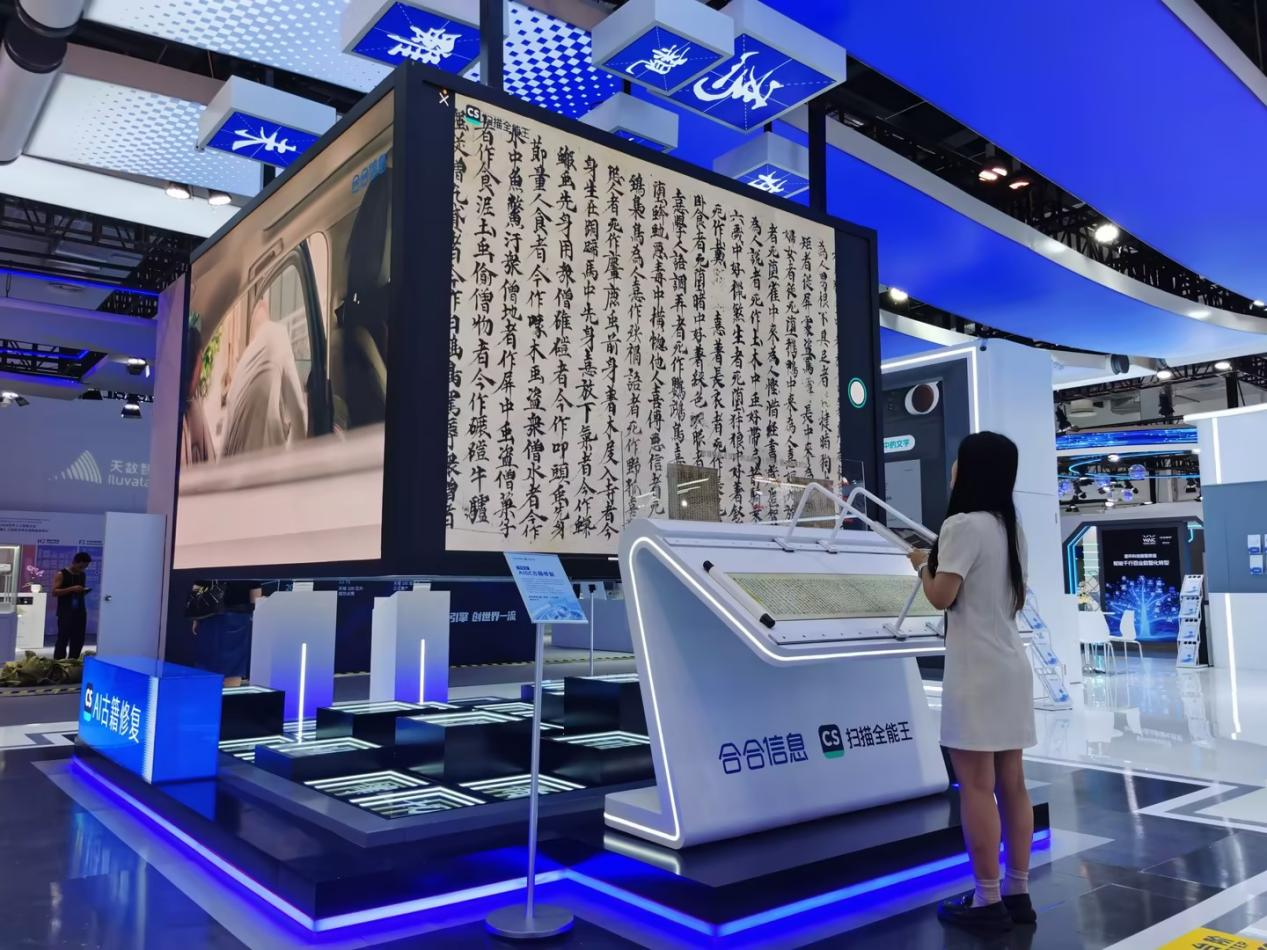
7月4日,2024年世界人工智能大会(简称“大会”)在上海举行。这次这场科技与创新的盛会上,一张古朴、典雅的卷轴吸引了众人的目光。这张被修复的卷轴脱胎于敦煌遗书系列古籍,在被机器拍摄扫描后,卷轴上脏污、笔画残缺、模糊的文字被准确定位,缺失的文字缓缓浮现,犹如一位隐形的书法家,在页面上行云流水般自然地“填空”。
大型语言模型(LLM)经历了显著的发展,并越来越多地跨各个领域集成。值得注意的是,在机器人任务规划领域,LLM利用其先进的推理和语言理解能力,基于自然语言指令制定精确和高效的行动规划。然而,对于机器人与复杂环境交互的具体化任务,由于与机器人视觉感知缺乏兼容性,纯文本LLM经常面临挑战。本研究提供了一个新兴的LLM和多模态LLM集成到各种机器人任务的全面概述。此外,论文还提出了一个利用多模式GPT-
打破“孤岛”,需要通过知识标准化来确保知识的一致性和可共享性,以连接不同的知识元素,形成一个网络,使得知识之间的关系和联系得以清晰展现,这也是知识图谱的价值。《白皮书》从技术、产业、政策等层面的核心需求出发,详细分析了知识图谱互联互通的内涵与外延、任务与约束、典型应用场景和实践案例,明确了开展和实施过程中面临的难点与挑战,提出了知识图谱互联互通的统一架构,并从技术发展、政策支持、标准化需求、产业推
从自然语言文本中获取结构化信息的研究最早开始于20世纪60年代中期,这被看作是信息抽取技术的初始研究,它以两个长期的、研究性的自然语言处理项目为代表。
在快速发展的人工智能(AI)领域中,生成式大型语言模型(llm)站在了最前沿,彻底改变了论文与数据交互的方式。然而,部署这些模型的计算强度和内存消耗在服务效率方面带来了重大挑战,特别是在要求低延迟和高吞吐量的场景中。本调查从机器学习系统(MLSys)研究的角度,解决了对高效LLM服务方法的迫切需求,这是先进人工智能创新和实际系统优化的关键。
第八届中国模式识别与计算机视觉学术会议(PRCV2025)聚焦多模态文本智能大模型发展,探讨前沿技术与应用。专家提出"多模态思维链"技术提升跨模态推理能力,OCR幻觉缓解方案优化文本感知。合合信息推出"多模态文本智能技术"方案,通过空间位置理解实现多模态信息立体化处理,已在金融、医药等领域应用。该技术突破传统文档处理局限,构建"感知-认知-决策"新范式,推动AI从工具向业务伙伴进化。小红书、甲骨文

摘要:中国信通院数据显示国内已发布大模型超1500个,推动技术落地成为行业关键。合合信息与火山引擎合作推出升级版"大模型加速器",通过高效文档解析技术解决企业非结构化数据处理难题,支持99.99%的复杂文档解析。平台提供分层服务方案:HiAgent面向企业定制化需求,Coze降低开发者门槛。支持多种部署方式,推动AI在医疗、金融等领域的应用落地,加速大模型从实验室走向实际生产。
赢取千元奖品!TextIn大模型加速器+火山引擎,多语言文档处理挑战营正式启动!
