


- @Hpc_Fun


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
更值钱的思路是反过来的:与其每次发之前才焦虑,不如搭一条"内容质检流水线",让 AI 写的东西在进"发布闸门"之前,就自动过一遍质量关。 这也是我这一篇想重点讲的。 二、先破除几个误区:AI 检测到底在查什么? 在搭流水线之前,先搞清楚平台到底怎么判内容的。这里有几个被广泛误解的点(也是我踩过坑、跟平台侧交流后确认的):
目录 本地微调大模型要多少显存?LoRA/QLoRA 单卡账与工作站选型 先说结论 一、先定方式,再谈显存 二、消费级显卡到底能不能微调 三、本地微调,给三档方案 四、写给想本地微调的人 五、写在最后 本地微调大模型要多少显存?LoRA/QLoRA 单卡账与工作站选型 面向想用个人/小团队电脑本地微
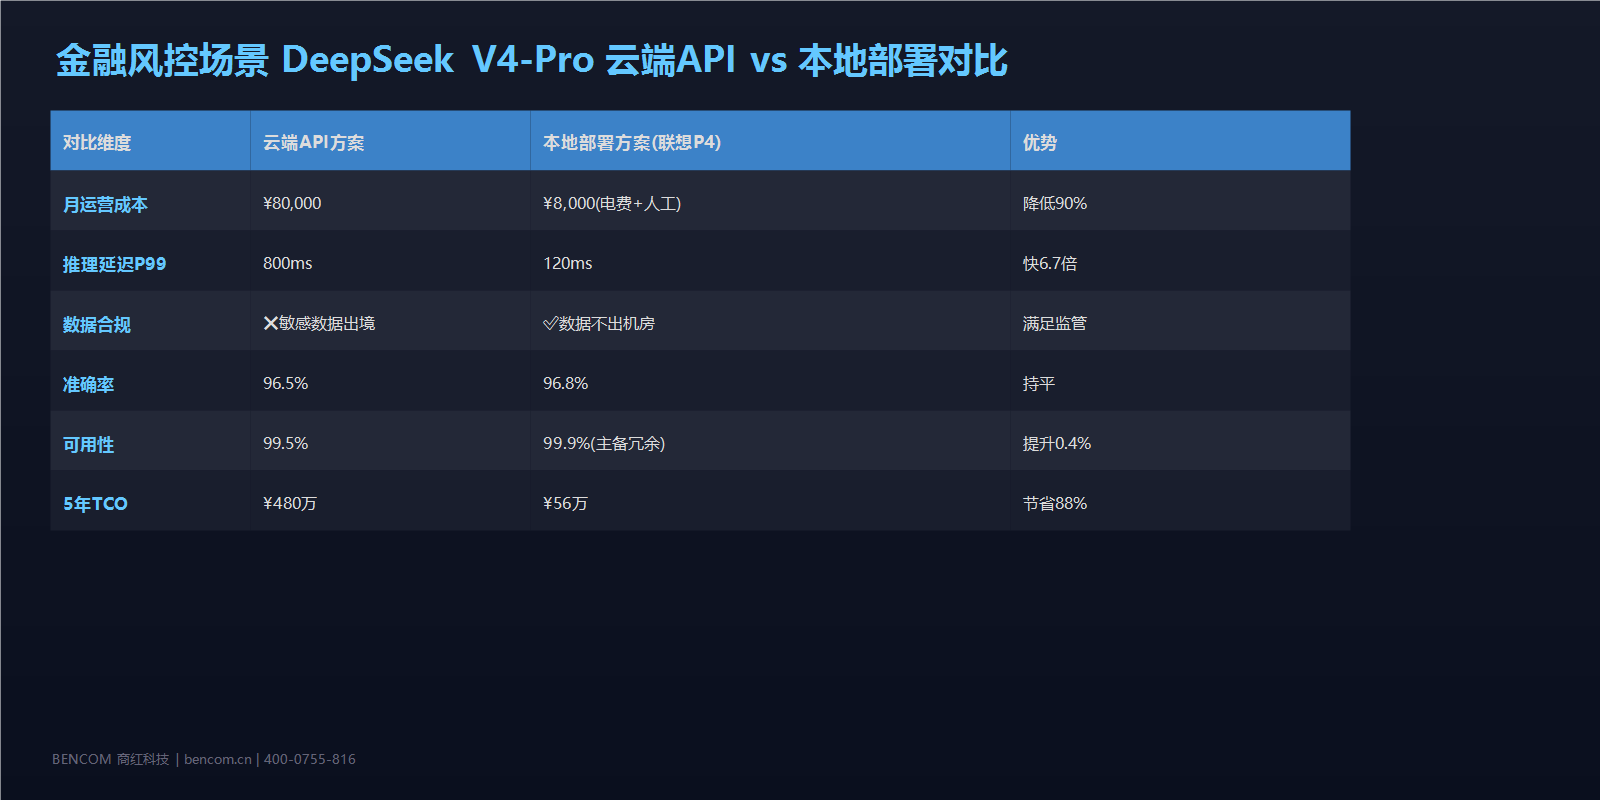
目录 金融风控场景 DeepSeek V4-Pro 本地部署:联想 ThinkStation P4 硬件架构与反欺诈推理实测 一句话看懂核心问题 金融行业为什么要把 DeepSeek V4-Pro 部署在本地? 痛点 1: 云端 API 调用成本不可控 痛点 2: 数据合规红线 痛点 3: 响应延迟
本文探讨了一种在企业内网部署DeepSeek-V4大模型的低成本高性能方案。针对FP16全精度推理需要1.3TB显存的难题,提出基于4张RTX 4090(96GB显存)的多卡工作站解决方案,通过张量并行实现INT8精度推理,效果接近FP16。文章详细拆解了硬件配置(联想ThinkStation PX工作站)、分布式推理架构(GPU分工策略)和vLLM张量并行实现,对比了单卡A100与多卡4090的

本文探讨了一种在企业内网部署DeepSeek-V4大模型的低成本高性能方案。针对FP16全精度推理需要1.3TB显存的难题,提出基于4张RTX 4090(96GB显存)的多卡工作站解决方案,通过张量并行实现INT8精度推理,效果接近FP16。文章详细拆解了硬件配置(联想ThinkStation PX工作站)、分布式推理架构(GPU分工策略)和vLLM张量并行实现,对比了单卡A100与多卡4090的
本文探讨了一种在企业内网部署DeepSeek-V4大模型的低成本高性能方案。针对FP16全精度推理需要1.3TB显存的难题,提出基于4张RTX 4090(96GB显存)的多卡工作站解决方案,通过张量并行实现INT8精度推理,效果接近FP16。文章详细拆解了硬件配置(联想ThinkStation PX工作站)、分布式推理架构(GPU分工策略)和vLLM张量并行实现,对比了单卡A100与多卡4090的
2026年《人工智能法》实施后,律所AI合同审查面临数据主权、客户保密和合规风险三重挑战。本文基于北京大成(昆明)律所、华商(柳州)律所等真实落地案例,系统解析为什么律所AI必须本地部署(五年TCO降低44%、数据不出本地、响应延迟<100ms),以及如何选择异构算力一体机方案(GPU+NPU混插、全液冷、开箱即用)。涵盖算力需求评估、DeepSeek/ChatGLM模型选型、数聚红芯HG8380
2026年《人工智能法》实施后,律所AI合同审查面临数据主权、客户保密和合规风险三重挑战。本文基于北京大成(昆明)律所、华商(柳州)律所等真实落地案例,系统解析为什么律所AI必须本地部署(五年TCO降低44%、数据不出本地、响应延迟<100ms),以及如何选择异构算力一体机方案(GPU+NPU混插、全液冷、开箱即用)。涵盖算力需求评估、DeepSeek/ChatGLM模型选型、数聚红芯HG8380
选 AI 工作站不是比配置参数,而是比业务匹配度。一台参数拉满但办公室噪音 70dB 的机器,远不如一台经过出厂调优、静音稳定、开箱即用的整机工作站更能支撑你的电商业务。本文基于 2026 年 7 月主流 AI 出图工具(Stable Diffusion / FLUX / ComfyUI)的硬件实测数据、社区反馈及电商场景实际需求分析撰写。具体产品配置和价格以厂商官网最新信息为准。想了解文中提到的

信创过渡期,纯GPU过不了考核、纯NPU迁移成本太高。数聚红芯HG8380G把英伟达GPU和昇腾NPU塞进同一台整机,提供第三条路。本文从混插技术挑战、信创采购逻辑、同类方案对比和选型确认清单四个维度做选型分析。