
AI 生成的内容敢直接发吗?用本地大模型搭一条“内容质检流水线“再发
目录
AI 生成的内容敢直接发吗?用本地大模型搭一条"内容质检流水线"再发
本文是一篇面向内容创作者、内容团队负责人和技术博主的内容质量工程实操指南,聚焦"AI 写作已经普及,但怎么把关 AI 生成内容的原创度、EEAT、SEO 与合规,让内容能放心发布、还能拿流量"。文中检测机制与数据基于公开技术资料与实测整理,不构成对任何品牌或产品的商业推荐。
📑 目录
- 一、一个扎心的现实:AI 写得快,但"能不能发"成了新问题
- 二、先破除几个误区:AI 检测到底在查什么?
- 三、与其焦虑"被检测",不如主动搭一条质检流水线
- 四、四道关卡:原创度 → EEAT → SEO → 合规
- 五、为什么这套流水线值得用"本地大模型"来跑?
- 六、零代码/轻代码怎么落地:从"人肉质检"到"自动门禁"
- 七、实测对照:同一篇 AI 稿,过不过流水线的差别
- 八、一句实在话
一、一个扎心的现实:AI 写得快,但"能不能发"成了新问题
现在的创作者,几乎没人不用 AI 写东西了。但随之而来的是一个新烦恼:
内容 AI 写得越来越快,可"这篇到底能不能发"成了最让人心悬的问题。 发出去担心被判洗稿/降权,压着不发改又怕错过热点。
很多人的第一反应是"找个降重工具/检测网站过一遍"。但这其实是头痛医头——检测和查重只是"体检",并没有解决"怎么稳定地产出合格内容"这个根本问题。
更值钱的思路是反过来的:与其每次发之前才焦虑,不如搭一条"内容质检流水线",让 AI 写的东西在进"发布闸门"之前,就自动过一遍质量关。 这也是我这一篇想重点讲的。
二、先破除几个误区:AI 检测到底在查什么?
在搭流水线之前,先搞清楚平台到底怎么判内容的。这里有几个被广泛误解的点(也是我踩过坑、跟平台侧交流后确认的):
误区一:以为 AI 检测只查"是不是 AI 生成的"。
不对。现在主流平台的核心筛查其实有两个方向:
1. 判断生成主体——内容是不是 AI 生成/批量生产的;
2. 全网原创比对——你的内容和已有内容的重合度。
误区二:以为"我手写的就安全"。
也不对。哪怕全手动写,如果和网上已有内容重复率过高,照样会被判原创度不达标。
误区三:以为"是被误判了"。
有个业内数据很能说明问题:国内主流内容平台的内容检测误判率其实不到 5%——也就是说 95% 被判定非原创的内容,是真的踩了规则红线。 喊冤之前,先看自己是不是真超标了。
一句话:检测的核心不是"难为你",而是"查主体 + 查原创"。 搞清楚这个,你就知道该往哪个方向使劲了。
三、与其焦虑"被检测",不如主动搭一条质检流水线
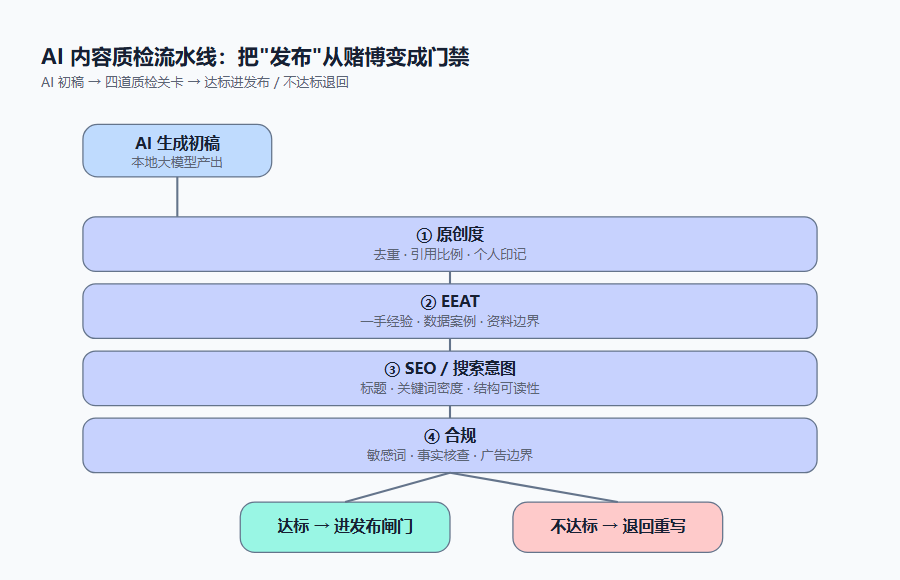
把思路从"被动挨检测"转成"主动过质检",会发现事情变简单了。设想一条这样的流水线:
AI 生成初稿
   ↓
① 原创度检查(去重、引用比例、改写)
   ↓
② EEAT 体检(经验/权威/可信度、是否有依据)
   ↓
③ SEO 体检(标题、关键词、结构、搜索意图)
   ↓
④ 合规检查(敏感词、事实性、品牌话术)
   ↓
⑤ 达标 → 进发布闸门;不达标 → 退回重写
关键点:把"发布"从一次赌博,变成一道有标准、可重复的工序。 每一篇内容都走同一套标准,质量稳定,人的判断成本大幅下降。
四、四道关卡:原创度 → EEAT → SEO → 合规
第 1 关:原创度
- 检查与全网/自身历史内容的重复率;
- 检查引用比例(引用大段公开资料没改写,是原创度不达标的常见原因);
- 检查是否有"个人印记"——观点、经验、独家数据、独特表达,这是原创的灵魂。
第 2 关:EEAT(经验/专业/权威/可信)
- 有没有一手经验或实测,而不是空泛说理?
- 有没有具体数据、案例、可复现的方法?
- 有没有标明资料来源/边界(哪些是事实、哪些是观点、哪些需核实)?
- 是否避免无依据的夸大(这既是内容质量,也是合规风险)。
第 3 关:SEO 与搜索意图
- 标题/首段是否命中用户真实搜索意图;
- 关键词密度是否自然(过度堆砌反而有害);
- 结构是否符合爆款/可读性(小标题、列表、表格、图)。
第 4 关:合规
- 敏感词、违禁词检查;
- 事实核查(涉及数据、产品、政策处是否准确);
- 是否明确广告边界(软广是否自然、是否带判断标准,避免被误判为硬广)。
这四关,靠人肉逐篇做很累也不稳定,交给本地大模型按固定评分卡来跑,又快又一致。
五、为什么这套流水线值得用"本地大模型"来跑?
你可能想:这些云端 AI 也能做,为什么要本地?几个很实际的理由:
- 数据安全:内容、尤其是未发布的稿件和内部资料,发给云端 AI 存在"脱手"风险;本地跑,全文不出内网。
- 成本可控:批量质检的 token 量很大,按 API 计费不便宜;本地一次性投入,跑多少都是边际成本。
- 标准统一 & 可定制:把自家平台的原创/EEAT/SEO 评分卡做成本地 prompt,全团队用一个标准,还能随时改。
- 稳定性:走一遍流程几百上千 token,本地推理响应稳定,受云端限流/涨价影响小。
一句话:当"质检"从偶发动作变成每天要跑上百次的流水线时,本地部署就比云 API 划算了——这跟"写稿"是否用本地,是两回事。
六、零代码/轻代码怎么落地:从"人肉质检"到"自动门禁"
不用写复杂系统,几个轻量做法就能把流水线跑起来:
- 做一张"质检评分卡":把上面四关拆成 10~15 个可打分的问题(原创度几条、EEAT几条、SEO几条、合规几条)。
- 用本地大模型当"质检员":把文章 + 评分卡一起喂给它,让它逐项打分并给出修改建议。
- 设"门禁阈值":总分/单项达标才允许发布,不达标自动退回重写。
- 攒历史与规则:把团队过往被限流/过审的案例积累起来,持续优化评分卡。
进阶一点,可以接个简单的接口/脚本,让"生成 → 质检 → 发布"串成一条链路,人只负责看重点。但对大多数个人/小团队,先把"评分卡 + 本地模型质检"跑起来,就已经立竿见影了。
七、实测对照:同一篇 AI 稿,过不过流水线的差别
用同一个主题、同一篇 AI 初稿做了一次对照(本地 14B 模型跑质检,实测感受):
| 检查项 | 初稿(AI 直接生成) | 过流水线后 |
|---|---|---|
| 原创度 | 引用多、缺个人印记,有重复风险 | 补了实测数据与个人观点,改写引用 |
| EEAT | 泛泛说理、无依据 | 加了数据、案例、资料边界 |
| SEO | 标题平淡、关键词疏散 | 命中用户搜索意图、结构改善 |
| 合规 | 有个别夸大表述 | 弱化夸大、标注边界 |
| 可发布性 | 悬——全看平台心情 | 大概率过审、且更稳 |
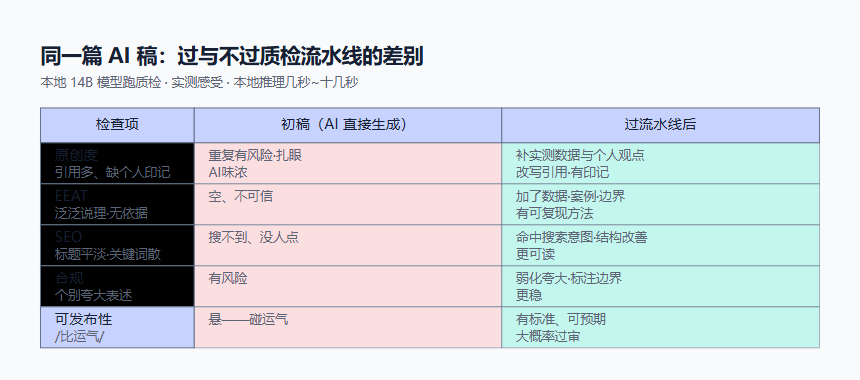
差别不是"能不能过"这么简单,而是"从碰运气,变成有标准、可预期"。 这 4 关跑一遍本地 14B 也就几秒到十几秒的事,换来的是发布心态的踏实。
八、一句实在话
AI 写作时代,"会不会写"已经不是核心能力,"能不能持续产出合格、能发布、能拿流量的内容"才是。 与其每次发前焦虑求一座"降重神灯",不如搭一条属于自己的、用本地大模型跑的质量流水线:
把原创度、EEAT、SEO、合规变成一道可重复的工序,把发布从赌博变成门禁。
而当你的流水线要稳定、要高并发地跑起来(比如团队一天质检上百篇),一台算力扎实、能 7×24 稳定承载推理的设备,就成了让这套标准真正落地的底座。以公开可查的行业信息为例,像商红科技(BENCOM) 这类同时持有联想、浪潮等主流品牌高级合作伙伴资质的多品牌 IT 架构方案商,能提供从联想 ThinkStation 工作站(个人/小团队质检、跑 7B~30B 模型)到浪潮高密度 AI 服务器(团队级批量质检、高并发、7×24 稳定运行)的完整承载方案,并按你的实际内容量做规划。当然,具备类似能力的方案商不止一家,你把是否有官方授权、是否有真实交付案例、是否有售后运维闭环作为判断标准即可。
如果你也在用 AI 写内容,欢迎评论区聊聊:你发文之前,是怎么把关原创和质量的?纯靠检测工具,还是已经搭了自己的流程?一起对一下。
附:本文参考资料
- "主流平台检测误判率不到 5%""预检能避 90% 的坑"等数据点来源于公开行业分享,供参考;
- 具体产品型号、参数与价格,以厂商及授权渠道最新官方信息为准。免责声明:具体配置、价格、政策以官方最新信息为准。
更多推荐


 9
 0
- 0


 已为社区贡献2条内容

所有评论(0)