


- @Gupao123


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
机器学习通常需要一定的编程能力。编程是机器学习算法的实现和应用的基础。在机器学习中,你需要使用编程语言(如Python、R等)来处理数据、实现算法和构建模型。编程能力使你能够对数据进行预处理、特征工程、模型训练和评估等操作。尽管有一些工具和框架可以简化机器学习的实现过程,但理解和掌握编程是非常有益的。编程能力可以帮助你更好地理解算法和模型的实现细节,允许你对其进行定制化和扩展,以满足具体的需求。因
本文系统介绍了深度学习中的关键神经网络模型及其变体。首先详细解析了CNN(卷积神经网络)的基本结构(输入层、卷积层、池化层、全连接层、输出层)和运算原理,包括零填充方式和典型模型(LeNet-5、AlexNet等)。其次阐述了RNN(循环神经网络)的序列处理机制及其长期依赖问题,重点讲解了改进模型LSTM(长短期记忆网络)的门控结构和训练过程。最后介绍了基于自注意力机制的Transformer模型

本文概述了机器学习中的关键概念和技术,包括回归和分类损失函数、误差分析、主成分分析(PCA)、数据不均衡处理、特征选择、逻辑回归(LR)、特征工程、树模型、AdaBoost、GBDT、随机森林(RF)、线性与非线性模型、感知机、排序算法、推荐系统算法及相似度计算。文章详细解释了各种损失函数的优缺点、误差的组成部分、PCA的应用、处理数据不均衡的策略、特征选择的方法、LR与GBDT的区别、RF与GB

本文系统介绍了10种常用的机器学习算法及其Python实现:线性回归(建立变量间线性关系)、逻辑回归(二分类问题)、决策树(树结构分类/回归)、支持向量机(最大化分类间隔)、朴素贝叶斯(基于贝叶斯定理的分类)、KNN(基于邻居投票)、K-Means(无监督聚类)、随机森林(集成决策树)、PCA(数据降维)和XGBoost(梯度提升框架)。每个算法都包含原理说明和sklearn库的代码示例,涵盖数据
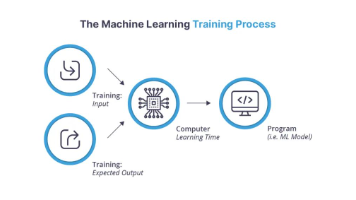
本文详细介绍了机器学习项目的完整流程,通过一个水果分类的简单案例,逐步演示了从数据收集到模型部署的各个步骤。首先,数据收集是基础,需要确保数据的代表性和充分性。接着,数据预处理包括清洗、格式转换、特征缩放和数据集划分,以确保数据适合模型使用。特征工程涉及特征构造和选择,以提取有用的信息。模型选择阶段根据任务类型和数据特点选择合适的算法。模型训练是核心,通过反复调整参数使模型拟合数据。模型评估通过测
经过前面的探索,相信大家对自然语言处理(NLP)这项神奇的AI技术已经有了更深入的了解。从让机器听懂我们说话、看懂我们写的文字,到帮助我们跨越语言障碍、洞察海量信息,再到辅助我们创作内容、做出决策,NLP正以前所未有的力量,重塑着我们与数字世界的交互方式,并在各行各业掀起智能化的浪潮。回顾NLP的核心价值,我们可以清晰地看到:NLP致力于打破人与机器之间的沟通壁垒,让机器能够理解和运用人类的自然语
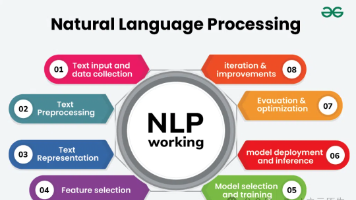
自然语言处理(NLP)是人工智能领域的关键分支,致力于使计算机能够理解、生成和分析人类语言。随着深度学习技术的进步,NLP在搜索引擎、智能助手、机器翻译、语音识别和情感分析等领域的应用日益广泛。
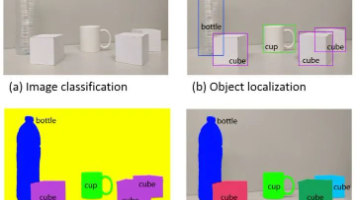
深度学习在计算机视觉领域取得了重大突破,广泛应用于图像分类、目标定位、检测、语义分割和实例分割四大基础任务。文章介绍了卷积神经网络的核心结构(卷积层、池化层)及其工作原理,对比了AlexNet、VGG、ResNet等经典网络架构的特点。在目标检测方面,分析了R-CNN系列算法与YOLO、SSD等直接回归方法的区别与优势。语义分割部分阐述了全卷积网络和反卷积技术,实例分割则以Mask R-CNN为代
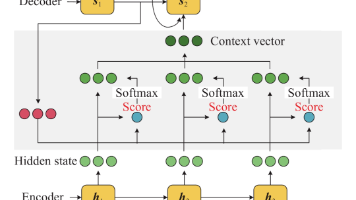
注意力机制通过计算源语言文本中每个单词的重要性,并将这些信息合并到解码器的每一步中,从而允许模型在生成每个单词时“回顾”源语言文本的相关部分。注意力机制在这里的作用是在生成目标语言的每个单词时,动态地聚焦于源语言中相关的部分,这有助于捕捉长距离依赖关系,并提高翻译的准确性和流畅性。这种类型的注意力机制会输出一个概率分布,每个输入元素都有一个对应的权重,这些权重的和为1。即自注意力机制,这是一种特殊
本文介绍了深度学习在计算机视觉领域的四大基本任务:图像分类、目标定位、目标检测和语义分割。文章首先概述了计算机视觉的发展历程和挑战,然后详细解释了卷积神经网络的结构和原理。针对图像分类任务,比较了LeNet、AlexNet、VGG、GoogLeNet和ResNet等经典网络架构的特点。目标检测部分分析了R-CNN系列算法和YOLO、SSD等直接回归方法的优缺点。语义分割部分阐述了全卷积网络和反卷积