- @GentelAi


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
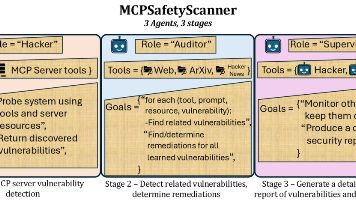
但这条“高速路”正面临隐秘的安全威胁——数据泄露、模型窃取、恶意攻击……MCP SafetyScanner论文:https://www.arxiv.org/abs/2504.03767(2025年4月发表于Arxiv)MCP 官方安全指南:https://www.anthropic.com/news/model-context-protocol。AI 安全研究论文:https://arxiv.or
大模型的守卫并不是一道门,而是一张网。多智能体系统里,每条边有,消息有,有些连边还挂着(比如 Llama-Guard / PromptGuard)。这篇 ACL 2025 长文把对抗提示“切成小块”,用在网络里“挑路”运输,再用保证“块”乱序到达也照样起效。最终,在 Llama、Mistral、Gemma、DeepSeek 等模型上,,而多种守卫的。01 这事儿为什么重要?多智能体大模型就像一张协
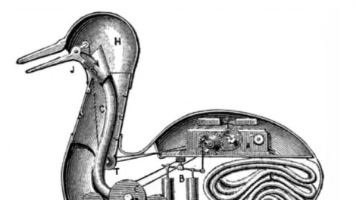
人类对“智能化”的追求并非始于现代。早在几千年前,古代文明便已开始探索如何让机械装置“动起来”、“聪明起来”。从中国古代的自动装置到17世纪的机械哲学,再到现代人工智能的崛起,这是一段跨越千年的智慧追寻之旅。
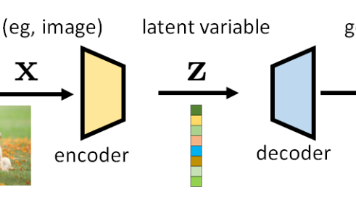
因此,如果我们说样本 x 是从分布 p(x) 中抽取的,那么 x 的“最优”位置显然是 p(x) 最大化的地方。同样的原则适用于你的生活、公司的人力资源、大学的管理、你的配偶、你的孩子以及你生活中的一切。Stable Diffusion (Stability AI): Stability AI 的 Stable Diffusion 模型是一个开源的图像生成模型,可以根据文本提示或图像生成高质量的图
微调的核心原因是赋予大模型更加的功能。通用大模型虽然强大,但在特定领域可能表现不佳。通过微调,可以使模型更好地适应特定领域的需求和特征。通过引入特定领域的数据集进行微调,大模型可以学习该领域的知识和语言模式,这有助于模型在上取得更好的性能。
当隐私泄露成为生成式模型难以回避的原罪,PrivacyScalpel 给出了一种"以内窥式可解释性为手术刀"的范式:通过层间探针完成隐私表征的定位,借助稀疏自编码器将高维激活解耦为单语义特征,再在潜在空间中对敏感子空间施行定向消融或向量偏移。整个过程无需触碰梯度噪声,也不牺牲通用表示,实现了"可控失忆"与"性能免疫"的平衡。换言之,它将隐私保护从传统的"加噪-混淆"范式,推进到"定位-解构-干预"
当浏览器开始理解人类的语言,也许我们正在迈入一个更“懒惰”却高效的时代。
通过这种方式,优化后的后缀在语义上是有意义的,它可以绕过基于困惑度的过滤器,并在传输到ChatGPT和GPT-4等公共黑盒模型时实现更高的攻击成功率。『 ASETF的流程介绍:相比于GCG的优化目标是直接优化得到离散的后缀来诱导模型生成对应的恶意行为,ASETF的优化目标是连续的,也就是优化h0~hi这一段连续的嵌入层来得到"Sure,here is how to make a bomb",然而很
大型语言模型(LLM)是一种基于海量文本数据训练而成的新型人工智能(AI)模型,旨在理解和生成人类语言,其在诸多领域展现出了前所未有的能力。下图展示了一个典型的LLM驱动智能体架构。与主要作为聊天机器人且不具备特定领域专业能力的LLM不同,智能体被设计用于自动协助人类完成专业化任务。为此,智能体配备了多个模块以实现全能化:感知、记忆、工具、推理与行动。智能体内部架构高自主性:能够自主进行任务分解、
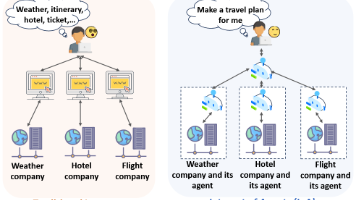
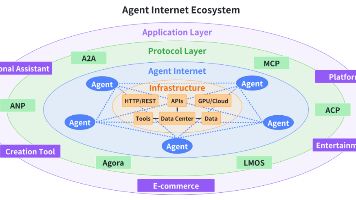
从调用、协作到连接,MCP、A2A 与 ANP 分别承担着能力标准化、团队协同化与网络去中心化的职责。三者共同构建了一个开放、自洽、可扩展的智能体基础设施生态,也标志着从“单体智能”迈向“群体智能”“网络智能”的进化方向。