- @DeepLink_2025


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
多维公平性建模:首次将多资源、完成时间、长期公平三大维度融合为统一目标函数,通过权重动态调整适配不同场景,解决传统方案 单一维度偏科问题;异构资源适配:引入资源效能系数,量化不同 GPU 的性能差异,使公平性评估更贴合实际异构集群环境;智能优化融合:结合改进 DRF、遗传算法、强化学习,形成静态分配 + 动态优化的分层架构,既保证初始分配的公平性,又能实时适配集群负载变化;
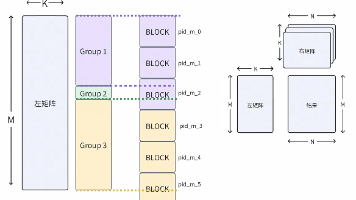
Grouped MatMul 的难点还在于如何根据 Device Tensor 中的分组信息组织不规则任务。本文以 M 轴分组为例,分析预计算映射在 Ascend 910B 上引入约 1 ms 额外开销的原因,并通过 24 个常驻 program 将不同 Group 的输出 tile 组成连续任务流,减少 Host 同步、Kernel Launch 和组尾 Core 空闲;随后使用对角线 Swiz
我们使用了逐算子、逐 module 层精度对比工具,以及 loss 曲线比对的方式,排查分析了大模型微调时下游评测精度在 A2 和 CUDA 对不齐的问题。经分析发现和rms_norm存在精度问题,在使用非和使用组合的rms_norm后,loss 曲线可以和 CUDA 对齐,且下游评测任务的平均得分和 CUDA 基本一样。如果你喜欢我们的内容,欢迎我们!也欢迎在评论区与我们互动!你的支持是我们持续

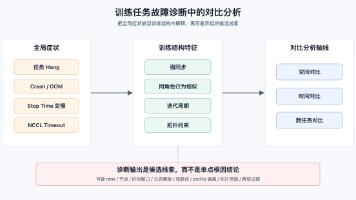
本文探讨了大模型训练任务故障诊断中的对比分析方法。训练任务的强同步特性使得局部故障会扩散为全局异常,导致用户观察到的症状(如程序挂起、训练崩溃或性能下降)与根本原因(如单个节点或GPU的硬件故障)之间存在较大差距。文章提出利用训练任务的同质性、周期性和拓扑结构特征,通过空间对比(不同rank或节点的行为差异)、时间对比(同一rank在不同迭代中的表现差异)和跨任务对比(失败任务与成功任务的差异)三
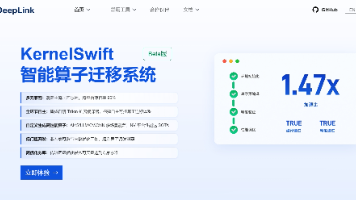
KernelSwift 把 “大模型偶尔写出好算子” 的偶然事件,变成 “持续、可复现、高性能” 的必然结果。其通过可控的优化迭代框架、分层的反馈体系、多样化的探索策略,让大模型真正成为算子优化的 “智能助手”,结合DeepLink芯片适配的基础和技术能力,既降低了底层优化的技术门槛,又持续推高 AI 系统的性能上限。未来,随着数据飞轮的持续转动,KernelSwift 还将在更多算子场景、更多硬
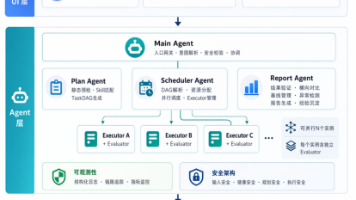
为解决传统AI评测人工成本高昂、技术门槛高、跨芯片适配难等痛点问题,DeepLink团队推出多智能体协作的自动化评测方案,构建多智能体协作机制,实现AI软硬件评测的全流程自动化,能够显著提升评测效率。此外,团队在近日开源了 AI 全环节软硬件验证技能库(DeepEval-Skills),作为验证平台的核心工具之一,DeepEval-Skills已适配多款国内外主流AI芯片,覆盖 NLP、CV、多模
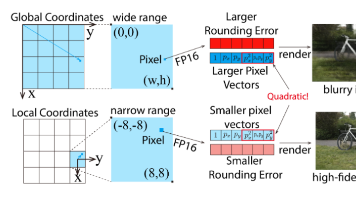
3D高斯泼溅(3DGS)凭借出色的渲染质量和速度,已成为三维重建、具身智能等领域的当红技术。然而,当场景规模扩大或分辨率升至4K时,即使3DGS也难以维持实时帧率。现有优化多从算法角度压缩高斯数量或简化光栅化,却忽略了更根本的问题:3DGS的渲染管线与硬件特性并不匹配。本文从硬件加速角度:将Alpha混合过程映射为矩阵乘法,让Tensor Core真正参与3DGS渲染,并设计G2L坐标变换解决FP
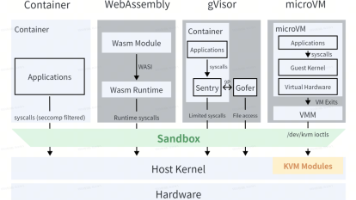
随着AI Agent从实验环境走向生产环境,Sandbox沙箱技术成为保障系统安全的核心基础设施。本文从“为什么需要”到“如何实现”再到“怎么选”:介绍 Agent Sandbox 的需求背景,在集群中如何提供规模化Sandbox 服务,最后探讨底层 Sandbox Runtime 技术路线并给出选型建议。
近日,上海人工智能实验室(上海AI实验室)升级并开源DeepLink多元算力混合推理技术方案,在此前仅支持多国产芯片的基础上,拓展NVIDIA 等芯片跨架构混合推理能力,满足多类推理场景需求。为便于方案落地,上海AI实验室联合八家国产芯片厂商推出标准化推理镜像,开发者下载即可快速部署;开源上述方案核心技术——智能流量路由系统DLRouter,助力行业低成本构建高吞吐、低时延的异构推理服务。
本文探讨了Agent时代存储优化的新思路。在上篇的基础上,下篇主要介绍运用超80万条文本片段进行的动态控制实验,基于Agent的局部性特征进行存储方案优化,成功提升了引用的效率,最终可以让模型容易进行引用而不是生成,从而让Agent执行任务变得更便宜。在本篇中详细介绍了在“紧凑布局”和“自适应索引”这两个优化方向上的探索与实验发现,并提出了在生产环境中的工程建议及未来优化方向!