


- @2501_92593481


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
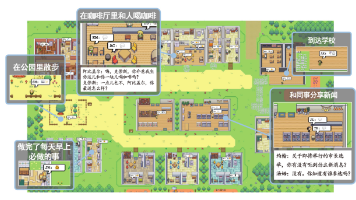
大模型的出现,为Agent装上了一颗真正意义上的“大脑”。这颗大脑拥有海量世界知识、强大的推理能力、灵活的泛化能力,以及不断自我提升的潜力。尽管目前Agent仍处于炒作周期的顶峰,商业化产品尚未成熟,但技术突破的浪潮已经不可阻挡。从斯坦福的虚拟小镇到企业的智能客服,从鲜花海报的自动配文到未来的机器人“小棉袄”,Agent正在从科幻走向现实。它们不再是简单的工具,而是能够感知、决策、行动,并与人类协
大模型赋予Agent的规划和决策能力,正在重新定义人工智能的边界。从思维链的线性推理到思维树的多元探索,从ReAct的循环交互到Reflexion的经验反思,这些技术共同构成了Agent智能的核心骨架。关键在于理解这些能力的协同作用:任务分解让复杂问题变得可管理,外部规划器提供精确计算能力,自我反思实现持续改进,ReAct框架确保动态适应性,工具调用扩展行动范围。当这些能力有机结合,Agent就不
当所有任务都完成后,Agent会对整个过程进行总结,生成最终的答案或解决方案。这个总结不仅包含结果,还可能包括执行过程中的关键决策点和经验教训。Agent技术的崛起,标志着AI从“对话者”向“行动者”的转变。通过规划、记忆、工具和执行四大要素的协同工作,Agent能够以结构化和分步的方法处理复杂问题,让解决方案变得更加清晰和可管理。正如小雪所说,Agent的工作方式和我们人类做事一样,需要不断反思
预训练记忆是大模型的基础,通过海量数据学习形成存储在神经元权重中的长期记忆,类似于人类的通识教育。这部分记忆容量巨大,但更新困难,且可能包含过时信息。上下文互动是模型的即时工作记忆,在对话过程中临时存储信息,优先级最高,但容量有限。这是模型实现连贯对话的关键。微调记忆是专业领域的强化训练,让模型在特定任务上表现更出色,类似于职业培训。它需要平衡专业性和通识能力,避免灾难性遗忘。外部记忆系统则是模型
咱们要聊Agent的思考方式,就绕不开一个名字——ReAct。你可以把它理解成Agent思考模式的“地基”或者“原神开局”。这词儿是“Reason”(推理)和“Act”(行动)的合体。说白了,就是让AI一边思考,一边行动,一边观察结果,然后再接着思考。想象一下,你是一个客服。用户说:“我手机话费好像扣多了,帮我查查。你怎么做?思考:用户要查话费账单。行动:打开计费系统,输入用户手机号。观察:系统返

先纠正一个误区:这里的React不是前端那个React。(推理+行动)。这个概念是由Shunyu Yao等人在ICLR 2023的论文《ReAct: Synergizing Reasoning and Acting in Language Models》中提出的。让大模型在思考中行动,在行动中思考,形成闭环。观察 → 思考 → 行动 → 再观察 → 再思考 → 再行动 → …… → 最终答案思考(

LangChain的崛起,标志着大模型应用开发从“手工作坊”迈向了“工业化生产”。它通过标准化、模块化的设计,大幅降低了AI应用的开发门槛,让更多开发者能够参与到这场技术变革中来。当然,工具再好,也只是工具。真正的价值在于你用它解决了什么问题,创造了什么价值。如果你正在考虑构建自己的大模型应用,不妨从LangChain开始——它可能会给你带来意想不到的惊喜。
通过合理利用现有的大语言模型、代码解释器和图像生成模型,我们完全可以搭建一个自动生成PPT的系统。它不仅能处理数据、提炼观点,还能生成图表和配图,最后输出一份完整的演示文稿。让AI承担重复性、技术性的工作,而人类专注于创意和决策。如果你也经常被PPT制作困扰,不妨动手尝试一下——用技术解放自己,把时间留给更有价值的事。技术不应该是高高在上的概念,而应该是触手可及的工具。当AI开始帮我们做PPT的时

说了这么多,我们来总结一下。为什么你应该关注LlamaIndex?如果你80%的需求是做“文档问答”和“知识库RAG”,LlamaIndex的学习成本远低于LangChain,但效率却高出一大截。它对数据的隔离、索引和检索设计得极其优雅,天生适合企业级应用。高级API 5行代码就能跑通流程,底层API又支持高度自定义,不管是新手还是老手都能找到自己的位置。它和LangChain不是有你没我的关系。
纵观大语言模型的构建、扩展与演变,我们不难发现,这不仅仅是一场技术的竞赛,更是一场对人类认知边界的探索。大模型之所以强,是因为它通过“压缩世界知识”,学会了世界的统计规律。通过“扩展法则”,我们掌握了量化性能提升的方法论。通过“涌现能力”,我们看到了AI向通用人工智能迈进的无限可能。大模型并非无所不能。它们依然存在“幻觉”(一本正经地胡说八道)、存在逻辑漏洞,且极度依赖数据质量。随着算力成本的下降