


- @2403_88702297


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
支持向量机(Support Vector Machine, SVM)是一种经典的监督学习模型,核心用于分类任务,也可通过改造用于回归(支持向量回归,SVR)。它的核心思想是:在特征空间中找到一个最优超平面,将不同类别的样本分开,且使两类样本到超平面的间隔最大化。标准化后,所有特征都转换为均值为0、方差为1的分布,这有助于提高模型的收敛速度和性能。SVM 在小样本、高维特征场景下表现优异,是机器学习
值得注意的是,这个假设大幅降低了计算复杂度,让算法能处理高维特征,但也牺牲了一定的精度(现实中特征往往存在关联)。P(Y∣X):后验概率,即已知特征 X 时,样本属于类别 Y的概率(模型最终要计算的目标);P(Y):先验概率,即类别 Y在训练集中出现的概率(无任何特征信息时的类别概率);P(X):证据因子,即特征 X出现的总概率(对所有类别来说是常数,计算时可忽略)。P(X|Y):似然概率,即已知
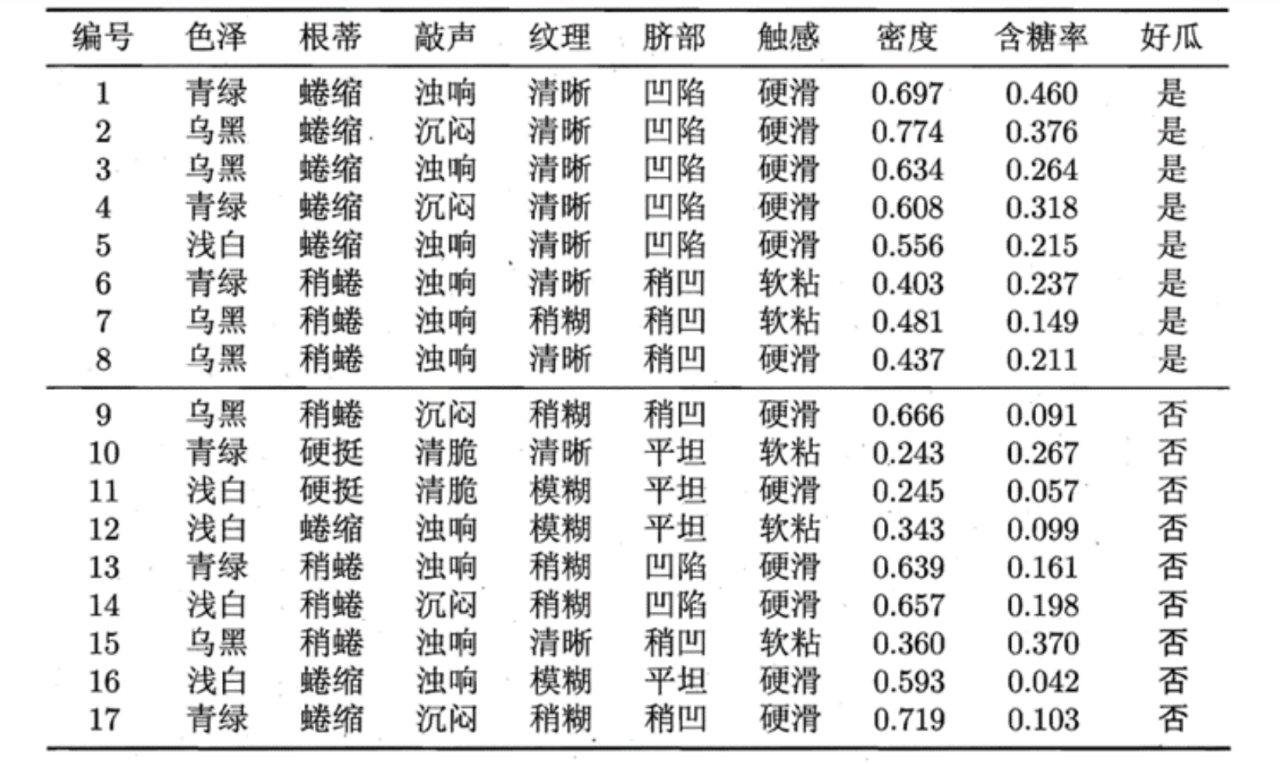
对于决策树的某个结点来说,对样本进行分类后可以使样本集尽可能有序,最大程度地降低样本数据的熵。决策树的关键是如何选择最优特征进行节点划分,目标是让划分后的子集尽可能 “纯净”(即同一子集内的数据类别尽量一致)。—— 通过对数据特征的层层判断,将复杂问题拆解为一系列简单的二元或多元判断,最终得出结论。对信息增益做了归一化修正,引入 “分裂信息”(衡量特征取值的均匀程度)。基于基尼不纯度(衡量数据被分
我们很容易发现,当计算样本之间的距离时数字差值最大的属性对计算结果的影响最大,也就是说,每年获取的飞行常客里程数对于计算结果的影响将远远大于上表中其他两个特征-玩视频游戏所耗时间占比和每周消费冰淇淋公斤数的影响。现需要实现将一个待分类样本的三个特征值输入程序后,能够识别该样本的类别,并且将该类别输出。该网站现在需要尽可能向海伦推荐她喜欢的人,需要我们设计一个分类器,根据用户的以上三种特征,识别出是
后剪枝的操作顺序是 从叶节点→内部节点→根节点,逐层向上检查每个子树是否需要剪枝,具体步骤如下:确定剪枝候选对象,遍历完整决策树的所有非叶节点(即内部节点),把每个内部节点及其下属的所有分支看作一个 “待剪枝子树”。1)如果 操作 B 的误差 ≤ 操作 A 的误差:说明剪掉该分支后,模型在验证集上的性能没有下降,甚至更好,此时执行剪枝(保留操作 B 的叶节点)。将该子树的根节点(内部节点)直接替换
对于决策树的某个结点来说,对样本进行分类后可以使样本集尽可能有序,最大程度地降低样本数据的熵。决策树的关键是如何选择最优特征进行节点划分,目标是让划分后的子集尽可能 “纯净”(即同一子集内的数据类别尽量一致)。—— 通过对数据特征的层层判断,将复杂问题拆解为一系列简单的二元或多元判断,最终得出结论。对信息增益做了归一化修正,引入 “分裂信息”(衡量特征取值的均匀程度)。基于基尼不纯度(衡量数据被分
支持向量机(Support Vector Machine, SVM)是一种经典的监督学习模型,核心用于分类任务,也可通过改造用于回归(支持向量回归,SVR)。它的核心思想是:在特征空间中找到一个最优超平面,将不同类别的样本分开,且使两类样本到超平面的间隔最大化。标准化后,所有特征都转换为均值为0、方差为1的分布,这有助于提高模型的收敛速度和性能。SVM 在小样本、高维特征场景下表现优异,是机器学习
后剪枝的操作顺序是 从叶节点→内部节点→根节点,逐层向上检查每个子树是否需要剪枝,具体步骤如下:确定剪枝候选对象,遍历完整决策树的所有非叶节点(即内部节点),把每个内部节点及其下属的所有分支看作一个 “待剪枝子树”。1)如果 操作 B 的误差 ≤ 操作 A 的误差:说明剪掉该分支后,模型在验证集上的性能没有下降,甚至更好,此时执行剪枝(保留操作 B 的叶节点)。将该子树的根节点(内部节点)直接替换