
机器学习之knn算法实现约会网站
一、问题引入
海伦一直使用在线约会网站寻找适合自己的约会对象。她曾交往过三种类型的人:
- 不喜欢的人
- 一般喜欢的人
- 非常喜欢的
这些人包含以下三种特征
1. 每年获得的飞行常客里程数
2. 玩视频游戏所耗时间百分比
3. 每周消费的冰淇淋公升数
该网站现在需要尽可能向海伦推荐她喜欢的人,需要我们设计一个分类器,根据用户的以上三种特征,识别出是否该向海伦推荐
二、需求概要分析
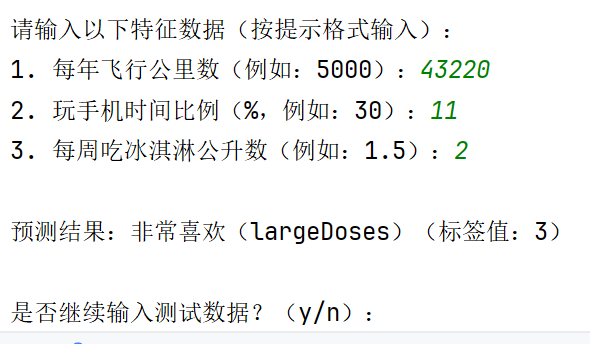
根据问题,我们可知,样本特征个数为3,样本标签为三类。现需要实现将一个待分类样本的三个特征值输入程序后,能够识别该样本的类别,并且将该类别输出。
三、程序结构设计说明
根据问题,可以知道程序大致流程如下。
其中输入数据应包含三个值,输出应为喜欢,一般,不喜欢,三个中的一个。
四、K近邻算法的一般流程
1. 数据准备:这包括收集、清洗和预处理数据。预处理可能包括归一化或标准化特征,以确保所有特征在计算距离时具有相等的权重。下图为部分数据。
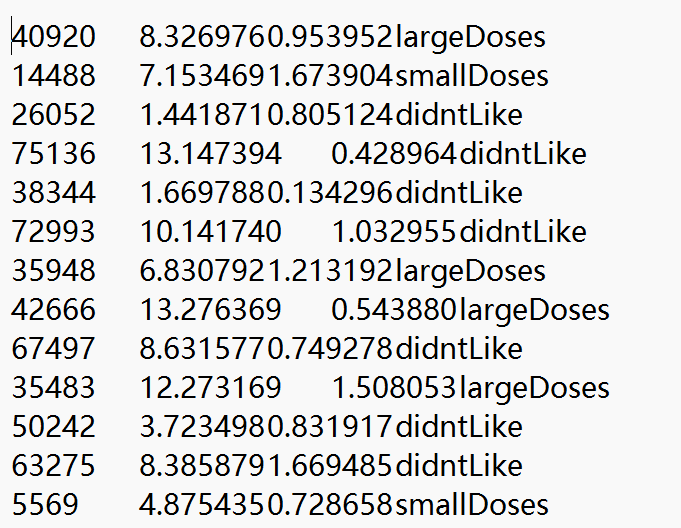
我们很容易发现,当计算样本之间的距离时数字差值最大的属性对计算结果的影响最大,也就是说,每年获取的飞行常客里程数对于计算结果的影响将远远大于上表中其他两个特征-玩视频游戏所耗时间占比和每周消费冰淇淋公斤数的影响。而产生这种现象的唯一原因,仅仅是因为飞行常客里程数远大于其他特征值。但海伦认为这三种特征是同等重要的,因此作为三个等权重的特征之一,飞行常客里程数并不应该如此严重地影响到计算结果。
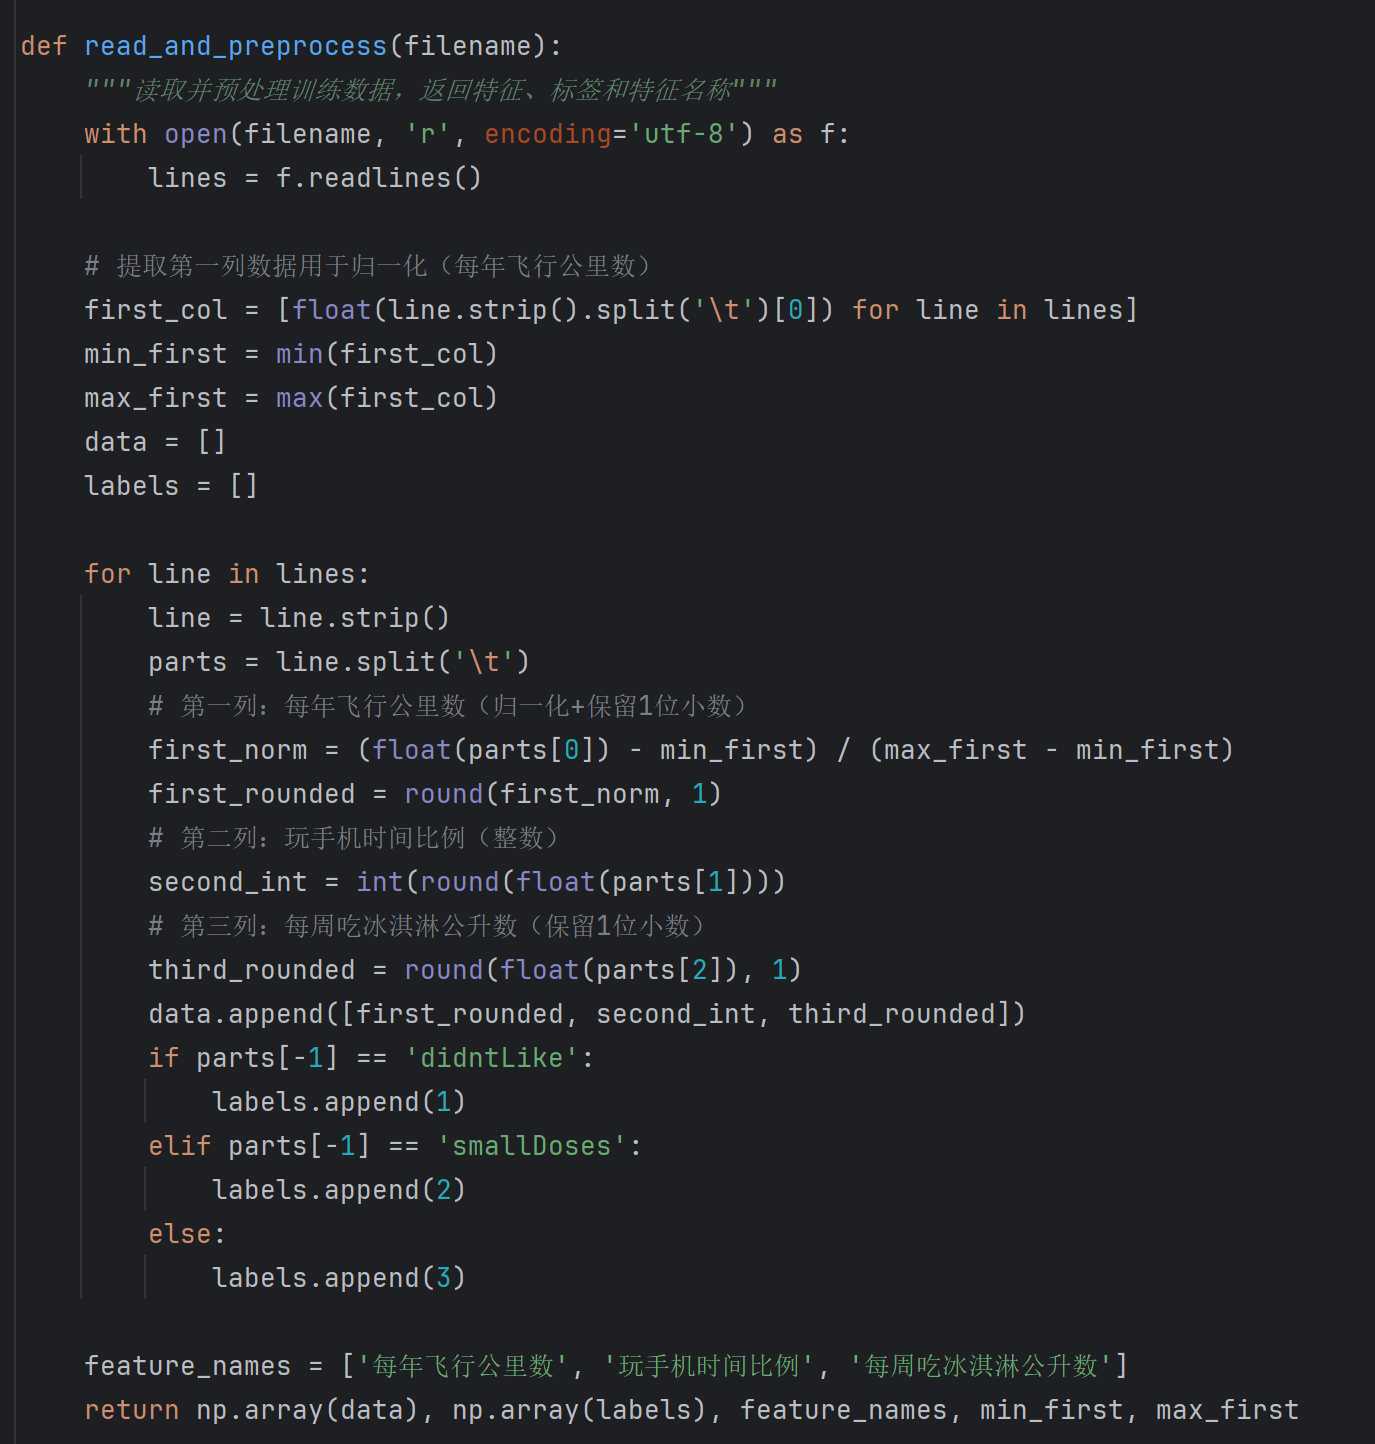
在处理这种不同取值范围的特征值时,我们通常采用的方法是将数值归一化,将特征值转化为0到1区间内的值:
2. 选择距离度量方法:确定用于比较样本之间相似性的度量方法,常见的如欧几里得距离、曼哈顿距离等。我们选择欧氏距离
3. 确定K值:选择一个K值,即在分类或回归时应考虑的邻居数量。这是一个超参数,可以通过交叉验证等方法来选择最优的K值。
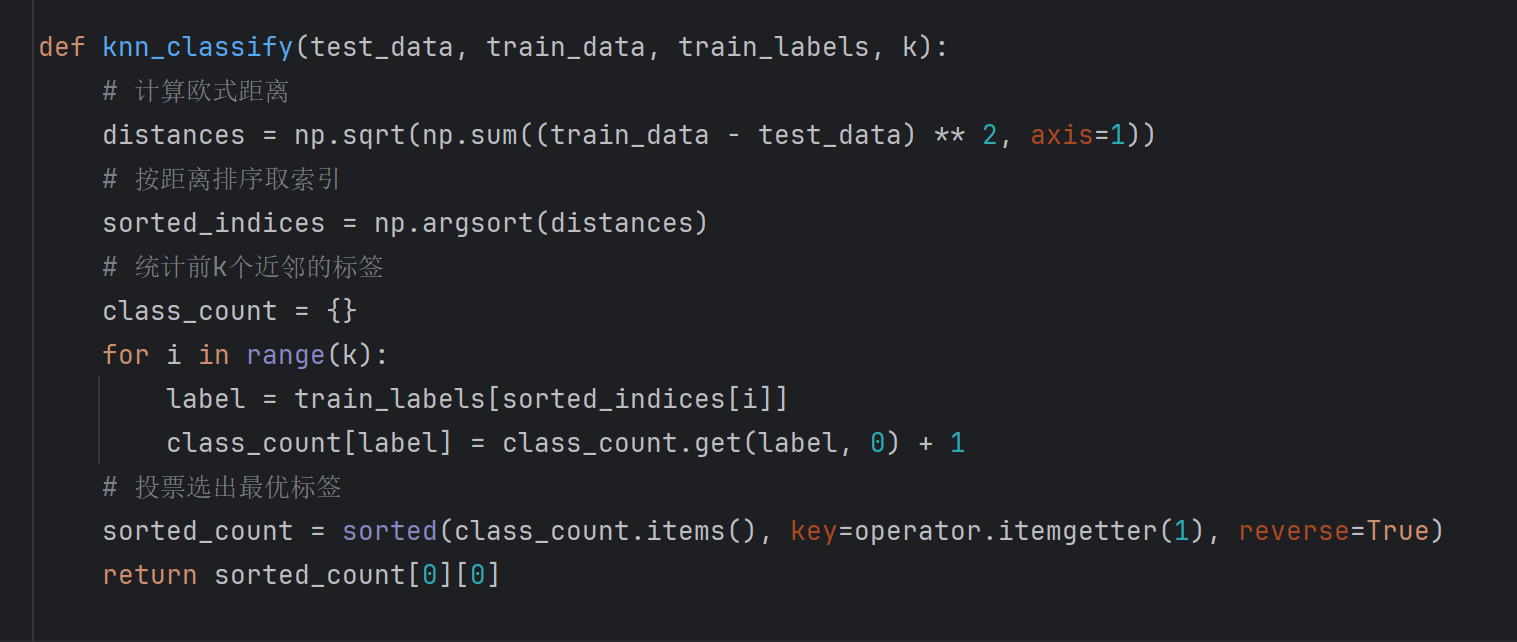
4. 找到K个最近邻居:对于每一个需要预测的未标记的样本:
- 计算该样本与训练集中所有样本的距离。
- 根据距离对它们进行排序。
- 选择距离最近的K个样本
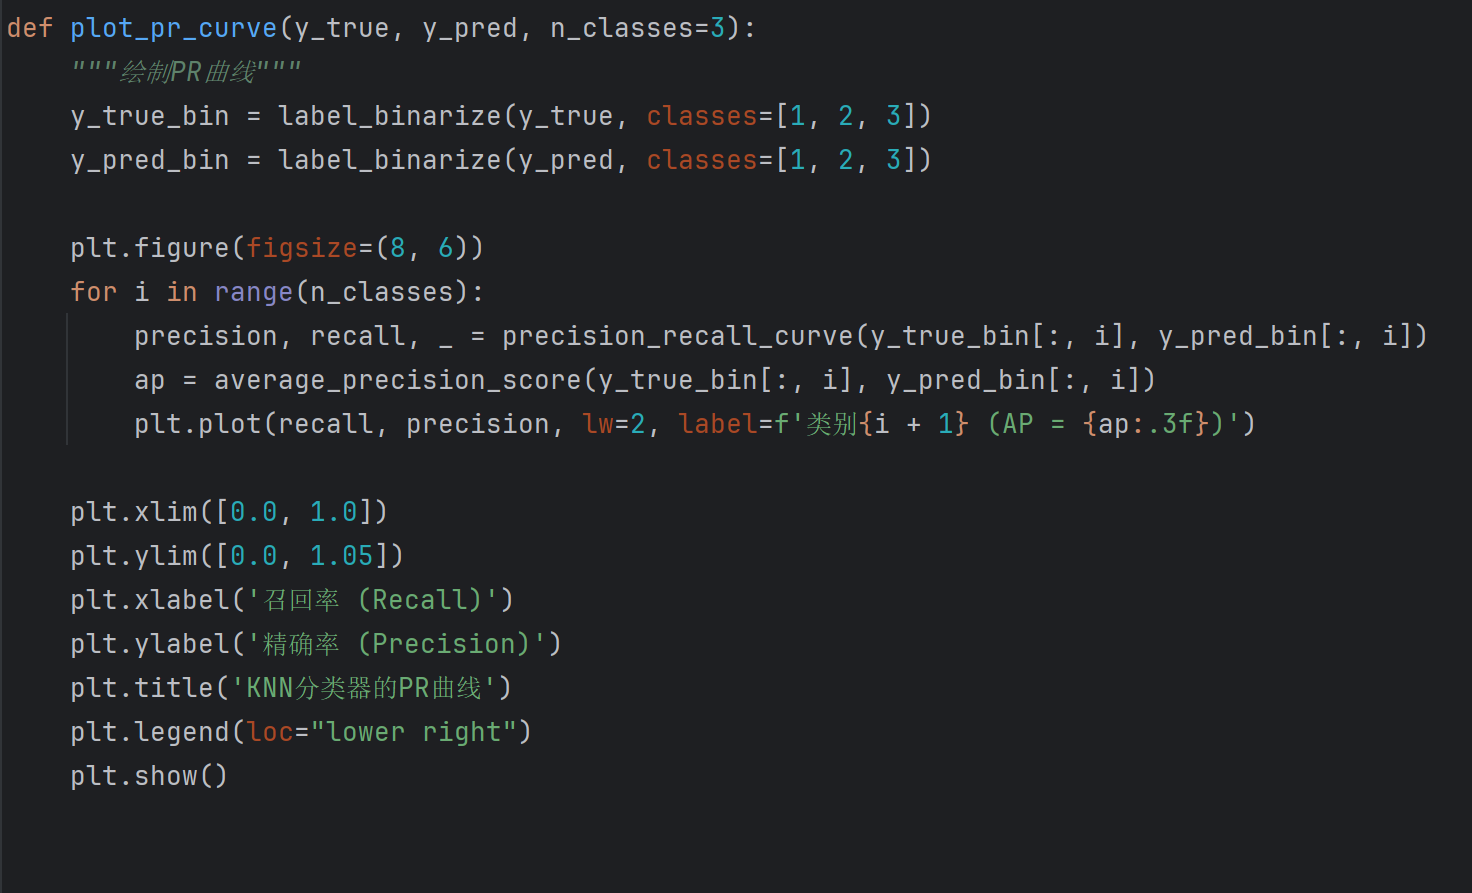
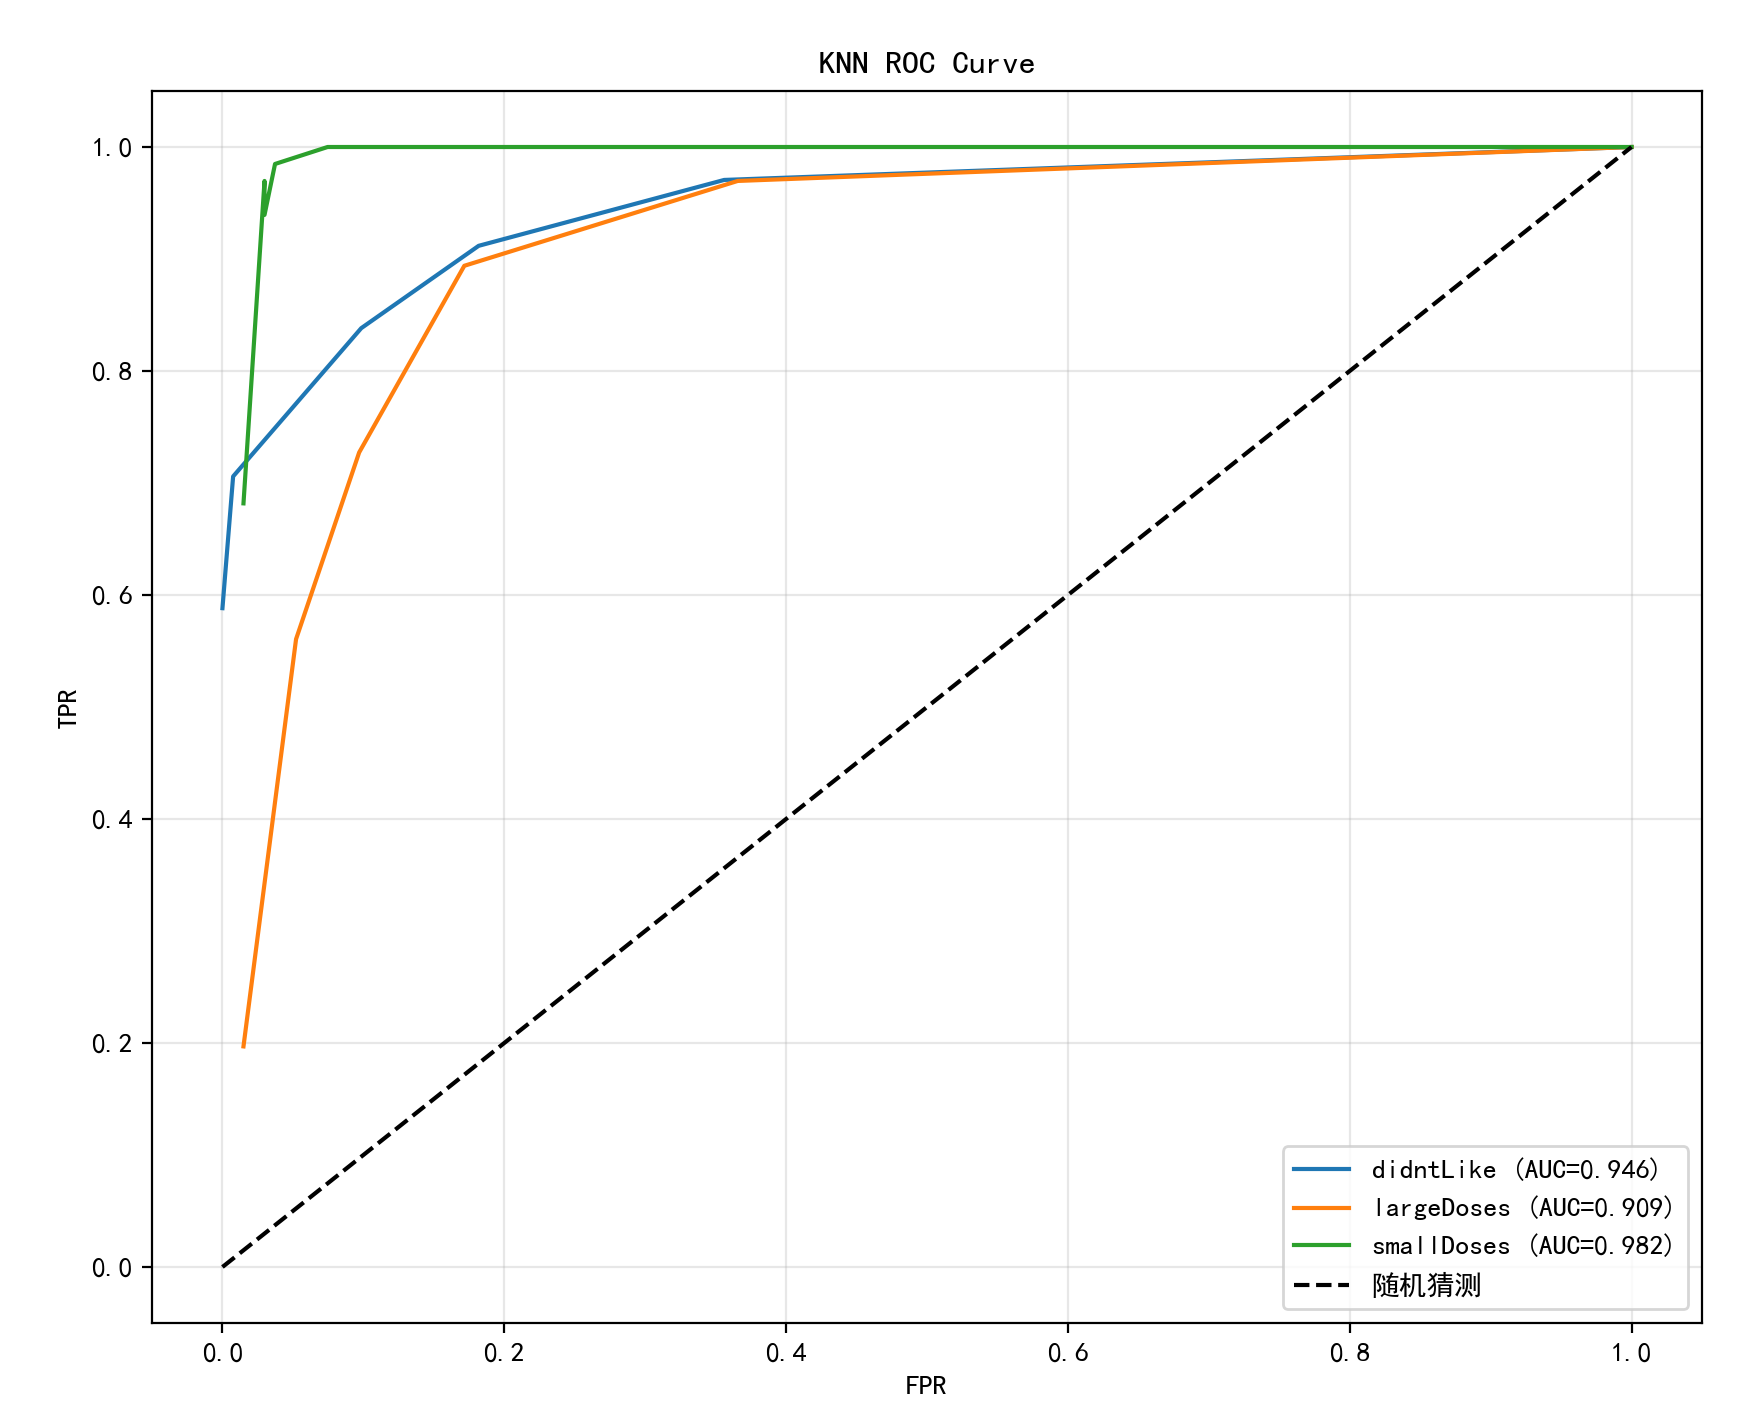
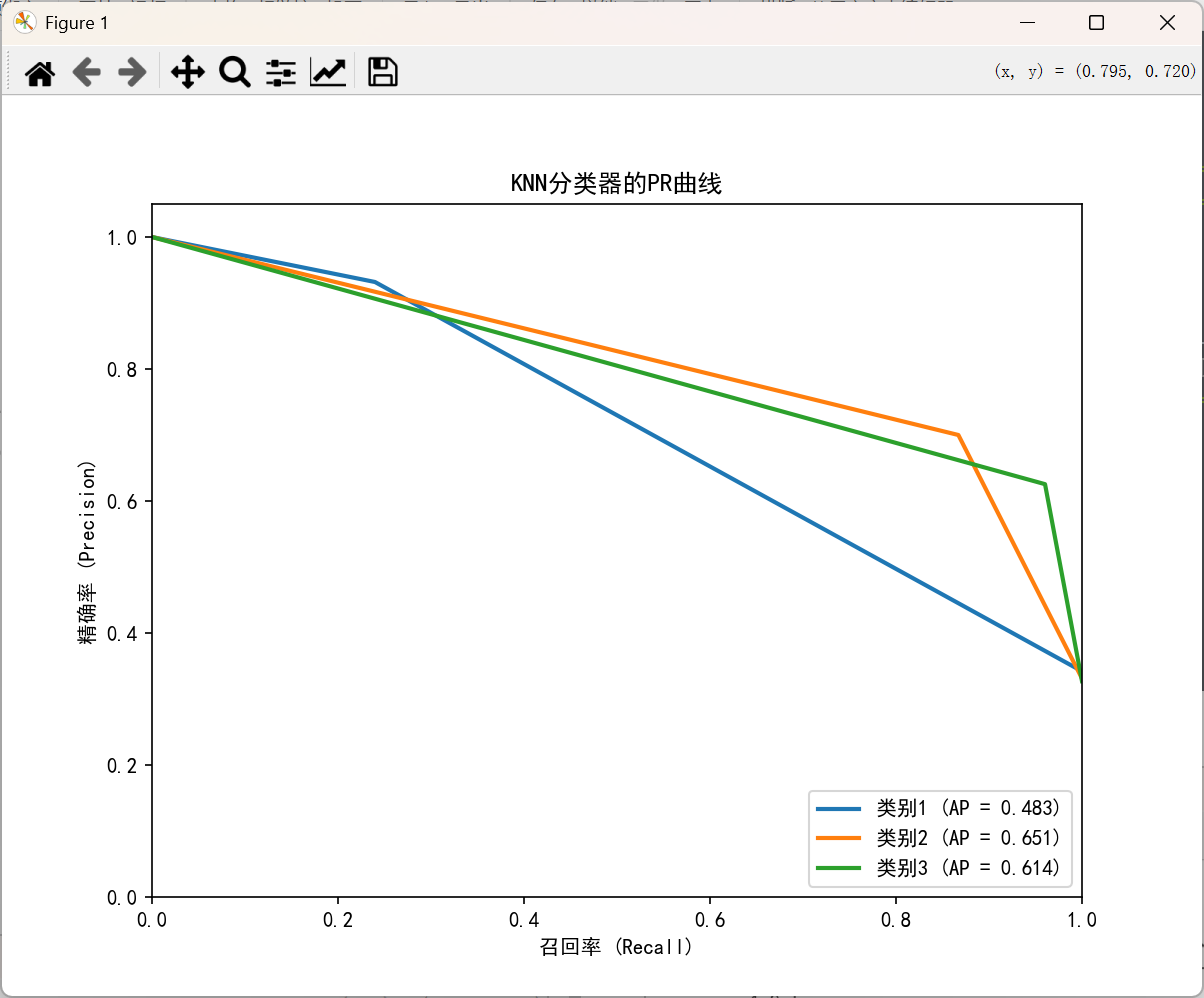
5. 评估:使用适当的评价指标(如准确率、均方误差等)评估模型的性能。我们选择ROC和PR曲线
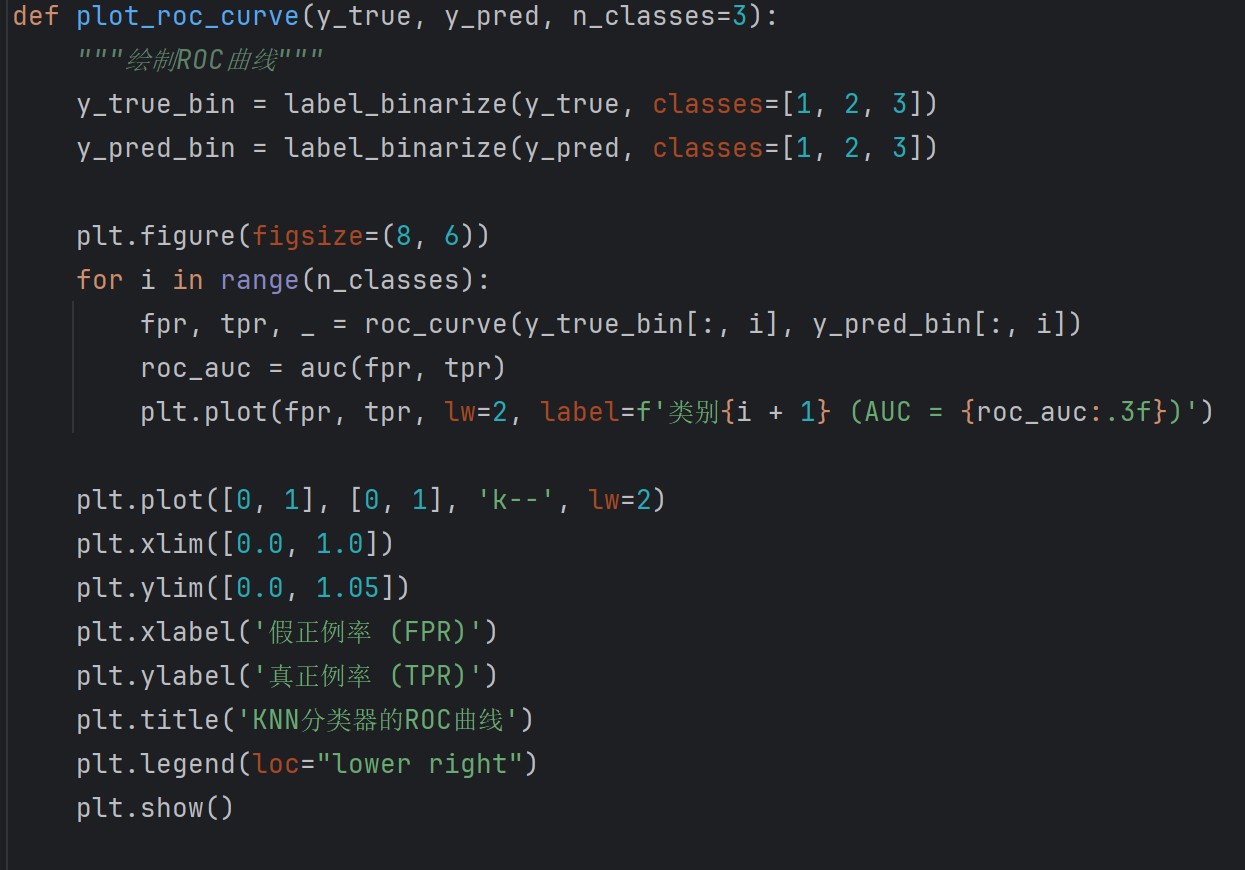
k=5时,ROC曲线如图所示
k=100,PC曲线
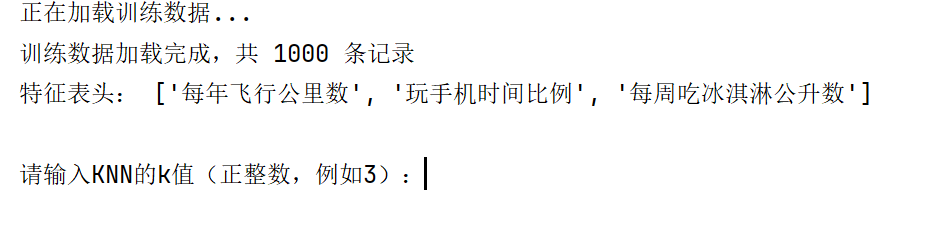
五、运行结果
更多推荐

 5
 0
- 0


 已为社区贡献2条内容

所有评论(0)