- @2401_84033492


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
整体来说面试体验比较好,问的问题都不难,面试官也都不错,遇到一些卡壳的地方也会进行引导讨论,面试氛围很轻松。三面应该是加面的大老板面,从交流可以看出来对整个大模型这块的理解还是很深刻的,收获不小。

最近这一两周看到不少互联网公司都已经开始秋招发放Offer。不同以往的是,当前职场环境已不再是那个双向奔赴时代了。求职者在变多,HC 在变少,岗位要求还更高了。最近,我们又陆续整理了很多大厂的面试题,帮助一些球友解惑答疑,分享技术面试中的那些弯弯绕绕。。更多实战和面试交流,文末加入我们。
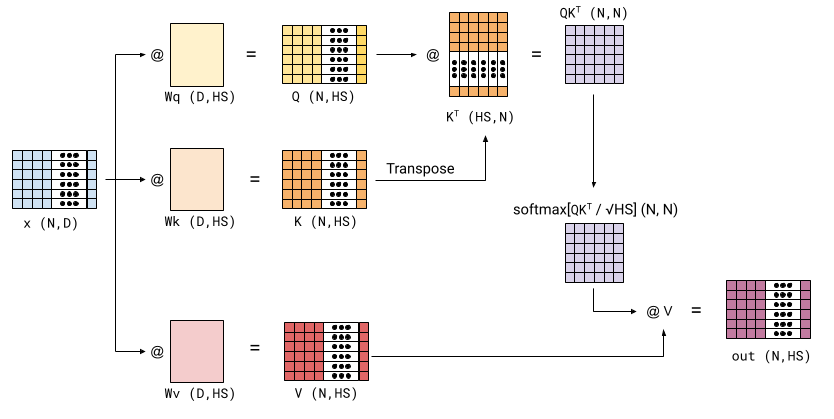
Transformer 属于算法必考题。今天这篇文章讲透Transformer :缩放、批量、多头、掩码、交叉、跨头,对刚想了解算法或面试的朋友非常友好。文章安排如下:基础缩放Attention批量Attention多头Attention掩码Attention交叉Attention跨头维度向量化最近春招和实习已开启了。不同以往的是,当前职场环境已不再是那个双向奔赴时代了。求职者在变多,HC 在变少
Diffusion扩散模型是一类基于概率扩散过程的生成模型,近年来在生成图像、文本和其他数据类型方面展现出了巨大的潜力和优越性。该模型利用了扩散过程的逆过程,即从一个简单的分布逐步还原到复杂的数据分布,通过逐步去噪的方法生成高质量的数据样本。

软目标说明:教师模型输出 [0.7, 0.2, 0.1],表示类别 A 的概率为 0.7,类别 B 的概率为 0.2,类别 C 的概率为 0.1,如果是硬目标就直接选择类别 A,但如果是软目标,学生模型输出的概率分布为 [0.6, 0.3, 0.1],KL 散度会计算这两个概率分布之间的差异。当模型过大无法在单个设备(如 GPU)内存中完整训练时,它将模型的不同部分分布在多个设备上进行训练,相比于
本文整理了来自Daily Dose of Data Science最热门或最新的文章,其中极具特色的动图以生动形象的方式,帮助我们更好的理解AI中的一些核心技术,希望能够帮助大家更好的理解和使用AI。是时候准备面试和实习了。不同以往的是,当前职场环境已不再是那个双向奔赴时代了。求职者在变多,HC 在变少,岗位要求还更高了。最近,我们又陆续整理了很多大厂的面试题,帮助一些球友解惑答疑,分享技术面试中
经验总结T5微调:首选Prompt TuningGPT类生成:首选Prefix TuningBERT类理解:首选P-tuning传统训练:所有操作都用FP32(32位浮点数)混合精度训练前向传播:大部分用FP16,数值敏感操作用FP32反向传播:梯度计算用FP16,累积用FP32参数更新:用FP32保证精度显存充足(>40GB)任务简单:Prompt Tuning任务复杂:LoRA (rank=3
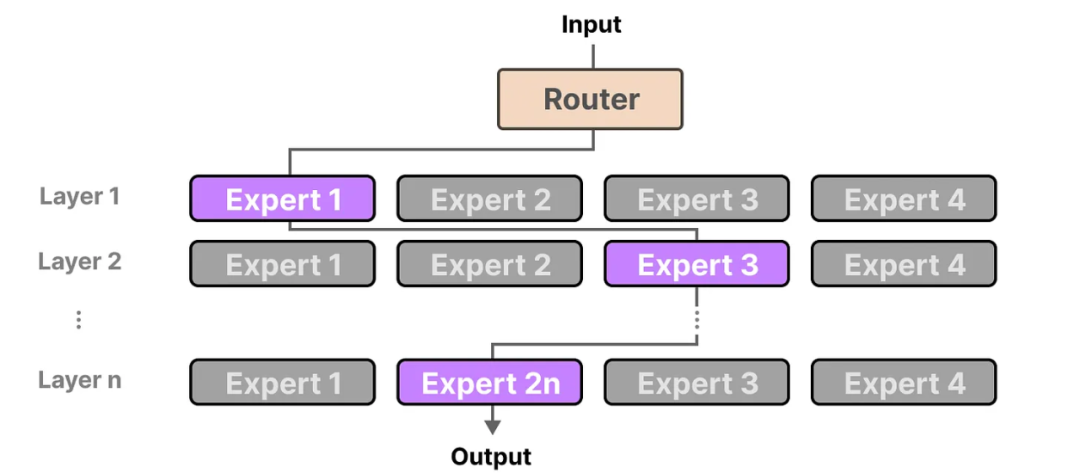
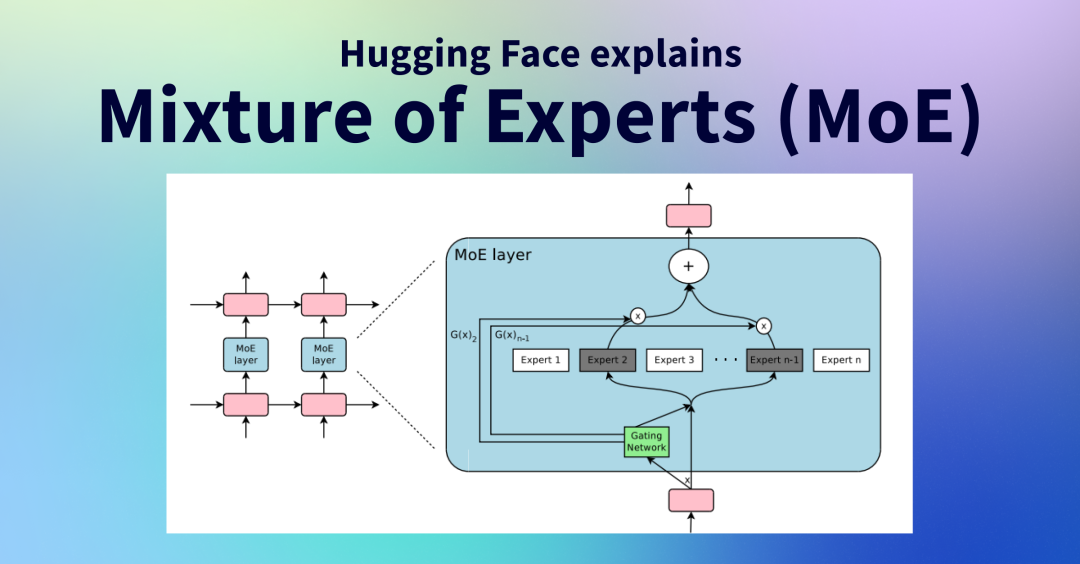
在探索最新的大语言模型(LLM)时,“MoE”这一术语频繁出现在各种标题之中。最近春招和实习已开启了。不同以往的是,当前职场环境已不再是那个双向奔赴时代了。求职者在变多,HC 在变少,岗位要求还更高了。最近,我们又陆续整理了很多大厂的面试题,帮助一些球友解惑答疑,分享技术面试中的那些弯弯绕绕。。
最近这一两周看到不少互联网公司都已经开始秋招发放Offer。不同以往的是,当前职场环境已不再是那个双向奔赴时代了。求职者在变多,HC 在变少,岗位要求还更高了。最近,我们又陆续整理了很多大厂的面试题,帮助一些球友解惑答疑,分享技术面试中的那些弯弯绕绕。。更多实战和面试交流,文末加入我们。
混合专家(MoE)是一种利用多个不同的子模型(或称为“专家”)来提升LLM质量的技术。MoE的两个主要组成部分是:专家:每个前馈神经网络(FFNN)层现在都有一组“专家”,可以选择其中的一部分。这些“专家”通常也是FFNN。路由或门控网络:决定哪些词元发送到哪些专家。在每个具有MoE的模型层中,我们会找到(相对专业化的)专家:需要注意的是,“专家”并不专注于特定领域,如“心理学”或“生物学”。专家