- @2301_80226956


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
博主因Ubuntu启动项丢失无法运行issacsim,通过Windows磁盘管理找到EFI分区,使用DiskPart工具分配盘符后成功获取Ubuntu启动文件(grubx64.efi)。随后通过BootICE工具将Ubuntu添加到Windows启动管理器:创建新启动项,指定EFI分区路径\EFI\ubuntu\grubx64.efi,最终恢复双系统启动选项。操作完成后建议移除临时分配的盘符以保障

如何提醒自己claude已经完成任务?Pushplus

ROS2-第五章 ROS2机器人运动控制 陶楚沅版教参
ROS2-第四章 ROS2机器人运动控制 陶楚沅版教参 陶老师讲的很好,比很多乱七八糟的入门课程好得多(也有可能是我打过基础,吃过很多ROS1的屎了),而且是中文PPT欸!
讲了室内自主移动机器人(AMR)感知技术,遵循“总—分—总”结构,以任务驱动为主线,系统梳理了定位、建图(SLAM)、障碍识别与避障等核心感知任务。从单传感器(如IMU、LiDAR、视觉、射频)的原理、优缺点到多传感器融合方法(卡尔曼滤波、粒子滤波、神经网络),层层递进,结合图表详述技术实现与改进。最后探讨传感器选型策略及未来趋势:多源融合、优化算法革新与深度学习结合,强调在复杂动态环境中提升鲁棒
算法设计 第6讲(下) 图论II:全源最短路、最大流与二分图匹配 章节练习
机器人动力学基础,带你打通从拉格朗日方程 到 动力学方程的推导与理解。什么是变分?什么是泛函?为什么这样求?这些疑问都可以在此一网打尽!
强化学习9.1——部署强化学习到UnitreeGo2上!【安装与配置】
摘要:本文系统介绍了强化学习中的动态规划(DP)、蒙特卡洛(MC)和时序差分(TD)方法。DP需要完整环境模型,MC通过完整轨迹采样更新,TD则结合两者优势进行单步更新。重点讨论了基于状态价值V和动作价值Q的更新策略,包括SARSA(on-policy)和Q-learning(off-policy)算法。通过比较不同方法在模型需求、更新时机和偏差方差等方面的特性,阐明了从理论推导到实际应用的演进逻
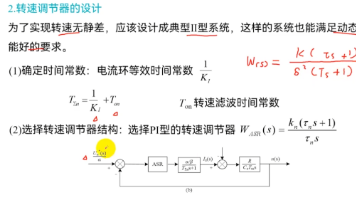
如何设计一个调节器:一、将系统进行等效 得到时间常数、并通过解传递函数方程,得到调节器类型(PI型?)二、根据要求选择参数 根据静态需求先查表选择静态指标,结合传递函数得到增益系数,超前时间常数两个重要参数三、校验 根据不同典型系统计算截止频率,分别带入验证三个等效式子是否成立四、计算系统的电路参数