- @2203_75871132


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
RoboTwin 2.0 登顶榜单、RoboDojo 领跑统一评测,两件进展的共同信号是:具身智能的下一轮 Scaling,题眼在 Physics,不在参数。物理世界的非线性、接触力学与因果结构,是 LLM 式暴力 Scaling 跨不过的墙;谁能把"更真的物理"做成可规模化的数据、可统一的评测、可迁移的策略,谁就握住了下一程的入场券。

RoboColiseum 这次同台,最值得记住的不是「Opus 5.5 以 0.29 个百分点险胜 GPT-6 Astra」,而是它用一套统一的框架、任务和评分,把通用大模型的能力边界量了出来:指令跟随 86% 到 99%,通用操作只有 39% 到 47%,专用策略模型在「手」上仍然领先近 20 个百分点。对做具身应用的团队,它是一把低成本、可归因的尺子;对关注大模型的人,它提醒了一句:语言与多模

ASPIRE 真正有意思的地方,不是它把某个基准刷到了 99%,而是它把「机器人怎么从试错里长出经验」这件事工程化了:控制逻辑写成代码、失败修复存进技能库、用进化搜索避免陷入局部修补。对具身智能和 Agent 落地的开发者来说,这条 code-as-policy 的路线值得盯,因为它把瓶颈从「训一个更大的模型」挪到了「管好一份会成长的技能库」。但下手之前要把账算清——它的天花板由底层 LLM 决定

这是刚开始写 Cordis 插件最容易混的一点。export const inject = ['skills'] // 声明:我需要 skills 服务// ...然后在 apply 里直接用 ctx.skillsinject不是 import,而是依赖声明。保证加载顺序——宿主会先激活提供skills服务的插件,再激活你;保证可用性——服务没就绪时,你的插件不会被激活,不会出现。所以它和impo

Gemini 4 Argon 真正有价值的,不是「AI 懂物理」这句口号,而是它把 Real2Sim 仿真重建、物理理解、控制代码生成串成了一条可自动化的机器人开发链路——这比单点跑分更接近机器人落地的真问题。但要注意三件事:ERQA 87% 是实验室自报、尚无独立复现;「便宜 22 倍」混淆了 token 单价和单次任务成本,标准价生效后 Argon 反而可能更贵;编码口碑的内外反差,多半是「长
VPP2 是清华系星动纪元推出的世界动作模型,以 14B 参数、不靠额外数据与外挂增强、完全开源的姿态登顶 RoboDojo-Sim,把 GPT-6-Astra、π0.5、GR00T 等头部模型甩在身后。它的核心不在堆料,而在"先练视频预测、再解耦注入动作"的三阶段路线——用预测-动作解耦换来了真正的零样本泛化。对做具身智能和仿真数据引擎的团队,这是一份可复现、可拆解的样本;但也要看清,榜单整体水

VoxMem 用"声学证据类型 × 记忆操作"的二维框架,把音频大模型的记忆能力拆成了 15 种可定位的考察,第一次系统证明:模型记得住"说了什么",却严重记不住"谁说的、怎么说的、现场有什么声音",而且历史越长差距越大。对做语音助手、家庭多用户助理和客服机器人的团队,它是目前最贴近真实体验的一把体检尺——开源、可直接复现,也给出了清晰的失败坐标。下一步值得盯的是:在"保留非词面声学信息并维持其跨

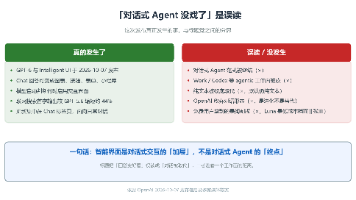
2026-10-07,OpenAI 发布 GPT-6 与 Intelligent UI,把「ChatGPT 的回答」从一段段文字,升级成可以点击、可以调参、可以当小工具用的交互界面。作为背景,据发布方披露 ChatGPT 周活已突破 12 亿,这次更新会触达几乎所有档位的用户。外界把这次发布概括成「对话式 Agent 没戏了」——但真实边界和这个论断之间,差着一个工作面的距离。一句话结论先放这儿:
原始思维链被平台有意隐藏(出于质量与竞争的考量)。把它当可审计的「模型为什么这么走」的线索存日志可以,但原样贴给用户既可能暴露中间瑕疵,也偏离了官方设计意图。若团队内要做模型行为分析,reasoning 摘要恰恰是最该采集的字段之一,因为它直观反映了模型在关键决策上的中间依据。更稳妥的做法是:日志里保留 reasoning 摘要用于排障,界面上只呈现。
DeerFlow 2.0 最核心的价值,是把「Agent Harness」从一句行业口号,落地成一套可运行、可审计、可扩展的操作系统级基础设施——四层解耦架构、18 个生产级中间件、真隔离的 Docker/K8s 沙盒,加上分层长期记忆与模型无关设计。它没有改变「模型是能力来源」这个事实,而是把「怎么让模型稳定、可靠、长期地干活」变成了框架的内置能力。值得关注的是要做长任务、要动手、且在意隔离与审