
从零写 GPT 推理引擎:纯 C++/CUDA,四轮优化提速 1381 倍
一、项目核心释义
这是一套完全从零手写、纯C++结合自定义CUDA内核实现的GPT风格推理引擎,针对124M参数的GPT-2模型做全链路性能优化,全程不依赖PyTorch、ONNX等任何深度学习框架,所有算子(嵌入、层归一化、自注意力、GELU激活、线性投影)全部原生实现。
项目完整走通了从朴素基线到四轮工程优化的全流程,把1024token的预填充处理从13.7秒压缩到910毫秒,单token解码延迟从13.7秒压缩到9.9毫秒,解码阶段累计提速1381倍。整个项目不仅是一个推理引擎,更是一份可复现的CUDA优化实战教程,每一步优化都有明确的问题定位、技术手段和性能收益。
二、行业核心技术知识点
在拆解优化过程之前,先梳理大模型推理的几个核心底层概念,搞懂这些才能理解优化为什么有效。
2.1 推理的两种模式:Prefill与Decode
大语言模型推理分两个完全不同的阶段,计算特性天差地别:
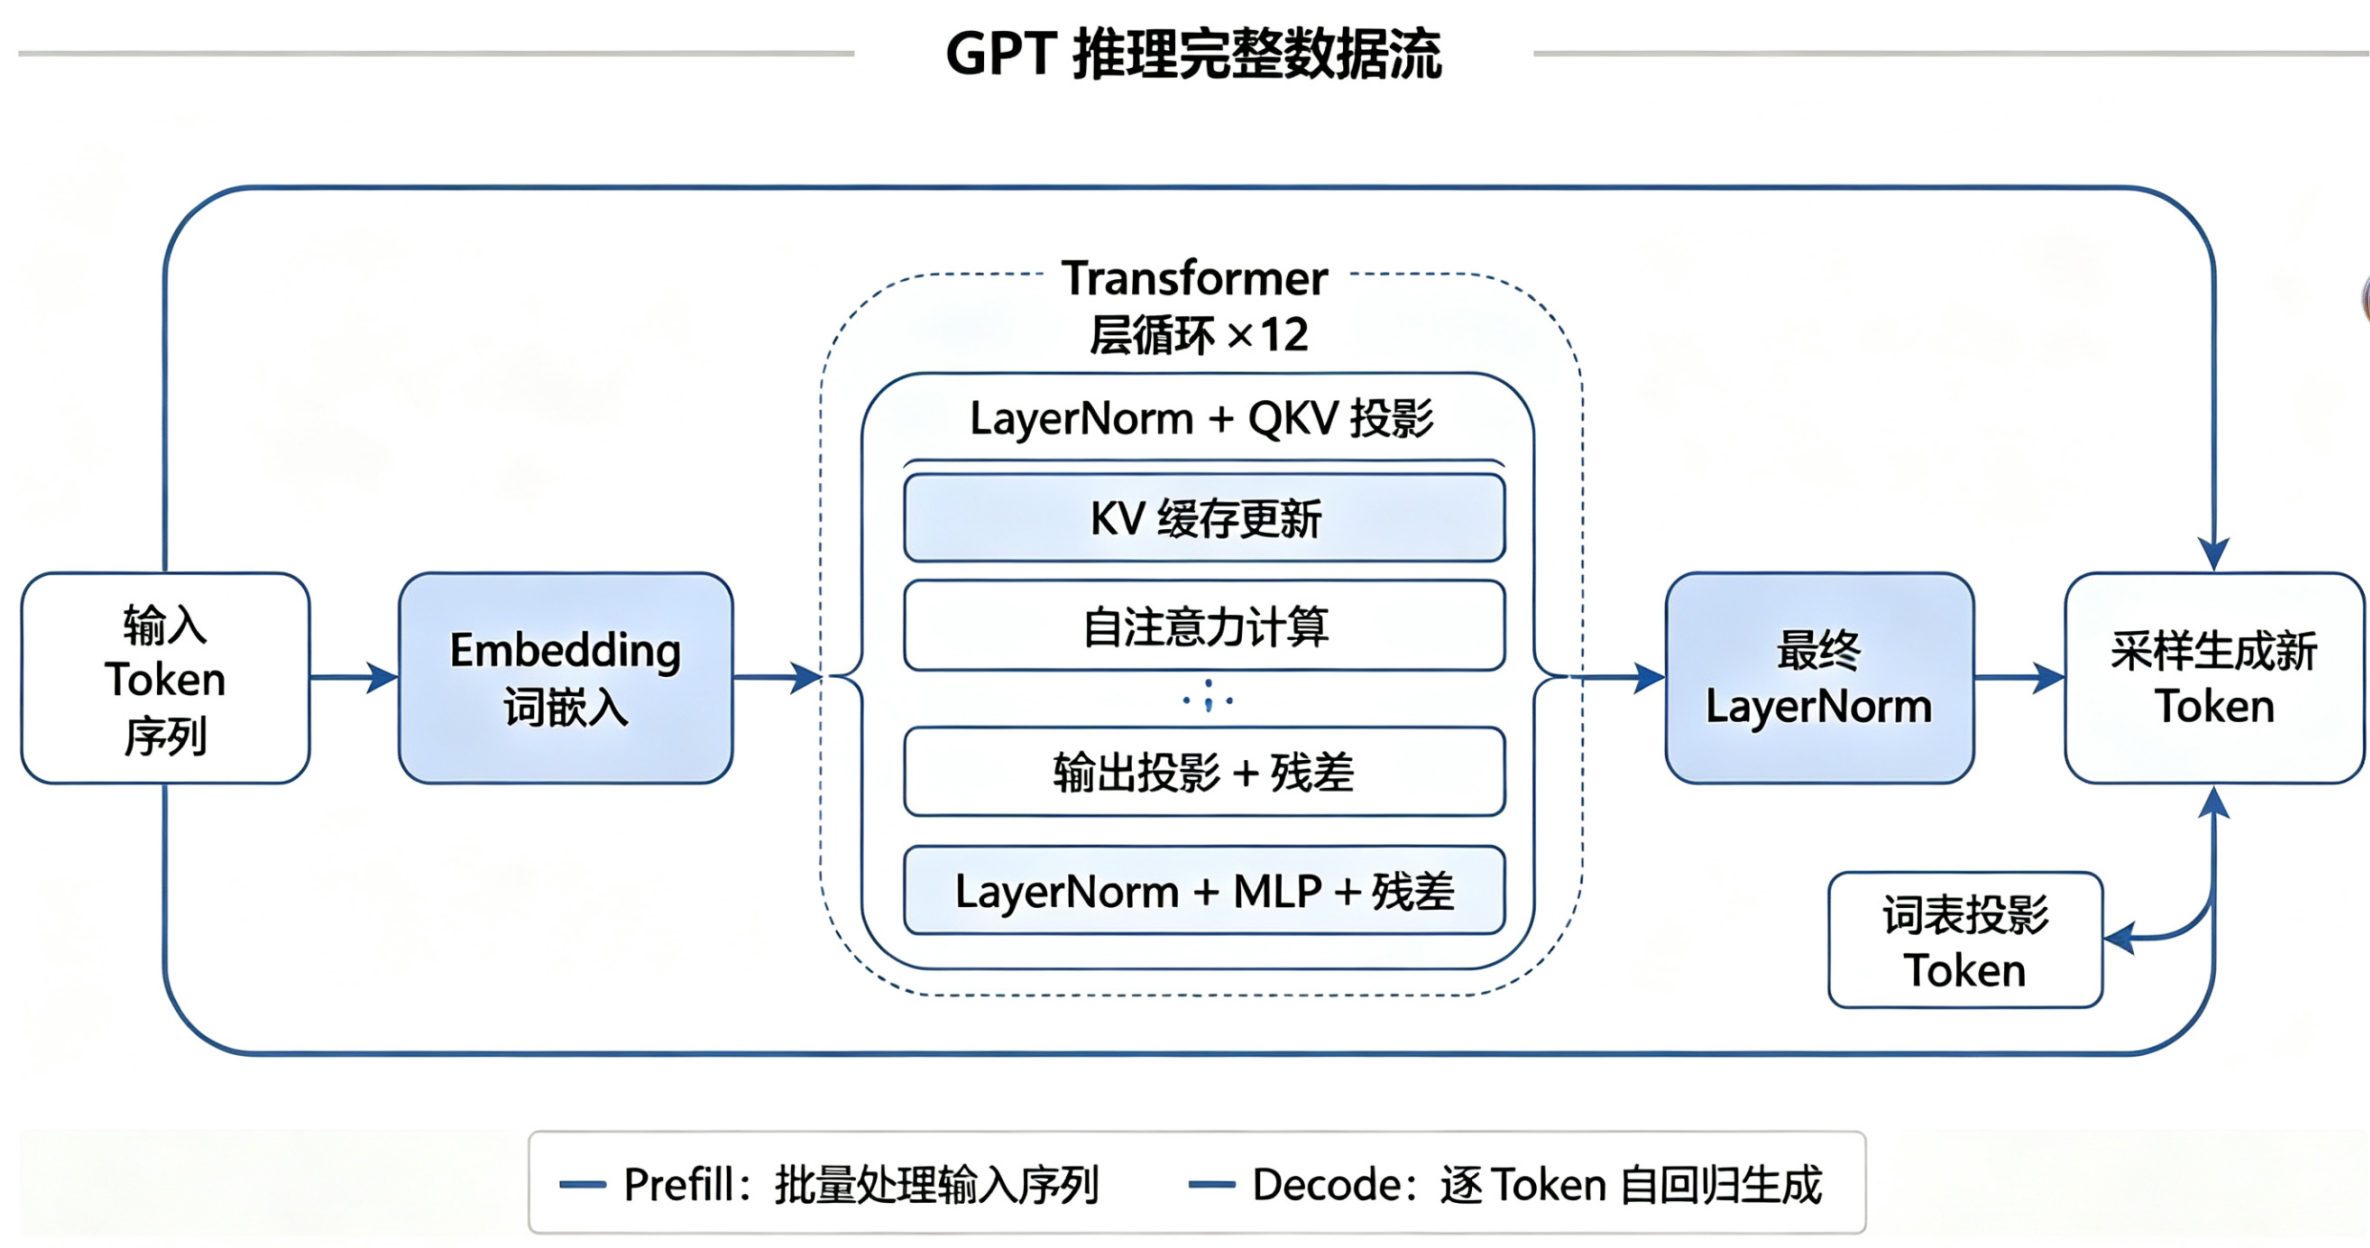
- 预填充(Prefill):一次性处理整个输入prompt,输入是整段token序列,是典型的矩阵-矩阵乘法(GEMM),并行度高,适合批量计算;
- 解码(Decode):自回归逐token生成,每次只输入1个新token,是典型的矩阵-向量乘法(GEMV),并行度低,容易让GPU闲下来。
很多推理引擎性能差,核心原因就是没区分两种模式,用同一套算子跑两种场景,两边都没做好。
2.2 KV缓存:解决二次方复杂度的核心
自回归推理的朴素实现有个致命问题:每生成一个新token,都要把所有历史token重新算一遍投影和注意力,计算量随序列长度二次方增长,序列越长越慢。
KV缓存的思路很简单:历史token的Key和Value向量一旦算好就不会变,直接存在显存里。每次生成新token时,只算新token的Q/K/V,把新KV追加到缓存里,注意力计算直接用缓存的历史KV。直接把投影计算量从O(N)降到O(1),是长上下文推理的必备优化。
2.3 推理的真正瓶颈:内存带宽
很多人以为推理慢是计算单元不够用,实际上大多数Transformer推理的瓶颈是显存带宽。
尤其是自注意力计算,朴素实现要先算出完整的N×N注意力分数矩阵,写回显存,再读回来做Softmax,再读一遍乘V向量。一次注意力要做三次N×N矩阵的读写,计算量很小,但内存读写量极大,GPU大部分时间在等数据,计算单元空闲。
2.4 CUDA优化的两个核心武器
- 共享内存(Shared Memory):片上高速缓存,比全局显存快几十倍。把数据分块加载到共享内存里重复利用,大幅减少全局显存读写。
- Warp内寄存器洗牌:同一个Warp的32个线程可以直接通过寄存器交换数据,比共享内存还快,适合小维度的归约运算。
三、整体架构设计思路
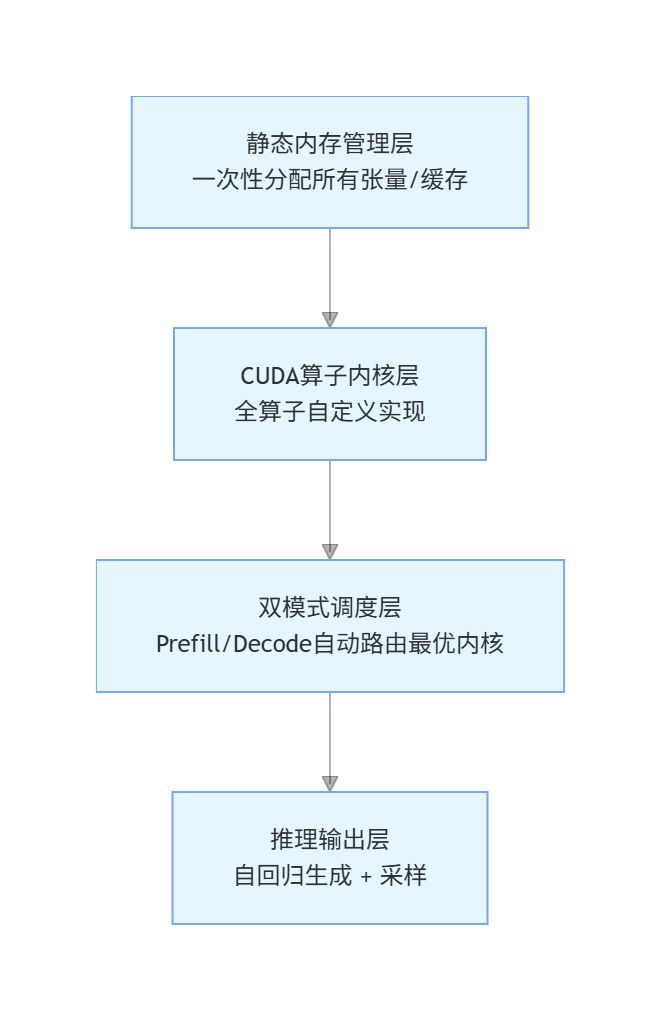
引擎采用分层设计,从底到上分别是内存管理层、算子内核层、模式调度层、推理输出层,核心设计原则是:静态预分配、双模式适配、最少内核启动、最少内存读写。
3.1 静态内存管理
所有显存分配只在启动时做一次,推理过程中不做任何malloc/free。所有中间激活张量、KV缓存、临时缓冲区都预先分配好,层之间复用临时缓冲区,指针来回传递,彻底避免CUDA内存分配的驱动开销。
用统一的Tensor结构体管理所有张量:
struct Tensor {
    std::vector<int> shape;
    size_t numel;      // 元素总数
    float* data;       // GPU显存指针
};
3.2 双模式调度架构
根据当前序列长度自动选择执行路径:
- 序列长度>1时,走Prefill模式,调用批量分块GEMM内核,最大化并行度;
- 序列长度=1时,走Decode模式,调用Warp优化的GEMV内核,最小化调度开销。
3.3 完整推理数据流
四、全套代码实现原理:四轮优化全拆解
整个优化过程分四个阶段,每一步都针对明确的瓶颈,有可复现的性能收益。
4.1 朴素基线:三大性能瓶颈
最初的朴素实现所有算子都用最直接的写法,数学上完全正确,但性能极差,1024token推理要13.7秒。核心瓶颈有三个:
瓶颈1:CPU串行调度
Prefill阶段CPU侧写了个循环,逐个token启动GEMV内核,1024个token就要启动1024次内核。GPU大部分时间在等CPU调度,计算单元基本闲置。
瓶颈2:单线程点积计算
线性层内核每个线程单独算一个输出元素的完整点积,循环遍历整个输入维度。每个线程逐个从全局显存读数据,内存延迟几百个时钟周期,线程大部分时间在等数据。
瓶颈3:非合并转置读取
词表投影层权重是转置的,连续线程读取的地址间隔一个输入维度的步长,GPU无法合并内存请求,32个线程就要做32次单独的显存读取,速度极慢。仅词表投影一项就占了4.2秒。
朴素线性层内核示意:
__global__ void linear_kernel(float* input, float* weights, float* bias, float* output,
                          int in_features, int out_features) {
    int out_idx = blockIdx.x * blockDim.x + threadIdx.x;
    if (out_idx >= out_features) return;

    float sum = 0.0f;
    // 单线程串行计算整个点积
    for (int k = 0; k < in_features; ++k) {
        sum += input[k] * weights[k * out_features + out_idx];
    }
    output[out_idx] = sum + bias[out_idx];
}
4.2 第一轮优化:矩阵运算重构
针对前三个瓶颈,针对性重构了所有矩阵运算,区分Prefill和Decode双模式。
Prefill模式:分块GEMM + 共享内存分块
- 去掉CPU循环:把所有token拼成一个[seq_len, in_features]的二维矩阵,一次启动GEMM内核处理整个prompt,内核启动次数从1024次降到1次。
- 共享内存分块:矩阵分成16×16的块,线程块协作把输入块和权重块加载到共享内存,每个值重复利用16次,全局显存读取减少16倍。
- 转置权重合并:重构转置GEMM的线程索引,让连续线程读取连续的权重行,加载到共享内存后再转置读取,彻底解决非合并读取问题。
Decode模式:Warp归约GEMV
单token场景下,一个Warp的32个线程协作算一个输出元素:
- 每个线程只算部分点积,步长32,循环次数从768次降到24次;
- 最后用
__shfl_down_sync做Warp内寄存器洗牌求和,不用写共享内存,延迟极低。
优化后的GEMV内核核心代码:
__global__ void gemv_warp_kernel(float* input, float* weights, float* bias, float* output,
                               int in_features, int out_features) {
    int warp_idx = blockIdx.x;
    int lane_idx = threadIdx.x;

    float sum = 0.0f;
    // 每个线程只算部分点积
    for (int k = lane_idx; k < in_features; k += 32) {
        sum += input[k] * weights[k * out_features + warp_idx];
    }

    // Warp内寄存器洗牌求和
    for (int offset = 16; offset > 0; offset /= 2) {
        sum += __shfl_down_sync(0xffffffff, sum, offset);
    }

    if (lane_idx == 0) {
        output[warp_idx] = sum + bias[warp_idx];
    }
}
第一轮优化效果
| 模块 | 朴素基线 | 优化后 | 提速 |
|---|---|---|---|
| QKV投影(1024token) | 122.33ms | 8.70ms | 14.0x |
| 词表投影(1024token) | 4235.52ms | 388.74ms | 10.9x |
| 全模型预填充 | 13700.50ms | 3004.41ms | 4.5x |
4.3 第二轮优化:持久化KV缓存
矩阵运算优化完,生成阶段还是有随序列变长变慢的问题——每步都重算所有历史token的KV。
优化方案:预分配KV缓存
在显存里预先分配好最大序列长度的Key缓存和Value缓存。每次生成新token时:
- 只算新token的Q、K、V;
- 把新的K和V追加到缓存的对应位置;
- 注意力计算直接用Q查询整个缓存里的KV。
KV缓存更新内核核心逻辑:
__global__ void update_kv_cache_kernel(float* qkv, float* key_cache, float* value_cache,
                                 int n_embd, int seq_len, int past_seq_len) {
    int token_idx = blockIdx.y;
    int feat_idx = blockIdx.x * blockDim.x + threadIdx.x;
    if (token_idx >= seq_len || feat_idx >= n_embd) return;

    int cache_slot = past_seq_len + token_idx;
    // 从QKV里取出K和V,写入缓存对应位置
    float k_val = qkv[token_idx * 3 * n_embd + n_embd + feat_idx];
    float v_val = qkv[token_idx * 3 * n_embd + 2 * n_embd + feat_idx];

    key_cache[cache_slot * n_embd + feat_idx] = k_val;
    value_cache[cache_slot * n_embd + feat_idx] = v_val;
}
第二轮优化效果
| 阶段 | 延迟 | 提速(相对基线) |
|---|---|---|
| 朴素基线 | 13700.50ms | 1.00x |
| 矩阵优化后 | 3004.41ms | 4.56x |
| 加KV缓存后 | 14.90ms | 919.68x |
解码阶段直接从秒级降到十毫秒级,而且生成速度基本不随序列长度增加而下降。
4.4 第三轮优化:FlashAttention与并行解码
KV缓存解决了投影的问题,但注意力计算本身还是有内存带宽瓶颈——完整的N×N分数矩阵来回读写太耗带宽。
Prefill模式:FlashAttention
把整个注意力计算融合成一个内核,用在线Softmax,不写回完整的N×N中间矩阵:
- 分块计算注意力分数,块内算完就更新行最大值和指数和;
- 动态缩放之前的累加结果,保证数值稳定;
- 最终只写回注意力输出向量,完全避免N×N矩阵的全局读写。
同时解决了共享内存库冲突问题:把查询块的共享内存布局转置,Warp线程连续读取跨不同内存库,消除32路库冲突。
Decode模式:FlashDecoding
单query场景下,只启动12个注意力头的线程块,GPU利用率很低。
优化方案:把缓存的KV序列分成128大小的块,每个块启动一个线程块并行计算局部注意力输出,最后用一个归约内核合并结果。大幅提升GPU流多处理器的利用率。
第三轮优化效果
| 阶段 | 预填充延迟 | 单步解码延迟 |
|---|---|---|
| 加KV缓存后 | 2795.72ms | 14.90ms |
| 加FlashAttention后 | 2790.36ms | 13.83ms |
预填充阶段消除了中间矩阵的带宽开销,解码阶段通过并行进一步提升了GPU利用率。
4.5 第四轮优化:算子融合与异步执行
最后一轮优化针对细碎算子的内存读写开销和CPU调度开销。
优化1:残差+层归一化融合
把残差相加直接合并进LayerNorm内核里,不用单独启动残差加法内核。内核同时读取激活和残差,寄存器里相加,同时写回残差缓存和做归一化。消除两次完整的全局内存读写。
融合内核核心逻辑:
__global__ void fused_layernorm_kernel(float* input, float* residual, float* gamma, float* beta,
                                    float* output, int hidden_size, bool add_residual) {
    int tid = blockIdx.x * blockDim.x + threadIdx.x;
    if (tid >= hidden_size) return;

    float val = input[tid];
    if (add_residual) {
        val += residual[tid];
        residual[tid] = val; // 更新残差
    }
    input[tid] = val;

    // ... 后续归一化计算 ...
}
优化2:批量序列层归一化
把逐个token启动LayerNorm内核,改成一次启动整个序列的批量内核,一个内核处理所有token,减少CPU调度开销。
优化3:去掉中间同步
基线里每个内核后面都加了cudaDeviceSynchronize(),CPU每次都等GPU做完才发下一个命令,GPU流水线完全空转。
去掉所有中间同步,CPU一次性把12层的所有算子都发到GPU命令队列,GPU驱动自动调度重叠执行,流水线填满。
第四轮优化效果
| 优化阶段 | 预填充延迟 | 单步解码延迟 | 预填充提速 | 解码提速 |
|---|---|---|---|---|
| 朴素基线 | 13700.50ms | 13700.50ms | 1.00x | 1.00x |
| 最终优化 | 910.55ms | 9.92ms | 15.05x | 1381.10x |
四轮优化下来,预填充提速15倍,解码提速超过1380倍,性能提升非常显著。
五、环境配置与运行测试教程
5.1 环境要求
- CUDA Toolkit 11.x 及以上
- C++17 兼容编译器(GCC、MSVC均可)
- CMake 3.18 及以上
- Python 3.x(仅用于权重转换,推理不需要)
5.2 第一步:权重转换
原生模型权重是PyTorch格式,先转换成扁平二进制文件,C++里直接加载,不用解析复杂格式:
# 安装依赖
pip install numpy torch transformers

# 执行转换脚本
python init_model.py
脚本会自动下载预训练权重,转换成float32原始二进制文件,输出到weights/目录,同时生成分词器词表文件。
5.3 第二步:编译引擎
cd runtime
cmake -B build -S . -DCMAKE_BUILD_TYPE=Release
cmake --build build --config Release
编译完成后生成三个可执行文件:
gpt_runner:主推理程序,自回归生成文本test_runner:单元测试,验证算子正确性benchmark_runner:性能基准测试,分层统计耗时
5.4 第三步:运行推理
Linux/macOS下运行:
./build/gpt_runner "请输入你的提示词"
Windows下运行:
.\build\Release\gpt_runner.exe "请输入你的提示词"
5.5 性能基准测试
./build/benchmark_runner
会输出每层算子的耗时统计,方便定位瓶颈。
六、落地用途与场景
6.1 CUDA优化学习与实战
整个项目是非常完整的CUDA推理优化实战教程,从朴素基线到四轮优化,每一步都有明确的问题、方案、代码、收益,非常适合学习大模型推理优化、CUDA内核开发。
6.2 端侧与嵌入式推理
纯C+++轻量依赖的实现,可以很方便地移植到端侧设备、嵌入式系统,不需要庞大的框架依赖,定制化程度高。
6.3 高性能推理底座
可以作为自定义推理引擎的基础底座,在此基础上继续扩展量化、多卡、KV缓存压缩等功能,打造自己的端侧推理方案。
6.4 性能基准参考
完整的分层性能数据,可以作为自己优化推理引擎的基准参照,验证不同优化手段的实际收益。
If you need the complete source code, please add the WeChat number (c17865354792)
七、总结
这套从零实现的GPT推理引擎,用四轮工程优化,把朴素实现的性能提升了上千倍,也完整展示了大模型推理优化的标准路径:从算子本身,到缓存策略,到内存带宽优化,再到调度与融合。
它最大的价值不是最终跑得多快,而是把每一步优化的逻辑、代码、效果都讲得明明白白,是学习大模型底层推理优化的绝佳实践案例。
Welcome to follow WeChat official account【程序猿编码】
更多推荐


 1
 0
- 0


 已为社区贡献18条内容

所有评论(0)