


- @x2356095


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
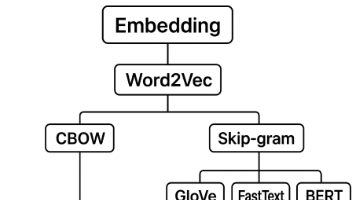
Embedding是将高维数据转换为低维向量的技术,可保留语义信息并计算相似度。典型应用包括:1)推荐系统,通过向量相似度推荐相关内容;2)语义搜索,使用预训练模型生成句子向量进行智能检索;3)异常检测,通过向量距离发现异常数据;4)图像检索,利用深度学习模型提取特征向量进行相似图片搜索。这些场景都依赖向量数据库存储和高效查询嵌入向量,实现了从关键词匹配到语义理解的跨越。
AI大模型时代的分层与应用 摘要:AI大模型时代呈现出明显的技术分层结构:基础层(模型训练与基础设施)→产品层(AI产品开发)→应用层(终端用户)。大语言模型(LLM)如GPT、Gemini等具有参数量大(千亿级)、训练数据广、通用性强等特点,基于Transformer架构,通过预训练+微调模式实现多样化任务处理。典型应用包括自然语言处理、编程辅助和知识问答等,但也面临算力需求高、幻觉问题等挑战。
清晰明确: 直接告诉AI要做什么。提供背景: 给它完成任务所需的信息。设定约束: 明确长度、格式、风格、禁止内容等。善用示例: 展示几个输入-输出样例是最快教会AI的方法之一。分步引导: 复杂任务拆解步骤。赋予角色: 让AI代入特定身份思考。迭代优化: 很少有提示能一次完美。根据AI的反馈不断调整你的提示是常态。看到不满意的输出,思考是哪里指令不清,然后修改提示再试。结构化提示:合理使用syste
AI大模型时代的分层与应用 摘要:AI大模型时代呈现出明显的技术分层结构:基础层(模型训练与基础设施)→产品层(AI产品开发)→应用层(终端用户)。大语言模型(LLM)如GPT、Gemini等具有参数量大(千亿级)、训练数据广、通用性强等特点,基于Transformer架构,通过预训练+微调模式实现多样化任务处理。典型应用包括自然语言处理、编程辅助和知识问答等,但也面临算力需求高、幻觉问题等挑战。