- @weixin_69359007


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
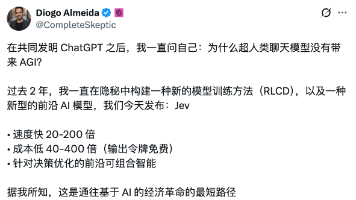
当大模型竞逐“更会聊天”时,Jev 以“只做选择题”的 System 1 模型异军突起,由 ChatGPT 共同发明人 Diogo Almeida 创立,主打快速决策。仅3天后,独立研究者 Nandakishor 用开源模型 Laya 实现32.8ms响应,快7.8倍,且完全免费。Laya 不仅速度碾压,多语言与长上下文能力也领先,引发开源反击热潮。文章深度对比二者性能、应用场景及真实坑点,揭示:
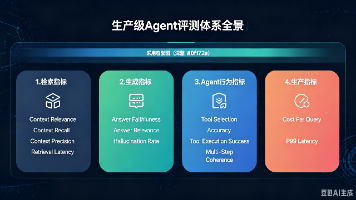
本文系统梳理生产级AI Agent评测体系建设,涵盖四大类12项指标(检索、生成、Agent行为、生产)及五大评测方法,强调端到端Trace级评估与持续闭环,附代码示例,为提升Agent可靠性与降本提供实战参考。
LLM Wiki是由AI专家Andrej Karpathy提出的新型知识管理架构,将大语言模型作为核心知识编译器,实现知识的自动化组织与持续进化。与传统RAG技术相比,LLM Wiki具有三大核心优势: 知识积累性:新资料入库自动更新现有知识网络,形成知识复利 结构完整性:预编译的Markdown维基提供更连贯的知识表达 维护自动化
AI领域迎来史诗级对决:DeepSeek V4 Pro/Flash、Grok 4.6、GLM 5.3、Gemini 3.7 Flash五款大模型在48小时内密集发布。本文从架构、跑分、实测、性价比等维度深度横评: 技术亮点:DeepSeek V4 Pro采用混合注意力架构,1M上下文计算效率提升73%;Grok 4.6实现推理速度翻倍;GLM 5.3纯后训练升级;Gemini 3.7 Flash主
国产大模型GLM-5.2在编程与设计领域实现全球领先 智谱AI推出的GLM-5.2模型在2026年6月正式开放,成为全球首个在编程(Code Arena、FrontierSWE)和设计(Design Arena)领域同时登顶的国产大模型。其核心技术采用MoE稀疏混合专家架构(7440亿参数,单次推理仅激活400亿)和动态稀疏注意力(DSA),支持1M token长上下文稳定处理,并通过开源MIT协
Kimi K3的发布,不仅刷新了开源模型的参数上限,更重新定义了高性能AI的获取方式。本地微调自由:企业可将模型部署于私有机房,结合业务数据进行定制化训练;审计透明自由:开发者可审查权重与推理过程,确保模型行为符合预期;私有部署自由:金融、医疗等高合规行业可在不泄露敏感数据的前提下使用前沿AI能力。正如月之暗面官方所言:“K3的整体表现仍落后于Claude Fable 5和GPT-5.6 Sol,
国产大模型GLM-5.2在编程与设计领域实现全球领先 智谱AI推出的GLM-5.2模型在2026年6月正式开放,成为全球首个在编程(Code Arena、FrontierSWE)和设计(Design Arena)领域同时登顶的国产大模型。其核心技术采用MoE稀疏混合专家架构(7440亿参数,单次推理仅激活400亿)和动态稀疏注意力(DSA),支持1M token长上下文稳定处理,并通过开源MIT协
LLM Wiki是由AI专家Andrej Karpathy提出的新型知识管理架构,将大语言模型作为核心知识编译器,实现知识的自动化组织与持续进化。与传统RAG技术相比,LLM Wiki具有三大核心优势: 知识积累性:新资料入库自动更新现有知识网络,形成知识复利 结构完整性:预编译的Markdown维基提供更连贯的知识表达 维护自动化
阿里巴巴发布第三代图像生成模型Qwen-Image-3.0,核心突破在于"实用性"("实")。相比前代,该模型支持4.5k token长指令输入,可实现复杂布局生成;细节渲染达10px极小文字精度;原生支持12种语言和多种专业场景。技术架构采用创新的MMDiT(多模态扩散变换器),通过端到端联合建模、MSROPE位置编码等实现文本与图像的深度对齐。模型参数量达200亿,支持1024×1024分辨率
阿里巴巴于2026年7月19日发布通义千问旗舰大模型Qwen3.8-Max预览版,这是国内首个突破万亿参数的AI模型(2.4万亿总参数/350亿激活参数),采用MoE混合专家架构,支持百万Token上下文窗口和原生多模态处理(文本、图像、视频、文档)。 相比前代Qwen3.5,新模型参数规模增长6倍,在编程能力(可生成全栈应用)、长文本处理(100万Token准确率80%+)和多模态推理方面显著提