

写文章


- @weixin_49518391


简介
该用户还未填写简介
擅长的技术栈
未填写擅长的技术栈
可提供的服务
暂无可提供的服务
从jieba分词到BERT-wwm——中文自然语言处理(NLP)基础分享系列(7)
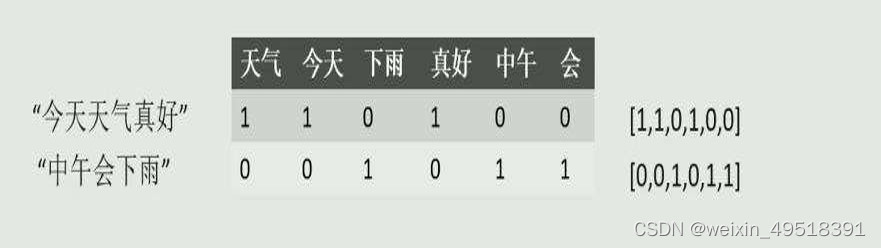
向量空间模型(例如TF-IDF),又被形象地称为『词袋』模型,就像是把文档里的词汇,放入到以词典作为标签的袋子里。 我们可以看到,基于词袋模型的文档表示方法,虽然考虑了词的重要程度,但它只是根据词的统计特性表示一个文档,而没有考虑到词在文中的次序。这样就有了一个新的思路:将文档表示成词编码的一个序列,这样词在文档上下文关系信息就能够保留下来。在李孟博士的原博客里,后续演示使用的是TensorFlo
从jieba分词到BERT-wwm——中文自然语言处理(NLP)基础分享系列(3)
要让电脑或是任何NLP 模型理解一篇新闻标题在说什么,我们要转换成它熟悉的形式:数字。在中文的语言特征里,文档的基本单位主要由词构成。中文文档的数字表示时,通常需要先做分词以及词的编码。借助 Jieba 这个中文分词工具,可以轻松实现中文的分词。完成分词之后,就可以进行文档的数字化表示。 可用的方法有很多,我们首先从常用的 TF-IDF文档向量表示方法入手。TF-IDF是一种向量空间模型(VSM:
到底了