


- @weixin_45876289


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
求一条曲线,使样本点均在此曲线的上下的不远处,所求的曲线叫为拟合曲线,它可以反映样本的总体分布,不至于出现局部较大的波动(龙格现象),能更好地反映出逼近函数的特性,在对给出的实验数据作曲线拟合时,使求得的逼近函数和已知函数之间的偏差的平方和达到最小,这就是最小二乘法的原理。为系数,表示截距和斜率。分布为一条拟合曲线。
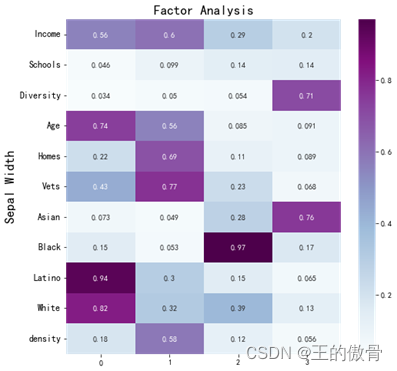
又因为求解的不唯一性,最后通常会对因子的载荷矩阵做一次正交旋转,为了:方便理解每个因子的意义。因子旋转的原因是提取公共因子的解有很多,而因子旋转后因子载荷矩阵将得到重新分配,可以使得旋转后的因子更容易解释。常用的方法是:方差最大法。存在某些相关性的变量提炼为较少的几个因子,用这几个因子去表示原本的变量,也可以根据因子对变量进行分类。、不是对原有变量的取舍,而是根据原始变量的信息进行重新组合,找出影
由于数据点通常都带有误差,误差为0往往意味着过度拟合,过拟合模型对于训练集以外的数据的泛化能力往往是较差的。因此,插值和拟合都是根据一组已知样本点,求变化规律和特征相似的近似曲线的过程。但是插值要求近似曲线完全经过所有的给定数据点,而拟合只要求近似曲线在整体上尽可能接近数据点,并反映数据的变化规律和发展趋势。1、在数模比赛中,需要用已知数据进行分析时,可能会出现已知数据缺失或不足的情况,此时可利用

可以使用所有这些参数并分析我们模型的性能,然后可以为我们的问题陈述选择最合适的模型。

TOPSIS 法是一种常用的综合评价方法,能充分利用原始数据的信息,其结果能精确地反映各评价方案之间的差距。(1)避免了数据的主观性,不需要目标函数,不用通过检验,而且能够很好的刻画多个影响指标的综合影响力度。(5)获得各评价对象与最优方案的相对接近程度,以此作为评价优劣的依据。(2)不确定指标的选取个数为多少适宜,才能够去很好刻画指标的影响力度。(2)再对正向化的矩阵进行标准化处理以消除各指标量
计算两条数据相似性时, Sklearn的K-Means默认使用的是欧式距离。如果要改变计算距离的公式时,可以改变K-means的源代码。结论:从这几次聚类的比较中可以看出,消费水平相近的省市聚集在一类。而北京、上海和广东很稳定的一直聚集在同一类中,在当k = 4时,这样的一种聚类可以比较明显的看出消费层级。、对于剩下的点,根据其与棸类中心的距离,将其归入最近的簇。个簇,使簇内具有较高的相似度,而簇

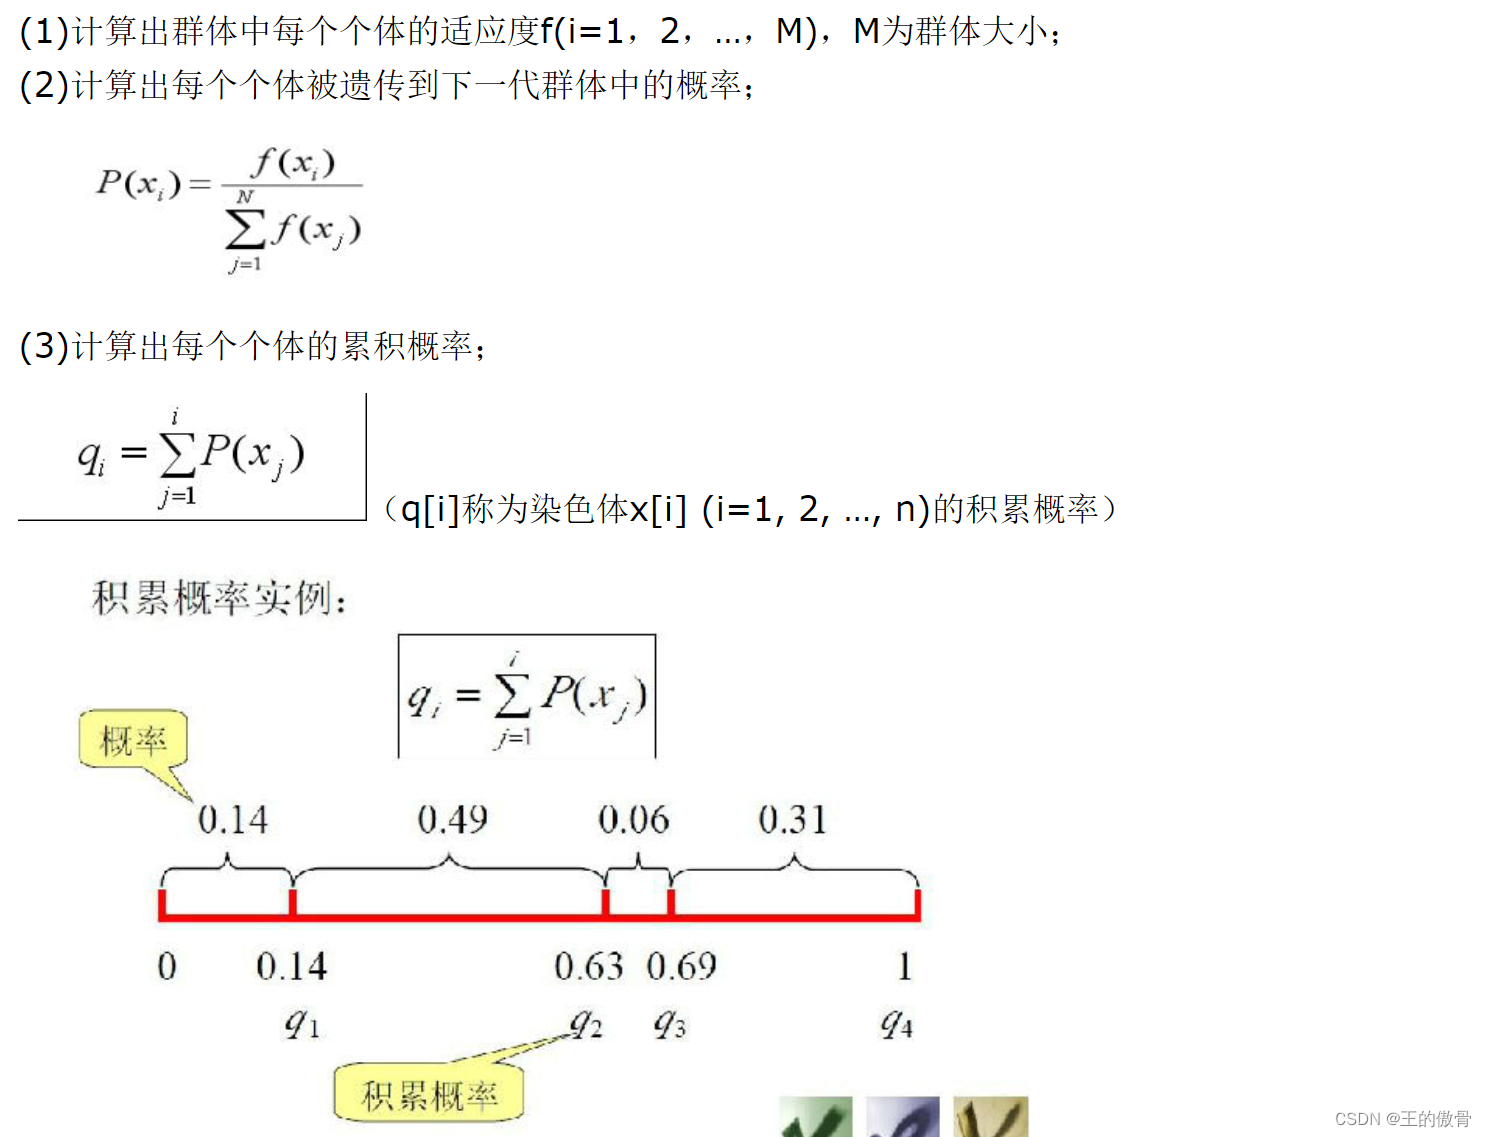
途经:13, 12, 0, 1, 11, 10, 9, 7, 6, 27, 14, 5, 4, 31, 29, 3, 30, 24, 20, 25, 32, 33, 26, 8, 22, 21, 19, 2, 17, 18, 16, 28, 23后回到原点。基本的遗传算法采用轮赌法进行,其基本的思想是各个个体被选中的概率与其适应度函数值大小成正比。评价一个个体(解)的好坏程度,适应度函数是遗传算法
模拟退火算法源于对固体退火过程的模拟,采用Metropolis准则,并用一组称为冷却进度表的参数控制算法的进程,使得算法在多项式时间里可以给出一个近似最优解。退火:将固体加热到足够高的温度,使分子呈随机排列状态,保持足够的时间,然后以适宜的速度逐步降温。先在一个高温状态下,然后逐渐退火,在每个温度下慢慢冷却,最终达到物理基态(相当于算法找到最优解)。它的目的是尽量使系统达到平衡,以使算法在有限的时
灰色系统理论是研究解决灰色系统分析、建模、预测、决策和控制的理论,是一般系统论、信息论、控制论的观点和方法在社会、经济、生态等抽象系统中的延伸,是运用经典数学知识解决信息不完备系统的理论和方法。灰色系统是指部分信息已知部分信息末知的信息不完备系统。灰色预测的主要特点是模型使用的不是原始数据序列, 而是生成的数据序列,即对原始数据作累加生成(或其它方法生成)得到近似的指数规律 再进行建模的方法。