- @weixin_45209433


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
后处理的输入,也就是backbone、Segment的输出,不管输入的原始图片多大,网络都是会letterbox到640x640的大小,经过backbone之后,输出特征层P3 P4 P5,每层的特征输入到Segment层后,输出对应的64维的目标框、80类的类别、以及32维的mask系数,以及学习的固定大小的prototype 160x160x32。Anchor-free类(例如FCOS)的目标

以下解析的代码来自:https://pjreddie.com/darknet/在对yolo_layer.c解析前,你需要知道的是:1、yolov3的网络结构yolov3的基础网络为darkent53,如下图:
一、下载安装tensorrt1.1 检查linux环境cat /usr/local/cuda/version.txt查看cuda版本号,我的是10.0.130cat /usr/local/cuda/include/cudnn.h | grep CUDNN_MAJOR -A 2查看cudnn的版本号7.6.4
yolov8的P5特征具有很强的应用的价值,之前也分析过,使用P5特征做特征比对,本文章是实操性的,用来将P5特征从yolov8中提取出来,这里的“提取来”,指的是将embeding的相关信息在yolo-tensorrt中提取。
gem时average pooling 的一般化gem 的公式如下:f(g)=[f1(g)...fk(g)...fK(g)]T=(1∣Xk∣∑xxpk)1pkf^{(g)} = [f_1^{(g)}...f_k^{(g)}...f_K^{(g)}]^T = (\frac{1}{|X_k|}\sum_xx^p{_k})^\frac{1}{p_k}f(g)=[f1(g)...fk(g)...fK(
1、经常使用pytorch的都知道,下面是pytorch加载自己数据的流程代码from torch.utils.data import Datasetfrom torch.utils.data import DataLoaderclass MyDataset(Dataset):def __init__(self)def __len__(self)def __getitem__(self, inde
一、Pseudo Labeling这个链接解释Pseudo Labeling解释的很清楚,可以看一看什么是Pseudo Labeling:Pseudo Labeling就是将测试集中,测试结果中分数很高的测试图片,加入到训练集中,再训练。Pseudo Labeling的5个步骤:1、使用原始训练集,训练一个模型,这里最好是比较好的模型;2、使用该模型去测试你的测试集,这里一般是没有标签的测试集;3
yolov4的发布,让很多做工程的都很兴奋,但其实静下来仔细研究,发现yolov4其实是一个成功的调参例子,作者用到了大量前人的技术,加以组合,实现了速度和精度的完美平衡,读yolov4的论文会发现,作者深厚的论文基础,以及对论文中技术的使用,都值得我们学习。工程项目中,算法搭建完之后,复杂的应用环境中,总是遇到各种各样的问题,使得算法精度上不去,算法停留到瓶颈出,只有尝试各种解决问题的方法
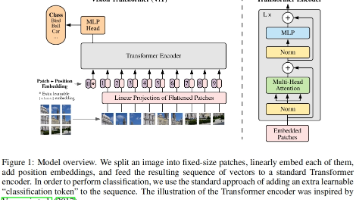
说实话,只看这个整体架构图,即使看了论文,还是不明白这个框架是什么,所以直接debug github 上的 vit-pytorch 中的VIT结构,先学习模型结构,再深入理解背后含义。
注意:首尾帧的长度是为了输入长度和输出长度一致!这个模块返回趋势项和波动项(高频),拆开是因为,模型希望趋势变化慢,希望波动项变化快。