- @weixin_43977163


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
端侧能跑模型的工具不止一个——llama.cpp、MLX、LM Studio、GPT4All……那为什么这一篇选 Ollama?因为 Ollama 把复杂度全藏起来了。你不需要懂 GGUF 格式、不需要手动选量化方案、不需要编译 C++ 代码、不需要配置 GPU 后端——一条命令就完事了。对大多数人来说,这就是最好的起点。但 Ollama 的底层其实就是 llama.cpp(在 Apple Sil
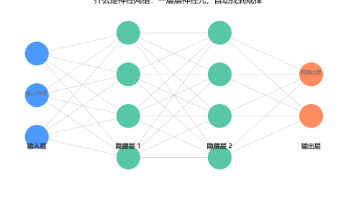
2023 年之前,"AI 会聊天"还只是科幻片里的桥段。但今天,一个网页、一次回车,它就能写出像样的文章、代码、方案。这篇用最通俗的方式,把大语言模型从「会打字」到「会思考」的秘密讲清楚,全程无代码、配图直观,小白也能看懂。
上一讲我们搞懂了 Token:计费按它算、上下文按它量、速度被它拖。这一讲把“上下文”三个字拆开——它是怎么运作的、瓶颈在哪、以及为什么你会产生“模型失忆”的错觉。一个直观的心智模型:上下文窗口 = 模型的工作台为什么窗口会满、满了之后模型到底干了什么KV Cache 是什么,为什么它决定了窗口能多大从 2K 到 2M 的窗口军备竞赛是怎么回事窗口大 ≠ 模型强,“大海捞针”测试暴露的真相三个实战
先说清楚这个系列要干什么。网上大模型教程分两种:一种太学术,开口就是“自注意力机制的多头缩放点积”,小白直接劝退;另一种太浅,教你怎么注册 ChatGPT 账号,看完还是不懂大模型到底咋运作的。用人话讲透每个核心概念,配代码和图,讲完你马上能用。从 Token 开始,一路讲到 Transformer、微调、RAG、Agent,15 篇读完,你对大模型的认知会从“会打字的魔法盒子”变成“一套可拆解可
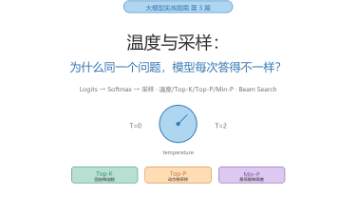
先纠正一个最常见的误区:很多人以为模型是先“想好”了一句话,再逐字输出。不是的。给定前面所有 Token,下一个 Token 是词表中每个词的概率分别是多少。Token概率“2”0.88“几”0.06“1”0.04“多”0.02“二”0.01……(剩下几万个)各自很小模型不知道“正确答案是 2”,它只知道“在它见过的所有训练数据里,1+1 等于后面最常出现的是 2”。那最终输出哪个?这就是采样策略
具体做法是让 Claude 给每个片段生成 50-100 Token 的上下文描述,把描述拼接在片段前面再做 Embedding。测试结果:Top-20 检索失败率从 5.7% 降到 1.9%,效果提升 67%。代价是每个文档需要额外调用一次 LLM 做摘要,但这是一次性成本。
这是《大模型实战指南》系列第五篇。前四篇我们聊了 Token、上下文窗口、温度采样、Embedding 向量检索,都在拆解大模型本身的“内部零件”。从这一篇开始,视角变了——我们不再盯着模型本身,而是看如何在模型外面搭一套系统,让它真正稳定干活。让 AI 改一个按钮颜色,它把整个页面布局重写了明明说了“单文件不超过 200 行”,几轮对话后 AI 写了个 1000 行的巨无霸让 AI 修一个 Bu
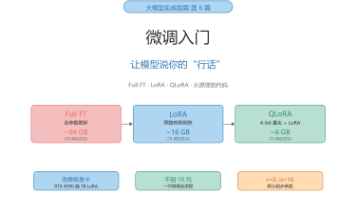
这是《大模型实战指南》系列第六篇。前五篇拆的是大模型的“内部零件”——Token、上下文窗口、温度采样、Embedding、Harness。微调到底干了什么,为什么能干,以及你自己能不能干。先澄清一个最常见的误解:很多人以为微调就是“重新训练一个模型”。不是的。你用的是别人预训练好的模型(比如 Qwen、LLaMA),它已经花了数千张 GPU、数月时间、万亿级 token 学会了语言的底层规律。微
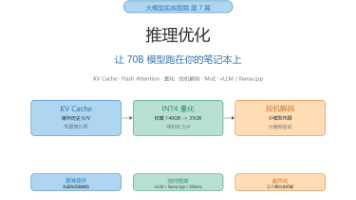
这是《大模型实战指南》系列第七篇。前六篇讲完了模型内部的 Token、上下文窗口、温度采样、Embedding、Harness,以及微调。这一篇解决“模型训好了,怎么让它跑得又快又省”的问题。很多人以为推理优化是“大厂才需要关心的事”。不是的。2026 年 8 月,DeepSeek V4 系列正式商用,采用峰谷分时定价——V4-Flash 空闲时段输出 4.5 元/百万 Token,高峰时段翻倍到
这是《大模型实战指南》系列第八篇。前七篇我们从 Token、上下文窗口、温度采样、Embedding、Harness、微调,一直讲到推理优化,把大模型从“会打字的魔法盒子”拆成了一套可操控的工程系统。这一篇解决最后一个高频痛点:模型能跑起来了,但一问“我们公司的报销流程”它就傻了。你大概也遇到过这种尴尬:模型知识储备再强,也答不出你们公司内部那 200 页《行政管理制度》里“出差住宿报销标准到底是