
大模型实战指南(8)——RAG 工程实战:让模型回答你的文档
大模型实战指南(8)——RAG 工程实战:让模型回答你的文档
这是《大模型实战指南》系列第八篇。前七篇我们从 Token、上下文窗口、温度采样、Embedding、Harness、微调,一直讲到推理优化,把大模型从“会打字的魔法盒子”拆成了一套可操控的工程系统。这一篇解决最后一个高频痛点:模型能跑起来了,但一问“我们公司的报销流程”它就傻了。
你大概也遇到过这种尴尬:模型知识储备再强,也答不出你们公司内部那 200 页《行政管理制度》里“出差住宿报销标准到底是多少”。它没读过这些文档,硬答就是一本正经地胡说。RAG(Retrieval-Augmented Generation,检索增强生成)就是干这个的——在模型回答之前,先从你的文档库里“查资料”,把查到的原文塞进上下文,再让模型基于这些材料回答。
先给个行业的清醒数字,别被 Demo 骗了。2026 年 7 月,Gartner 发布《企业级 AI 基础设施成熟度曲线》报告,指出超过 68% 的企业传统 RAG 项目,因为“复杂推理失败”和“全局认知缺失”没能跨越生产环境的鸿沟。换句话说,超过三分之二的 RAG 项目跑通了 Demo,却死在了生产线上。为什么?因为很多人做的 RAG 是“朴素 RAG”——最基础的版本,几乎从不在生产环境奏效。
更扎心的是,2026 年圈里还吵翻了一个话题:“RAG 已死”。逻辑是:Gemini 都给出 1M token 窗口、Claude 给到 200K、GPT-4.1 到 128K,凭什么不把文档全塞进上下文,还要折腾检索?这篇我会正面回答这个问题——长上下文不但没杀死 RAG,反而让 RAG 变得更值钱。与此同时,2026 年真正的前沿已经从“固定流水线”进化到 Agentic RAG(让模型自己决定怎么查),还冒出了 LLM Wiki(把知识库从“查询时做功”变成“摄入时编译”) 这类新范式。
这篇不给你背概念。我们从零搭一套能回答你私有文档的问答系统,把解析、切分、父子检索、Embedding、向量库、混合检索、Rerank、GraphRAG、Agentic RAG、评估这条完整链路拆透,再给你三个“真坑”和一套可跑的代码。
老规矩,先讲人话,再上技术,最后给代码。
一、朴素 RAG 是怎么死的
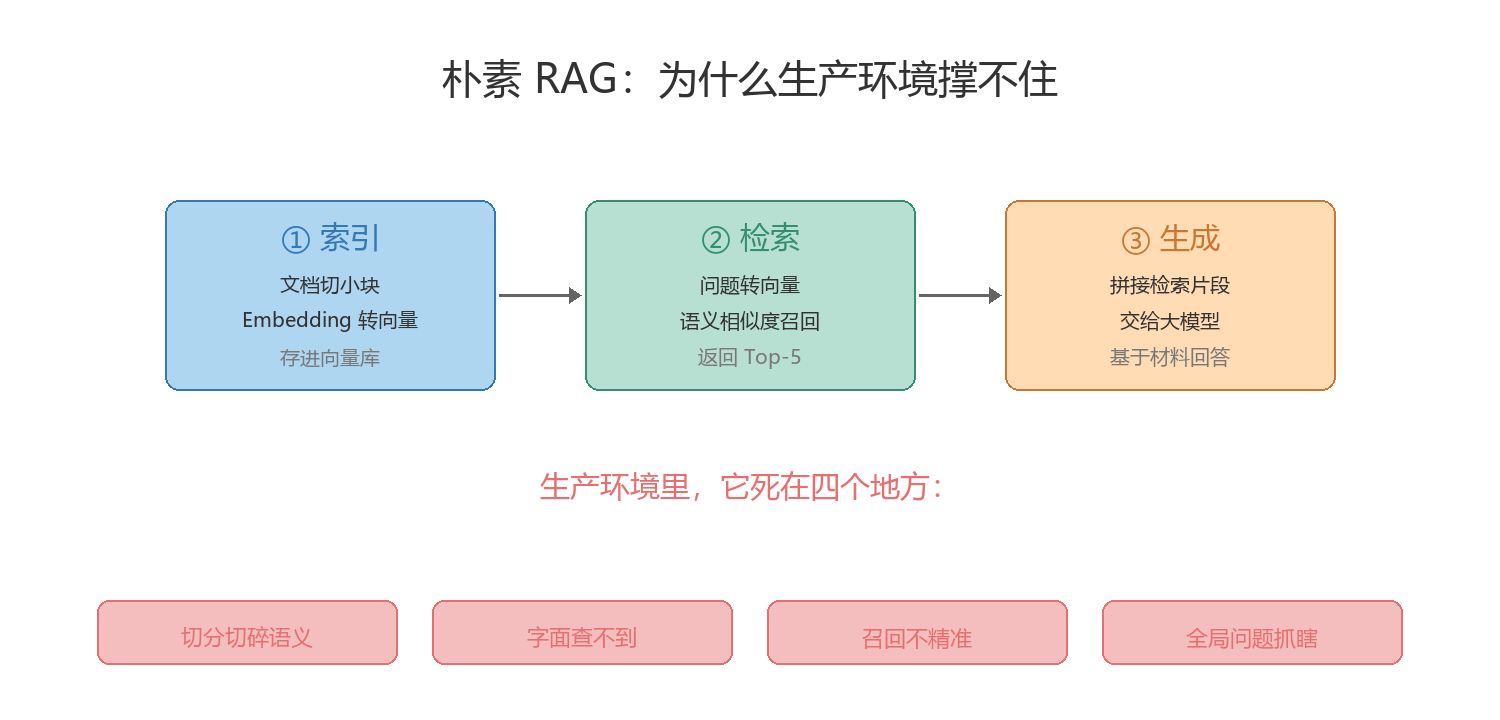
先看最基础的 RAG 长什么样。朴素 RAG 的流水线只有三步:
- 索引:把文档切成一堆小块,每一块用 Embedding 模型转成一个向量,存进向量数据库。
- 检索:用户提问时,把问题也转成向量,在向量库里找语义最相似的几个块。
- 生成:把这几个块拼进提示词,让大模型基于这些材料回答。
听起来天衣无缝对吧?但生产环境一跑,问题全出来了。
问题一:切分切得稀碎,语义被砍断。 固定按 500 字一刀切,正好把一个“报销流程”的上下文切成了两半,检索到的只是残缺信息,模型答了个寂寞。
问题二:查不到想要的。 用户问“差旅费怎么报销”,你的文档里写的是“出差申请、费用报销”,字面不同但语义相关。纯向量检索抓不到关键词命中的块,混合检索才能救。
问题三:查到的都对不上。 Top-5 召回回来一堆“相关”块,真答案混在里面,模型不知道该信哪条。Rerank 就是干这个的。
问题四:问的是全局问题。 “这套制度的主要变化是什么?”这种跨文档的全局问题,向量 RAG 天生抓瞎——它只能召回片段,给不了全局视野。这正是 GraphRAG 的舞台。
所以,判断一个 RAG 系统行不行,不看它 Demo 跑得多顺,而看它在上面这四个问题下还扛不扛得住。这篇就是逐一把它们解决。
二、2026 年,RAG 到底该不该“死”?
动笔前先回答那个绕不开的问题:长上下文时代,还要不要 RAG?
先看吵什么。2026 年模型窗口越来越大,有人提出“全塞进去”——把整份文档直接丢给模型,比搭 RAG 省事多了。这个想法在十几页的合同、一篇论文、一份会议纪要这些场景确实成立。
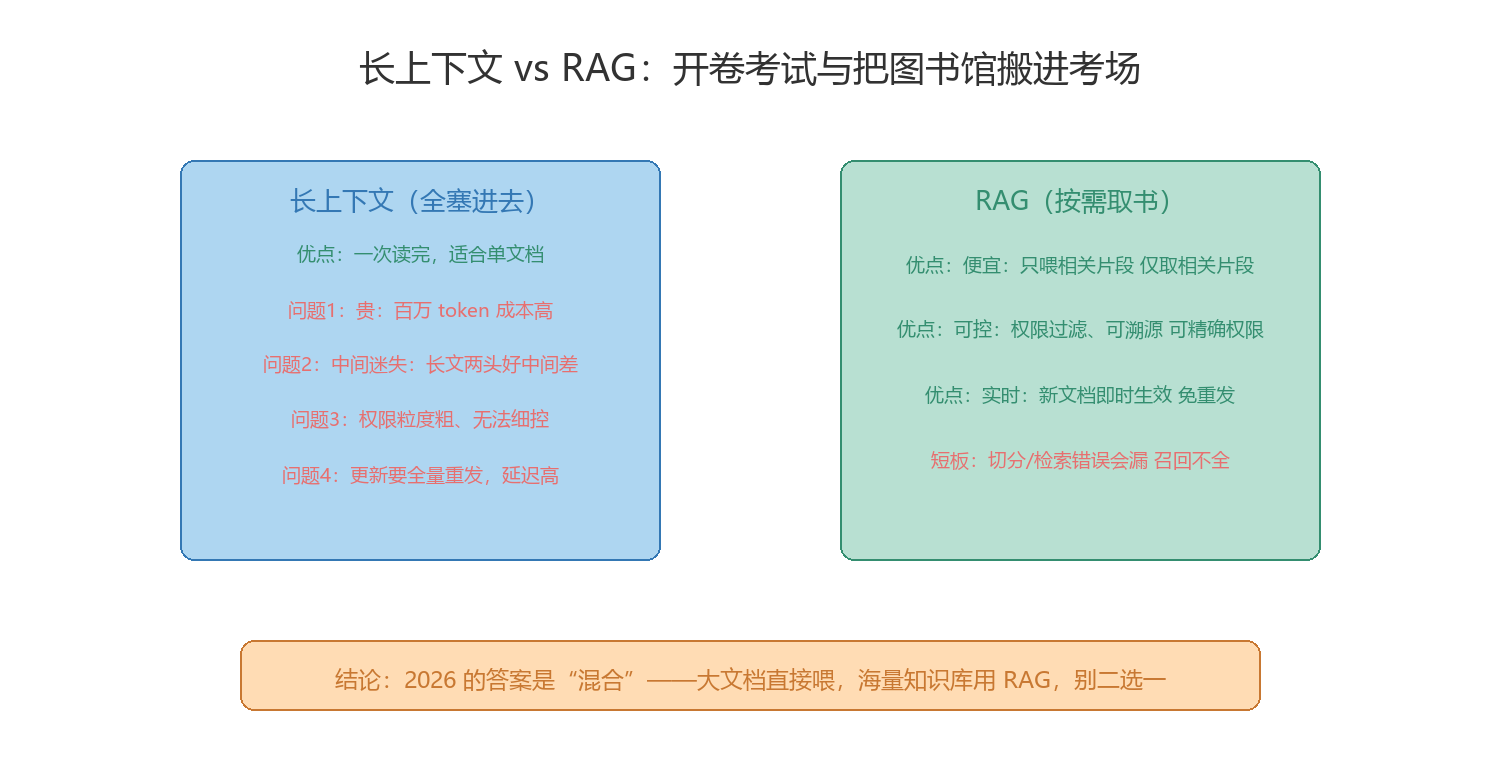
但你只要往下走两步,就会撞上四堵墙:
| 约束 | 具体问题 |
|---|---|
| 成本与延迟 | 百万 token 一次调用,成本高、首字延迟大,每次问答都全量重算 |
| 中间迷失 | 长上下文模型普遍“两头好、中间差”(Lost in the Middle),塞得越多越容易漏 |
| 权限粒度 | 全塞进去=全量放权,没法做文档级/字段级的权限控制 |
| 更新与实时 | 文档一更新就要全量重发,做不到“插入即生效” |
一句话:长上下文是“把图书馆搬进考场”,RAG 是“开卷考试、按需取书”。2026 年的答案不是二选一,而是混合——小文档直接喂,大知识库用 RAG,这也是后面 Agentic RAG 的起点。
所以,RAG 没死,只是长大了。 从朴素 RAG 一路进化到生产级流水线,再到 2026 年的 Agentic RAG,它不是要被淘汰,而是在成为企业 AI 的核心基础设施。
三、一套生产级 RAG 的标准流水线
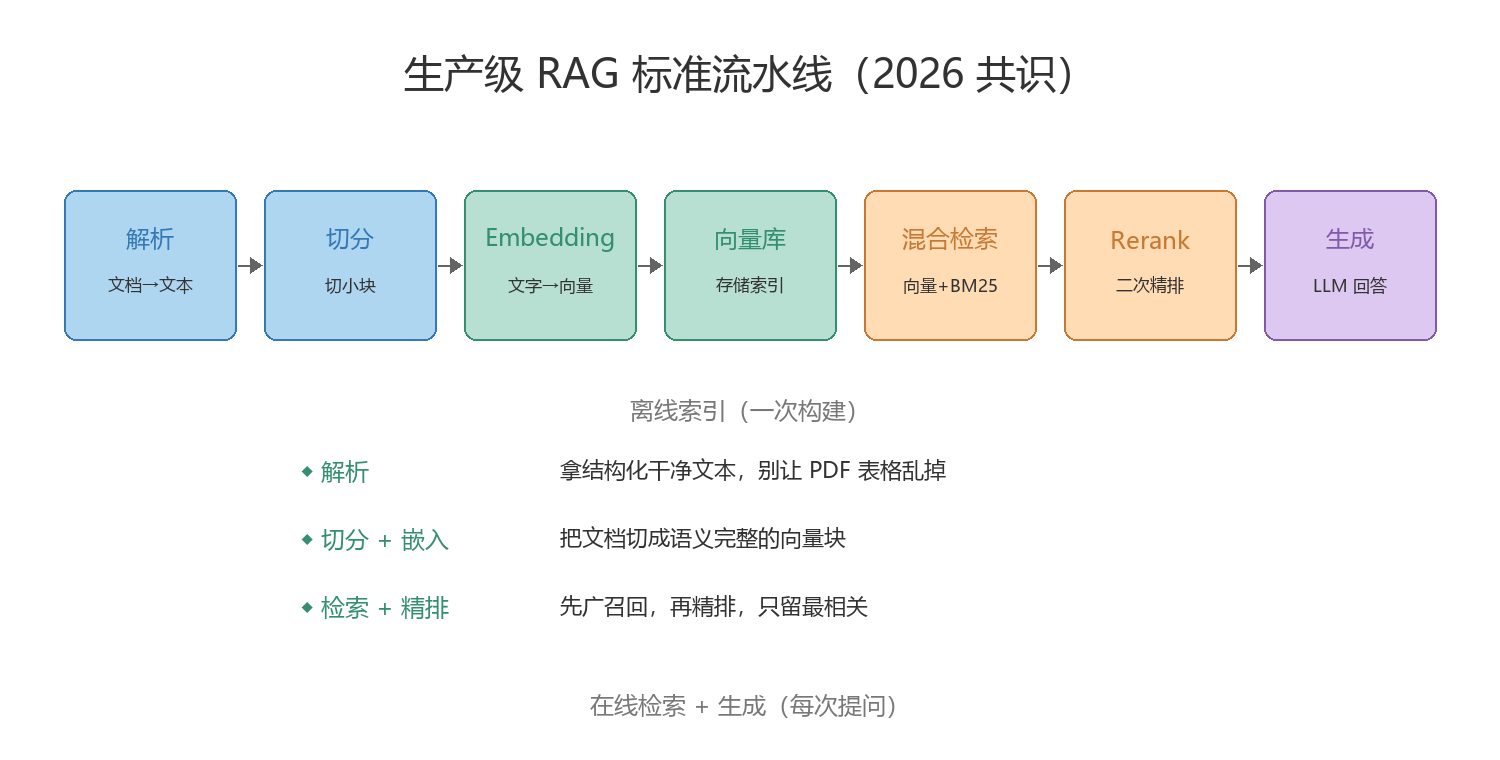
2026 年企业级知识库的技术栈已经收敛成一条清晰的标准流水线:
解析 → 切分 → Embedding → 向量库 → 混合检索 → Rerank → 大模型生成
我给你拆开。后面每一节都是其中一环,每环我都告诉你“为什么这么设计”“踩过什么坑”“代码怎么写”。这里先给你两个关键认识:
- 离线索引一次构建,在线检索每次提问。文档入库是“一次做功”,检索问答是“反复做功”,所以索引阶段多花时间是值得的。
- 标准流水线是基线,不是终点。跑通之后,再往 GraphRAG(第十章)、Agentic RAG(第十三章)演进。
先建个目录,我们后面所有代码都往里放:
mkdir -p rag_demo && cd rag_demo
python -m venv .venv && source .venv/bin/activate   # Windows 用 .venv\Scripts\activate
pip install openai chromadb sentence-transformers rank_bm25 pypdf
四、第一步:文档解析——PDF 是 RAG 的第一道坎
很多人文档还没进系统,就死在“解析”这一步。为什么?因为不是所有文档都是干净的文本。
- PDF:里面是文字,但可能有表格、图片、多栏排版。直接
PyPDF2抽出的是错乱文本,表格全乱。 - Word:
.docx本质是 XML,需要用python-docx解,图片和表格要单独处理。 - 扫描件:没有文字层,就是一张图,必须 OCR。
先说结论:解析这一步,别天真地以为“有个库就能读”。PDF 复杂时优先考虑保留结构的方案(如 PaddleOCR 能保留表格、公式、多栏布局)。普通人做 RAG,最常见也最稳的是先把 PDF 转成 Markdown(保留标题层级),因为标题层级是后续“语义切分”的关键信号。
一个最小可用的 PDF 文本提取示例:
from pypdf import PdfReader

reader = PdfReader("制度文件.pdf")
text = ""
for page in reader.pages:
    text += page.extract_text() + "\n"
print(text[:500])
坑 1:pypdf 提取的多栏 PDF 会“乱读”——左右两栏的文字会交叉。如果你要处理的是多栏论文/报纸,请直接走 OCR 方案(比如 PaddleOCR),不要硬扛。
坑 2:PDF 里的表格,extract_text 会丢掉结构,变成一行行散文本。这会让后面的切分把“表头”和“数据”切到不同的块里。
结论:解析这一步的目标是拿到“结构化”的干净文本,宁可用 OCR/结构化工具多花点时间,也不要在这一步省事导致后面全乱。
五、第二步:切分——RAG 的“地基”,切得好成功一半
切分(Chunking)是整个 RAG 系统里最被低估、又最容易翻车的一环。分块策略直接决定检索质量,地基不稳,后面全是白搭。
为什么需要切分?因为:Embedding 模型一次只能处理固定长度的文本,而且文档太长,一个向量“平均”了整篇语义,检索时相似度被稀释。所以必须把文档切成语义完整的小块。
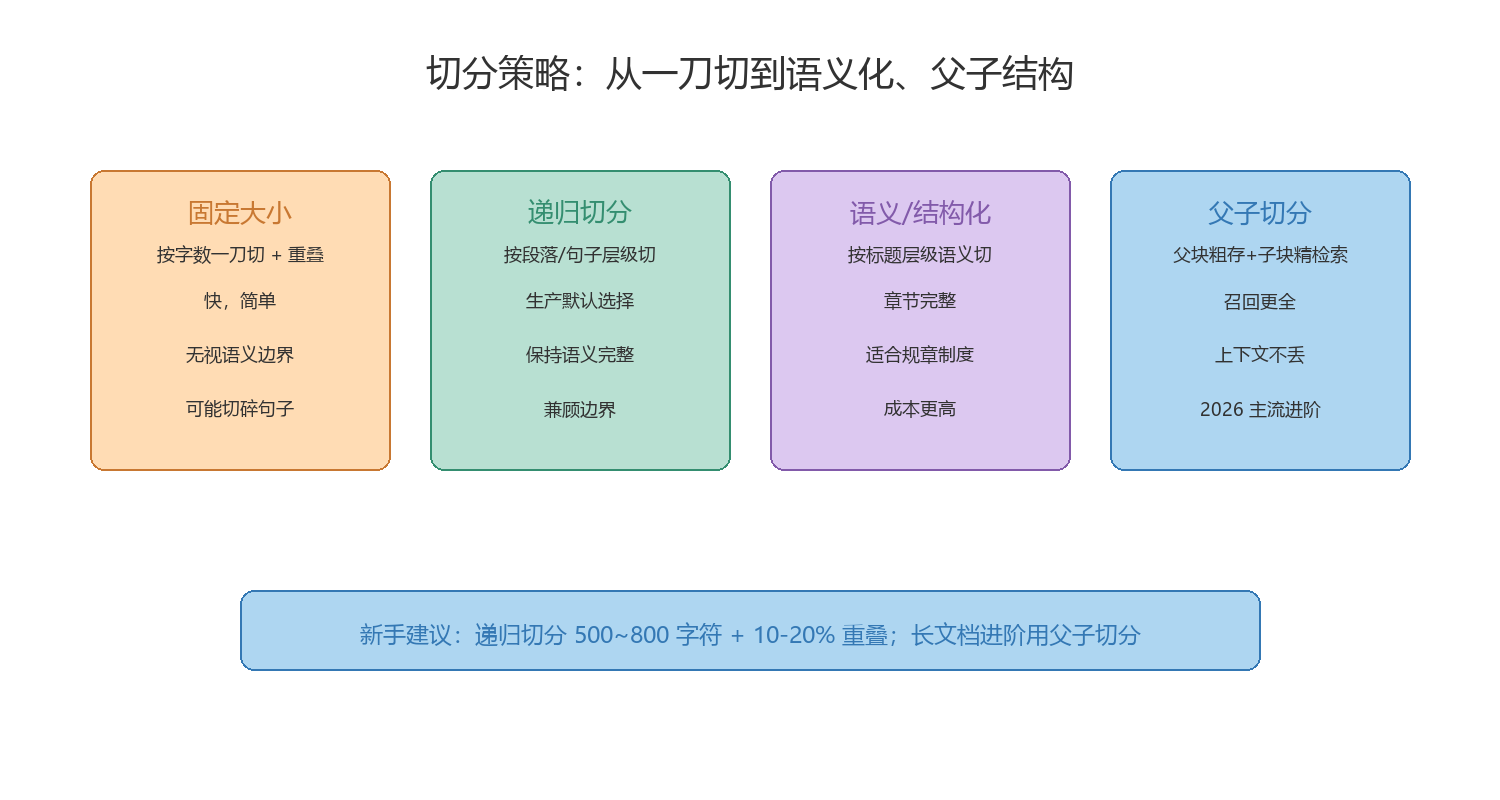
5.1 三种主流切分策略(加一种 2026 进阶)
① 固定大小切分(快但粗糙)
按字符数或 token 数一刀切,加一个 overlap(重叠)避免语义被切断。
def fixed_chunk(text: str, chunk_size: int = 500, overlap: int = 50) -> list[str]:
    """固定大小切分,带重叠。chunk_size 是字符数,overlap 是重叠字符数。"""
    chunks = []
    start = 0
    while start < len(text):
        chunk = text[start:start + chunk_size]
        chunks.append(chunk)
        start += chunk_size - overlap
    return chunks

chunks = fixed_chunk("出差申请需提前 3 天提交,住宿标准 700 元/晚,交通实报实销", chunk_size=500, overlap=50)   # 实测:500 字、50 重叠
优点:简单、快。缺点:完全无视语义边界——可能把一句话切两半,也可能把相关的内容硬拆开。
② 递归切分(默认选择)
按分隔符层级递归切:段落 → 句子 → 字符,优先在完整段落/句子处断开。这是 LangChain 的 RecursiveCharacterTextSplitter 的做法,也是大多数项目的默认选择。
from langchain_text_splitters import RecursiveCharacterTextSplitter

splitter = RecursiveCharacterTextSplitter(
    chunk_size=500,
    chunk_overlap=50,
    separators=["\n\n", "\n", "。", "!", "?", ".", " ", ""]
)
chunks = splitter.split_text(doc_text)
③ 语义切分/结构化切分(进阶)
利用 Markdown 的标题层级(#、##)切分,保持章节完整性;或按语义边界切分(如用 Embedding 判断语义断点)。这适合结构化文档,如规章制度、技术文档。
④ 父子切分(2026 进阶)
这是 2026 年生产级系统里越来越主流的一种做法:父块粗、子块细——把文档切成较大的“父块”用于保存上下文,再把父块切成更小的“子块”用于精确检索。检索时用子块命中,但把子块对应的父块喂给模型,这样既保住了精确命中,又不丢上下文。
给新手的一句忠告:用不着过度设计。 90% 的文档,RecursiveCharacterTextSplitter + 500~800 字符块 + 10% 重叠就够了。真出问题再考虑更复杂的策略。
5.2 切分的关键经验(高频踩坑点)
- 块大小与 Embedding 模型的输入上限匹配:很多 Embedding 模型单次最多 512 token(如
bge-large-zh-v1.5),切太大没用,超了还会被截断。新一代模型(如bge-m3)支持到 8192 token,可以切大块,但仍建议按语义边界切。 - 块太小 → 召回碎片:块太碎,一条完整信息被拆开,模型拼不回来。
- 块太大 → 相似度平均:块太大,向量“平均”了太多无关内容,检索命中率暴跌。
- 重叠(overlap)能救命:
chunk_overlap可以让切在边界的语义不丢失。
六、第三步:Embedding 选型——把文字变成向量
这一步要把每个文本块“转成一个向量”,好让计算机能算“相似度”。这就是第四篇详细讲过的 Embedding,这里不重复原理,只讲选型与实战。
Embedding 模型怎么选? 关键看三件事:效果、维度、速度/成本。
中文场景的推荐(2026 年常见方案):
| 模型 | 维度 | 说明 |
|---|---|---|
bge-large-zh-v1.5 | 1024 | 中文老牌选手,效果稳,本地可跑 |
text-embedding-v4(智谱) | 1024 | API 调用,中文效果好 |
OpenAI text-embedding-3-small | 1536 | 英文强、中文够用,API 调用 |
BAAI/bge-m3 | 1024 | 多语言 + 混合检索,2026 主流 |
注意:Embedding 模型的向量维度要和向量库的索引维度一致,选好后别乱换。
最小可用的 Embedding 代码(本地 sentence-transformers):
from sentence_transformers import SentenceTransformer

# 首次运行会下载模型,约几百 MB
model = SentenceTransformer("BAAI/bge-m3")

def embed(texts: list[str]) -> list[list[float]]:
    return model.encode(texts, normalize_embeddings=True).tolist()

vectors = embed(["出差申请需要填差旅报销单", "公司报销制度"])
坑:Embedding 模型一旦上线,别随意换。因为向量库里的旧向量和新模型维度/分布可能不一致,会导致全量重建。要换,就全量重跑一遍索引。
七、第四步:向量库选型——不是所有项目都要上 Milvus
很多人一上来就“我要上 Milvus”,其实先看数据规模。个人知识库几百条、小型 FAQ 一两万条,根本用不着分布式向量库。
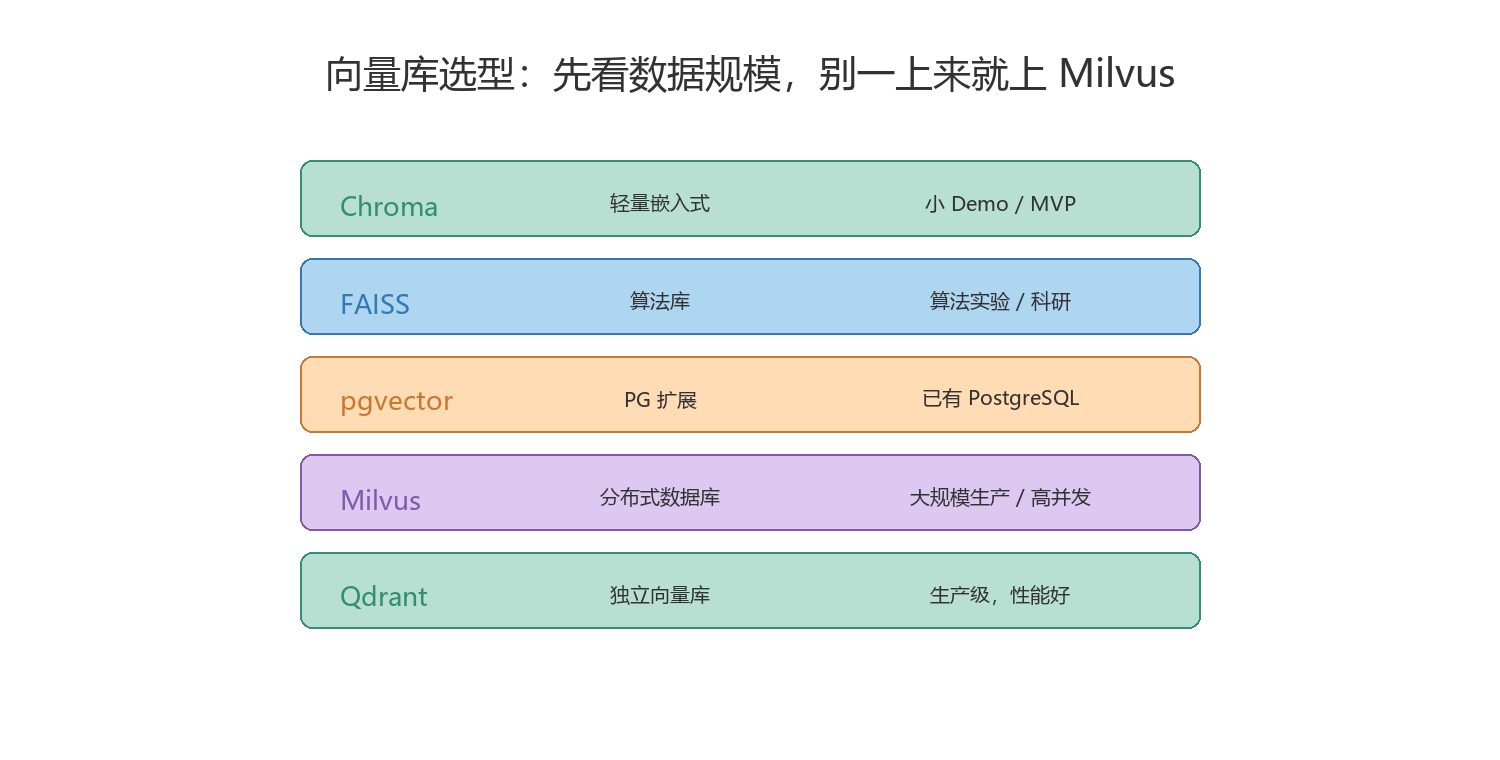
| 方案 | 定位 | 适用场景 |
|---|---|---|
| Chroma | 轻量嵌入式,Python 内置 | 个人 Demo、MVP 验证、小团队快速迭代 |
| FAISS | 算法库,非独立数据库 | 算法实验、科研、纯 Python 内存检索 |
| pgvector | PostgreSQL 扩展 | 已有 PG 库、想复用 SQL 基础设施 |
| Milvus | 分布式向量数据库 | 大规模生产、高并发、多租户 |
| Qdrant | 独立向量库(Rust) | 生产级,性能好,部署独立服务 |
选型一句话总结(来自业内共识):
- 小 Demo 用 Chroma
- 算法实验用 FAISS
- 已有 PostgreSQL 用 pgvector
- 大规模生产级优先 Milvus
给新手最简单粗暴的方案:开发阶段用 Chroma(零部署、开箱即用),等数据量真上来了再平滑切到 Milvus。别一上来就搭分布式,徒增运维成本。
Chroma 最小可用的代码:
import chromadb

client = chromadb.PersistentClient(path="./chroma_db")  # 本地持久化
collection = client.get_or_create_collection(name="docs")

# 写入(documents 是文本,embeddings 是向量,ids 是唯一 ID)
collection.add(
    documents=["出差申请流程:需提前填写出差申请单"],
    embeddings=embed(["出差申请流程:需提前填写出差申请表"]),
    ids=["doc_1"],
)

# 查询(查语义最接近的块)
result = collection.query(
    query_embeddings=embed(["差旅费怎么报"]),
    n_results=3
)
print(result["documents"])
八、第五步:混合检索 + Rerank——把“召回的块”变准
这一步是生产级 RAG 和朴素 RAG 的核心分水岭。纯向量检索有天生短板:重语义、轻字面。文档里写着“差旅报销”,用户问“出差怎么报”,向量能配上;但文档里写着一堆“报销”相关的,纯向量会召回来一堆噪音。
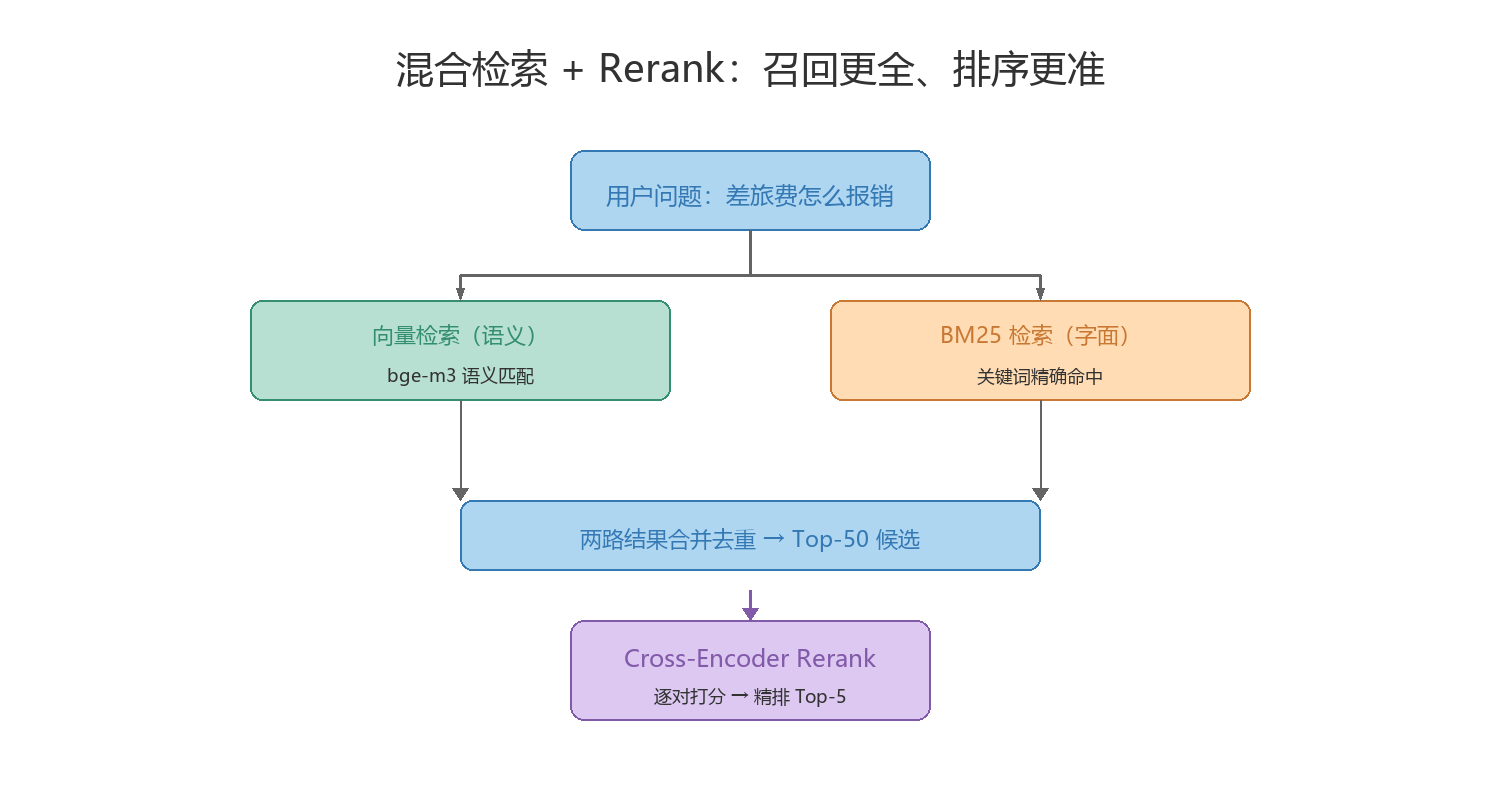
① 混合检索(Hybrid Search):同时用向量检索(语义)+ 关键词检索(BM25 字面匹配),把两路结果合并去重。这样既抓语义、又抓字面,互补。
② 重排序(Rerank):第一遍检索召回 Top-50(候选多、精度低),用一个交叉编码器(Cross-Encoder)对每一条候选和问题算一个“真实相关性”得分,重新排序,只取 Top-5。交叉编码器比双编码器(就是 Embedding 模型)精度高得多,因为它让问题和文档“逐对”深度融合。代价是慢,所以只对 Top-50 排一次,不做全量。
Rerank 最小代码(用 bge-reranker):
from sentence_transformers import CrossEncoder

reranker = CrossEncoder("BAAI/bge-reranker-v2-m3")

def rerank(query: str, candidates: list[str], top_k: int = 5):
    scores = reranker.predict([(query, c) for c in candidates])
    pairs = sorted(zip(candidates, scores), key=lambda x: x[1], reverse=True)
    return [c for c, s in pairs[:top_k]]
为什么 Rerank 效果立竿见影? 因为双编码器把“问题”和“文档”各自压缩成一个向量,信息损失了;交叉编码器让两者直接融合计算,精度天然更高。实测中,加了 Rerank,召回命中率常常翻倍,答案质量肉眼可见提升。
给新手的一个组合建议:向量检索 + BM25 + Rerank 是“2026 年标准配方”,先别整花活,这套就能打 90% 的局。
九、进阶:HyDE 与 Adaptive RAG
当你把基础流水线跑通,还想进一步,就轮到这些“花活”了。
9.1 HyDE(Hypothetical Document Embeddings)
核心思想:用户的问题往往太短,直接转向量检索容易不准。HyDE 的做法是先用 LLM 把问题“想象”成一段假想的文档/答案,再用这段假想的文档去向量库检索。因为“假想答案”比“短问题”在语义上更接近真实文档。
def hyde(query: str, llm):
    # 让 LLM 根据问题写一段“可能的答案”
    hy = llm(f"根据以下问题,写一段详细的解释性回答:{query}")
    return embed([hy])[0]  # 用这段假想答案的向量去检索
9.2 Adaptive RAG(自适应检索)
核心思想:不是所有问题都需要检索。简单问题(“1+1 等于几”)直接回答,复杂问题(“对比这两年制度差异”)才检索。通过一个“路由器”判断问题的复杂度,决定“要不要检索、检索几次、从哪个源检索”。2026 年报道称自适应检索能让准确率提升约 40%,同时减少不必要的 API 调用、降低成本。
def route(question: str):
    # 简单规则路由:含“定义”“是什么”等直接检索,含“总结”“对比”多检索
    if "是什么" in question or "定义" in question:
        return "retrieve_once"     # 检索一次
    if "对比" in question or "总结" in question:
        return "retrieve_many"     # 多次检索 + 多路
    return "direct"                # 直接回答
十、GraphRAG:从“检索文本”到“理解关系”
到了 2026 年,RAG 圈最火的技术之一就是 GraphRAG(图检索增强生成)。它是微软 2024 年 7 月开源的,目前 GitHub 超 31K Stars,是绕不开的话题。
10.1 为什么需要 GraphRAG
前面说了,传统向量 RAG 只能“按片段查相似”。但很多问题是跨文档的全局问题,比如“整个制度体系的主要变化是什么”“这个系统里模块 A 和模块 B 的关系”。这类问题信息分散在几十份文档、靠复杂关系关联,纯向量检索“只见树木,不见森林”。
10.2 GraphRAG 原理:四步
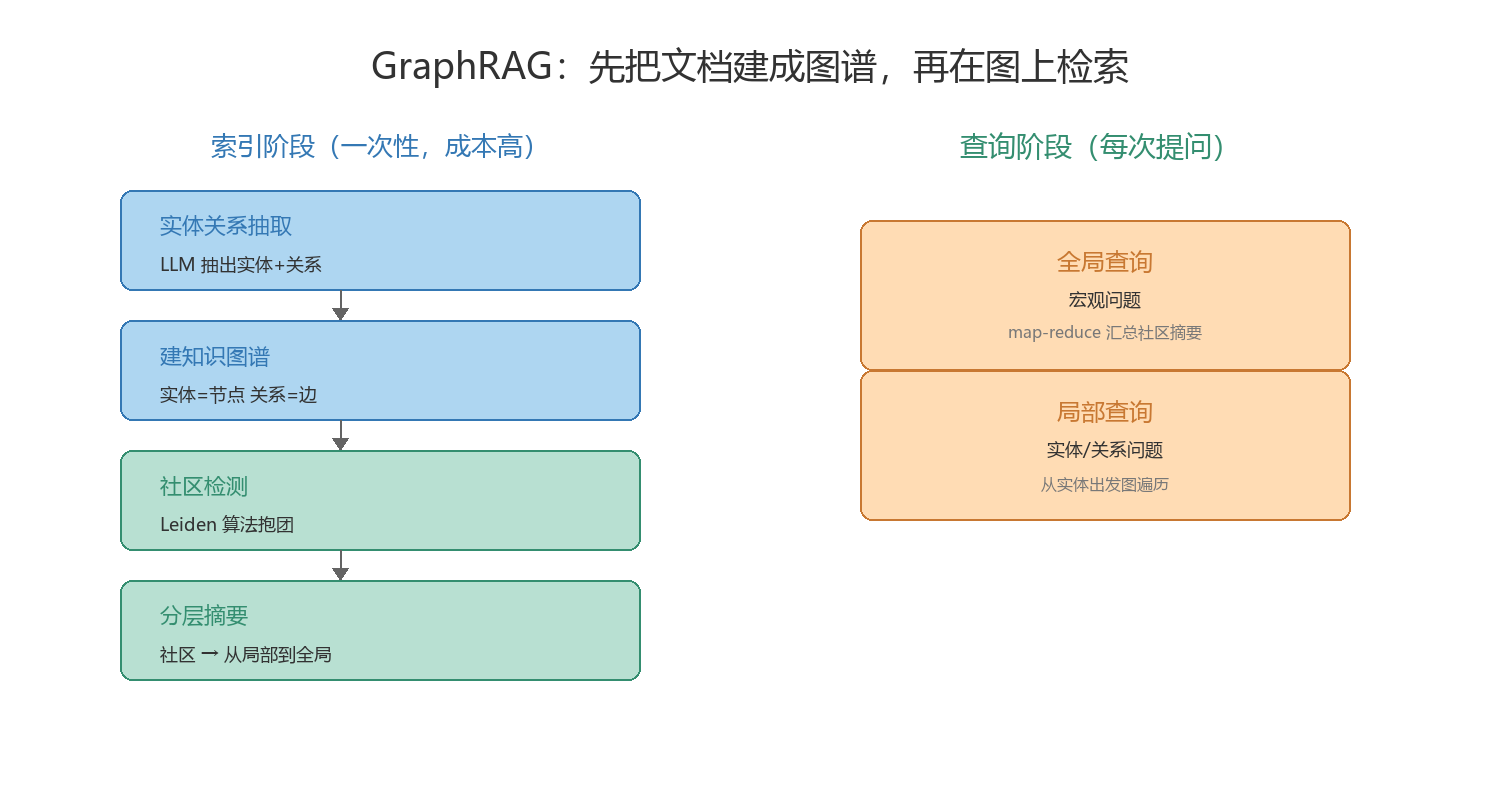
GraphRAG 的解决思路,一句话:先把文档建成图谱,再在图上做检索。它分两个阶段:
索引阶段(一次性,成本高):
- 实体关系抽取:用 LLM 从文档里抽出实体(人物、技术、组织、概念)和它们的关系(uses、depends_on……)。
- 建知识图谱:实体当节点,关系当边,构成一张图。
- 社区检测:用 Leiden 算法把图分成一个个“连接紧密的社区”(相当于一堆抱团的实体小组)。
- 分层社区摘要:对每个社区用 LLM 生成摘要,形成“从局部到全局”的分层结构。
查询阶段(每次查询):
- 全局查询(Global Search):面向宏观问题,用 map-reduce 方式把多个社区摘要汇总,回答“全局总结”类问题。
- 局部查询(Local Search):面向具体实体/关系问题,从相关实体出发做图遍历。
10.3 GraphRAG 的代价与适合场景
优点:擅长全局问题、多跳推理、跨文档综合分析。
代价:索引成本是传统 RAG 的 5-10 倍(因为每一步都要调 LLM),小数据集千万别用。
什么时候用 GraphRAG,什么时候用向量 RAG?
| 维度 | 向量 RAG | GraphRAG |
|---|---|---|
| 擅长问题 | “X 是什么”“怎么做 X” | “全局总结”“关系推理” |
| 索引成本 | 低 | 高(5-10 倍) |
| 跨文档推理 | 弱 | 强 |
| 适用数据 | 中小规模 | 大规模、关系复杂 |
给新手结论:大多数中小知识库,先把向量 RAG + 混合检索 + Rerank 做扎实;当你明确遇到“全局问题答不了”的瓶颈,再考虑 GraphRAG,别一上来就上。
十一、评估:别再凭感觉说“效果还行”
RAG 系统最坑的就是没法量化评估。很多人说“效果还行”,但一问“哪一环拖后腿”,答不上来。这里介绍 RAGAS 这套开源评估框架,它给 RAG 定义了 4 个核心指标:
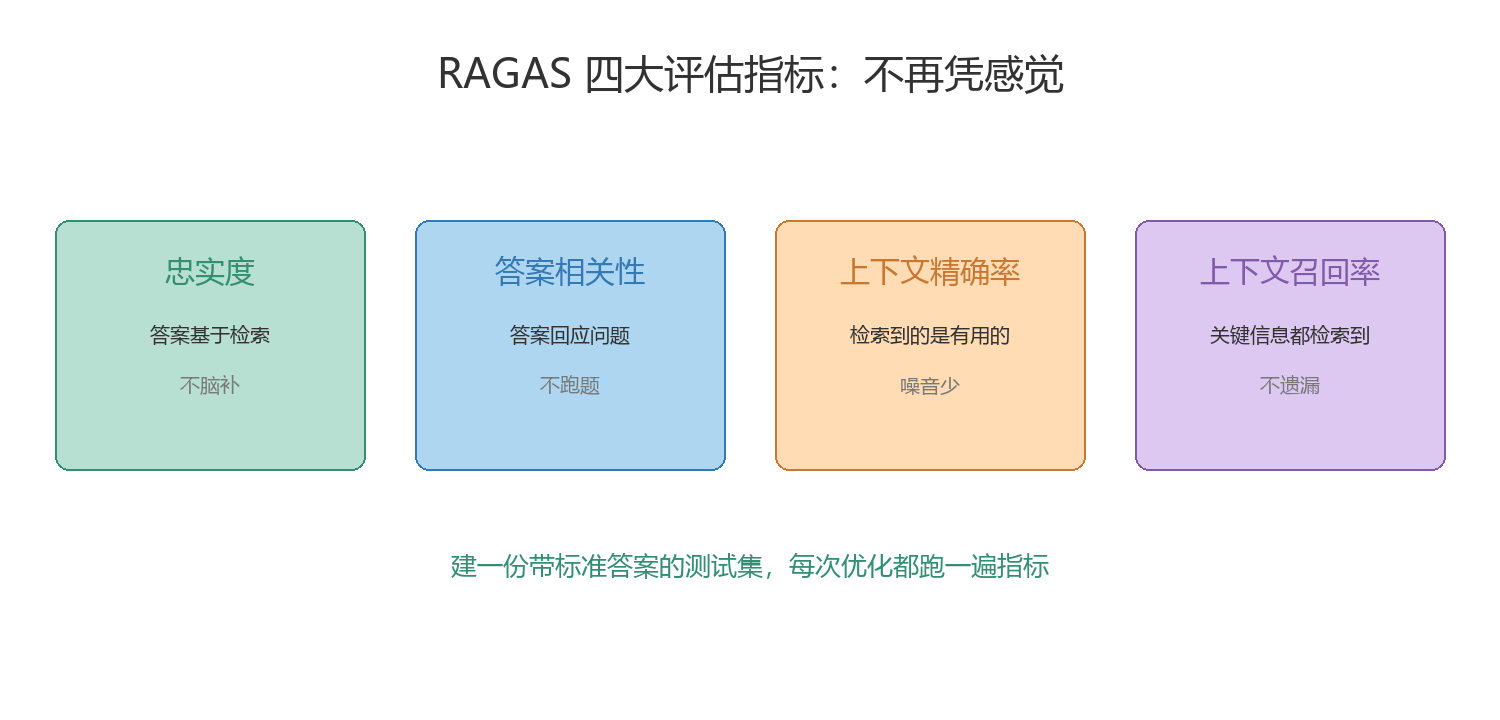
| 指标 | 含义 | 越高越好 |
|---|---|---|
| Faithfulness(忠实度) | 答案是否基于检索到的上下文,而非模型脑补 | 是 |
| Answer Relevancy(答案相关性) | 答案是否真的回应了问题 | 是 |
| Context Precision(上下文精确率) | 检索到的上下文里,有用的比例 | 是 |
| Context Recall(上下文召回率) | 该有的关键信息,有没有检索到 | 是 |
RAGAS 代码示例:
from ragas import evaluate
from ragas.metrics import faithfulness, answer_relevancy

dataset = {
    "question": ["差旅费报销标准是多少?"],
    "answer": ["按照制度,出差 7 天以内的,住宿标准为 400 元/晚。"],
    "contexts": [["出差 7 天内住宿标准 400 元/晚,超出需特批"]],
    "ground_truth": ["出差 7 天内住宿标准 400 元/晚"],
}
result = evaluate(dataset, metrics=[faithfulness, answer_relevancy])
print(result)
怎么用:准备一份带标准答案(ground truth)的测试集,每次优化流水线(比如改切分、加 Rerank)跑一遍,看 4 个指标升降。这样你才知道改了什么、改对了没有。这是生产级 RAG 的“体检报告”。
十二、怎么真正用起来:三种方式,从零代码到全手搭
前面十一章把 RAG 的每个环节拆透了,但你可能还在想:道理我都懂,具体怎么用?这一章给你三条路,按你的技术背景选——不想写代码的走第三条路,想掌控每个细节的走第一条路,想快速搭原型的走第二条路。
先看三条路的对比:
| 方式 | 工具 | 代码量 | 适合谁 |
|---|---|---|---|
| 方式一:全手搭 | Chroma + sentence-transformers + Ollama | 约 60 行 | 想理解每一步原理的开发者 |
| 方式二:框架快捷搭建 | LlamaIndex(5 行核心代码) | 约 10 行 | 想快速搭原型的开发者 |
| 方式三:零代码平台 | Dify(可视化拖拽) | 0 行 | 不写代码的产品/运营/测试 |
12.1 方式一:全手搭——从真实 PDF 到问答,一步不省
这种方式你全程控制每个环节:解析 PDF → 切分 → Embedding → 入库 → 检索 → Rerank → 调 LLM 生成。代码长一点,但每一行你都看得懂。
准备工作:先装好 Ollama 并拉一个本地模型(上一章讲过,这里不重复)。再准备一份 PDF 文档(比如你们公司的报销制度、产品手册),放到项目目录下。
# 确保已安装依赖
pip install chromadb sentence-transformers pypdf openai rank_bm25

# 确保已拉取本地模型(Ollama 兼容 OpenAI API)
ollama pull qwen3:8b    # 或别的你喜欢的模型
ollama serve            # 启动 Ollama 服务,默认端口 11434
完整代码(可直接保存为 rag_full.py 运行):
# rag_full.py —— 从真实 PDF 到问答的完整 RAG 全链路
import chromadb
from pypdf import PdfReader
from sentence_transformers import SentenceTransformer, CrossEncoder
from langchain_text_splitters import RecursiveCharacterTextSplitter
from openai import OpenAI

# ========== 1. 加载模型 ==========
embed_model = SentenceTransformer("BAAI/bge-m3")          # 中文嵌入模型
reranker = CrossEncoder("BAAI/bge-reranker-v2-m3")        # 重排模型

def embed(texts):
    return embed_model.encode(texts, normalize_embeddings=True).tolist()

# ========== 2. 解析 PDF ==========
def load_pdf(path):
    reader = PdfReader(path)
    text = ""
    for page in reader.pages:
        text += page.extract_text() + "\n"
    return text

# ========== 3. 切分 + 入库 ==========
def build_index(text, persist_dir="./chroma_db"):
    splitter = RecursiveCharacterTextSplitter(
        chunk_size=500, chunk_overlap=50,
        separators=["\n\n", "\n", "。", "!", ",", " ", ""]
    )
    chunks = splitter.split_text(text)
    print(f"切分完成:{len(chunks)} 个块")

    client = chromadb.PersistentClient(path=persist_dir)
    col = client.get_or_create_collection(name="docs")
    col.add(
        documents=chunks,
        embeddings=embed(chunks),
        ids=[f"chunk_{i}" for i in range(len(chunks))]
    )
    return col

# ========== 4. 检索 + Rerank ==========
def search(col, query, top_k=3):
    cands = col.query(query_embeddings=embed([query]), n_results=10)
    cand_docs = cands["documents"][0]
    scores = reranker.predict([(query, c) for c in cand_docs])
    ranked = sorted(zip(cand_docs, scores), key=lambda x: x[1], reverse=True)
    return [c for c, _ in ranked[:top_k]]

# ========== 5. 调 LLM 生成回答 ==========
def rag_answer(query, col, model="qwen3:8b"):
    ctx = "\n\n".join(search(col, query))
    prompt = f"请仅依据以下资料回答问题,若资料中没有则明确说明:\n\n资料:\n{ctx}\n\n问题:{query}"

    # 用 Ollama 的 OpenAI 兼容接口调用本地模型
    client = OpenAI(base_url="http://localhost:11434/v1", api_key="ollama")
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        temperature=0.1,
    )
    return resp.choices[0].message.content

# ========== 6. 运行 ==========
if __name__ == "__main__":
    # 第一步:解析 PDF 并建索引(只需跑一次,后续问答会复用持久化数据)
    text = load_pdf("公司报销制度.pdf")
    col = build_index(text)

    # 第二步:提问
    while True:
        q = input("\n你的问题(输入 q 退出):")
        if q.strip().lower() == "q":
            break
        print(rag_answer(q, col))
运行后你会看到一个交互式问答循环——输入问题,模型基于你的 PDF 回答,输完按 q 退出。这就是一个真正能用的私有文档问答系统。
几个关键点解释:
base_url="http://localhost:11434/v1":Ollama 原生兼容 OpenAI API 格式,所以你用openai库就能调本地模型,把base_url指向 Ollama 即可,api_key随便填(Ollama 不校验)。如果你用的是云端 API(如智谱、DeepSeek),把base_url和api_key换成对应平台的就行。temperature=0.1:RAG 场景要“老实回答”,温度调低,减少模型自由发挥。- 持久化:
PersistentClient会把向量库存到磁盘,下次启动不用重新索引。 - 中文 separators:
RecursiveCharacterTextSplitter的默认分隔符是英文标点,中文场景要加入「」、「!」、「,」,否则切分效果差。
如果你想用云端 API 替代本地 Ollama,只改一行:
# 智谱 GLM
client = OpenAI(base_url="https://open.bigmodel.cn/api/paas/v4", api_key="你的智谱key")

# DeepSeek
client = OpenAI(base_url="https://api.deepseek.com/v1", api_key="你的deepseekkey")

# 继续用模型名调用
resp = client.chat.completions.create(model="glm-4-flash", ...)
12.2 方式二:LlamaIndex 五行代码搞定 RAG
如果你觉得上面 60 行太长,LlamaIndex 帮你把解析、切分、Embedding、索引、检索、生成全部封装了。2026 年 RAG 场景下,LlamaIndex 在检索精度上已经领先 LangChain(多项基准测试 Recall@3 达 90%+),是 RAG 首选框架。
安装:
pip install llama-index llama-index-embeddings-huggingface llama-index-llms-ollama
核心代码(真的就这几行):
from llama_index.core import VectorStoreIndex, SimpleDirectoryReader
from llama_index.embeddings.huggingface import HuggingFaceEmbedding
from llama_index.llms.ollama import Ollama

# 1. 设置嵌入模型和 LLM
embed_model = HuggingFaceEmbedding(model_name="BAAI/bge-m3")
llm = Ollama(model="qwen3:8b", request_timeout=60.0)

# 2. 读取文档(支持 PDF、Word、TXT、Markdown 等,放一个文件夹里即可)
documents = SimpleDirectoryReader("./docs").load_data()

# 3. 建索引 + 创建查询引擎
index = VectorStoreIndex.from_documents(documents, embed_model=embed_model)
query_engine = index.as_query_engine(llm=llm, similarity_top_k=5)

# 4. 提问
response = query_engine.query("差旅费报销标准是多少?")
print(response)
LlamaIndex 帮你做了什么:
SimpleDirectoryReader自动识别文件格式(PDF/Word/TXT/Markdown/CSV),解析+切分全自动VectorStoreIndex自动建向量索引(默认内存,也可配置持久化)as_query_engine自动拼装“检索+生成”流水线- 默认就有 top-k 检索,你可以通过
similarity_top_k调
进阶:加 Rerank(LlamaIndex 同样支持):
from llama_index.core.postprocessor import SentenceTransformerRerank

reranker = SentenceTransformerRerank(model="BAAI/bge-reranker-v2-m3", top_n=3)
query_engine = index.as_query_engine(
    llm=llm,
    similarity_top_k=10,                    # 先粗召回 10 条
    node_postprocessors=[reranker]          # 再精排取 3 条
)
就这样,从“跑通”到“生产级”只多了三行代码。这就是框架的价值。
12.3 方式三:Dify 零代码——拖拽搞定知识库
如果你不写代码(产品经理、运营、测试工程师),或者想给团队搭一个“开箱即用”的问答系统,Dify 是 2026 年最火的零代码 AI 应用平台。
三步搞定:
- 部署 Dify:官方提供 Docker Compose 一键部署,或者直接用 Dify Cloud(免费额度)。
git clone https://github.com/langgenius/dify.git
cd dify/docker
docker compose up -d
打开浏览器访问 http://localhost,注册账号即可进入控制台。
-
创建知识库:点击“知识库” → 上传文档(支持 PDF/Word/TXT/Markdown)→ 选择切分策略(Dify 提供自动和自定义两种)→ 选择 Embedding 模型 → 点击“保存并处理”。Dify 会自动完成解析、切分、Embedding、入库,全程可视化,你能看到每个文档被切成了多少块。
-
创建应用:点击“创建应用” → 选择“聊天助手” → 关联刚才的知识库 → 选择 LLM(支持 Ollama/OpenAI/智谱等)→ 测试问答。满意后点“发布”,你就得到一个带网页界面的私有知识库问答系统,还能生成 API 接口给其他系统调用。
Dify 的优势:全程不写一行代码,可视化配置切分策略、检索参数、Rerank 开关,支持多知识库关联,还能做工作流编排。适合团队协作场景——开发搭好基础设施,业务人员自己管理知识库内容。
12.4 你该选哪种方式?
| 你的情况 | 推荐方式 | 理由 |
|---|---|---|
| 想深入理解 RAG 原理,每个环节都想自己调 | 方式一(全手搭) | 你能看到每一步的输入输出,知道问题出在哪 |
| 已理解原理,想快速搭原型或上线 | 方式二(LlamaIndex) | 框架封装好了一切,5 行核心代码,进阶也只需加几行 |
| 不写代码 / 要给团队用 / 要网页界面 | 方式三(Dify) | 零代码、可视化、自带前端,适合非技术人员 |
| 企业级生产环境 | 方式二 + 方式三结合 | 开发用 LlamaIndex 搭检索核心,部署用 Dify 做管理和前端 |
我的建议:先用方式一跑通理解原理(你现在已经有代码了),日常开发用方式二(省时间),给团队或客户交付用方式三(有界面、好维护)。三者不矛盾,是同一套技术的不同抽象层。
12.5 实际使用中你大概率会遇到的问题
这几个问题不是“坑”(坑放第十五章),而是正常使用中的常见疑问:
Q1:文档更新了怎么办?
索引阶段是“一次性”的,文档更新后要重新入库。全手搭方案:删掉 chroma_db 目录重跑 build_index。LlamaIndex 方案:调 index.refresh_ref_docs(new_docs)。Dify 方案:在知识库页面点“同步”,自动增量更新。
Q2:回答里出现了文档里没有的内容(幻觉)怎么办?
两个方向排查:一是检索没召回正确的内容(检查 search 返回的块对不对),二是模型没“老实”用检索结果(降低 temperature,或在 prompt 里强化“仅依据资料回答”的约束)。前者是检索问题,后者是生成问题,用 RAGAS 评估(第十一章)能帮你定位是哪一环。
Q3:一个 PDF 有几百页,索引很慢怎么办?
索引是“一次性做功”(第三章说过),慢一点没关系。但如果实在太慢,检查三件事:是不是 Embedding 模型在用 CPU 跑(有 GPU 会快 10 倍以上)、切分的块是不是太多了(增大 chunk_size)、是不是每次都在重复索引(用 PersistentClient 持久化)。
Q4:中文检索效果不好怎么办?
90% 的概率是切分的分隔符没配中文标点(方式一的代码里已经配了)。另外确保 Embedding 模型用的是中文模型(bge-m3 或 bge-large-zh-v1.5),别用英文模型硬套。
十三、迈向前沿:Agentic RAG——检索变成一次智能循环
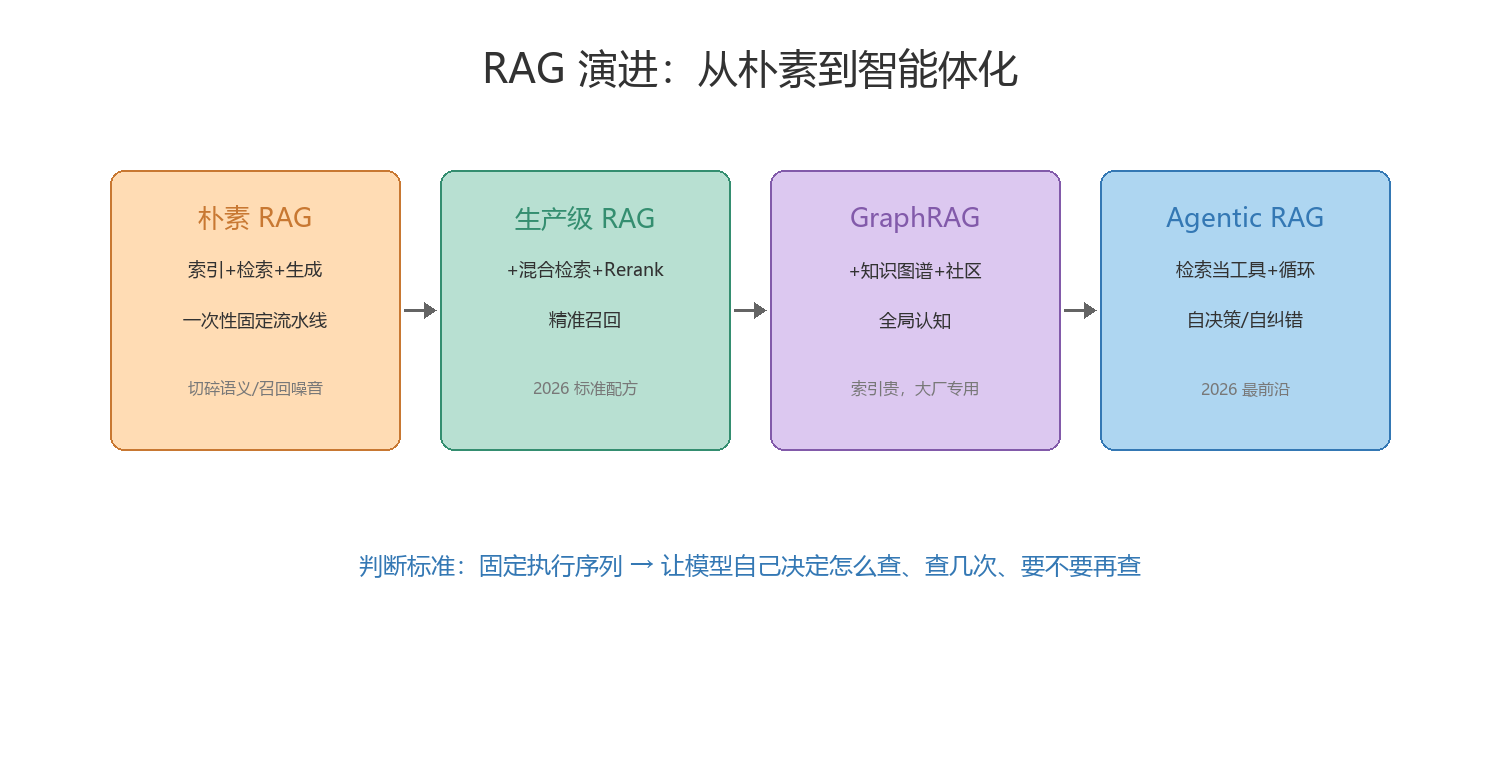
到这里,你已经把“生产级流水线”这套固定流程跑通了。但 2026 年最热的方向,是把 RAG 从固定流水线升级成 Agentic RAG(智能体化 RAG)。图 8 里最后一段就是它。
13.1 为什么需要 Agentic RAG
传统 RAG 有一个隐形的假设:所有问题都该用同一种方式检索。但真实业务不是这样——
- “差旅费标准是多少?”——一次检索就够,不需要绕。
- “对比 Q1 和 Q2 的报销差异,再告诉我原因”——需要多次检索,还要比对。
- “这篇文章的附录在哪、里面那个公式说了什么?”——需要先打开文档、定位、再读。
- “随便聊聊——你们公司有什么福利?”——根本不用检索,直接回答。
固定流水线只能对它们一视同仁:查一次、拼起来、回答。而 Agentic RAG 的思路是:把“检索”本身变成模型可调用的工具,让模型自己决定要不要查、查什么、查几次、要不要换一种查法。
13.2 Agentic RAG 的循环是怎么转的
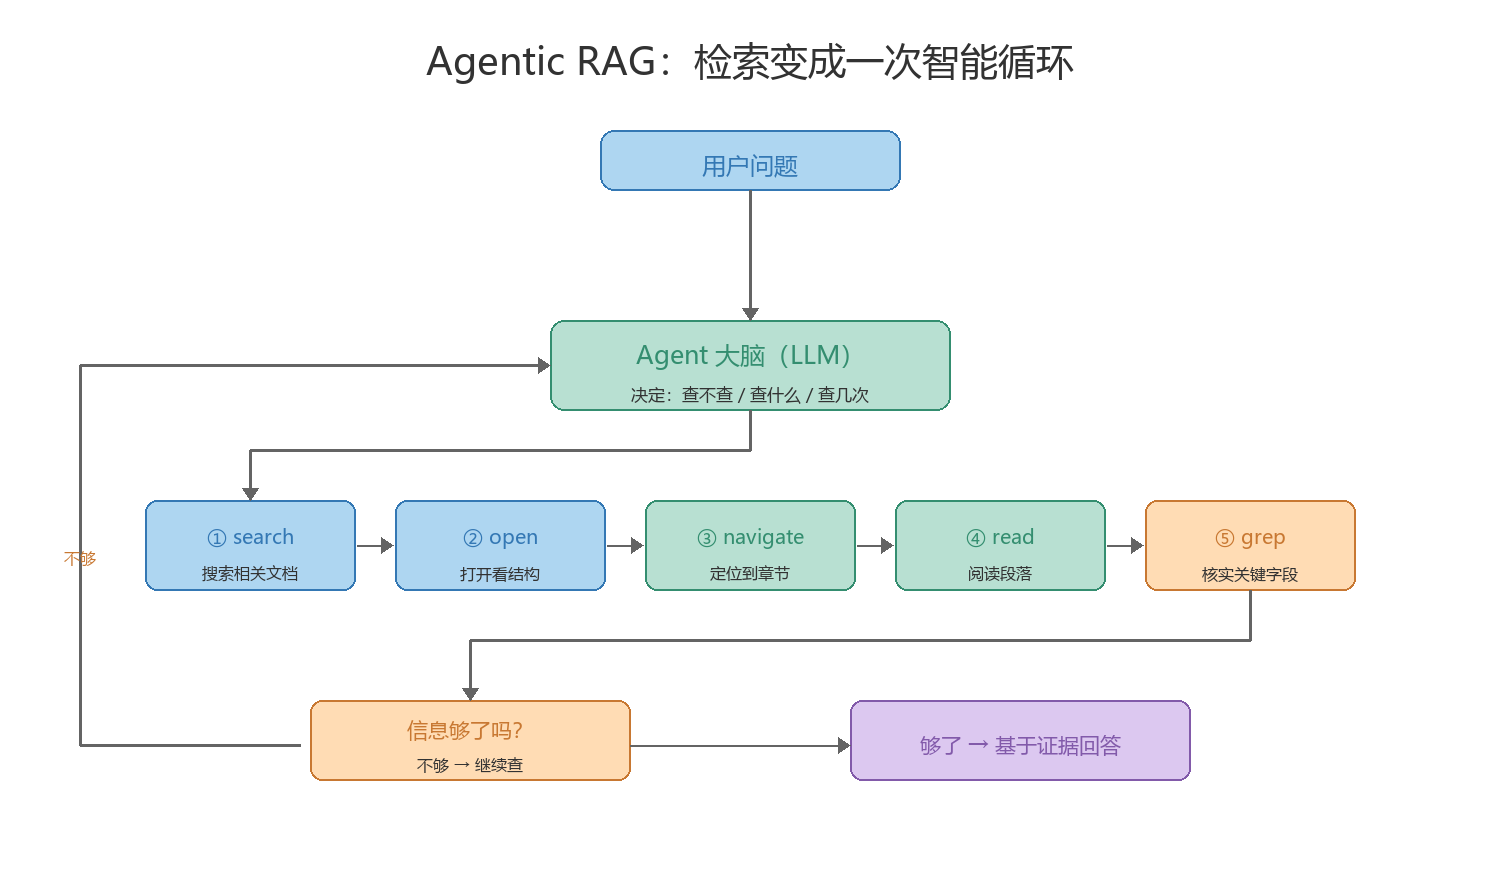
2026 年 8 月,Mistral 发布 Agentic Search,把多步检索循环推到了聚光灯下。它的核心是五个工具:search(搜索)→ open(打开)→ navigate(定位)→ read(阅读)→ grep(核实)。模型每调一次工具,都能看到返回结果,再决定下一步动作——查不够就继续查,够了就基于证据回答。官方数据显示,在 FinanceBench 上正确率从 26.7% 提升到 86%,p90 延迟还降低了 39.6%。
下面这张图就是 Agentic RAG 的循环结构:
你不需要照抄 Mistral 那五个工具。核心思想是一样的:
- Agent 大脑收到用户问题。
- 它判断“要不要检索、怎么检索”,然后调用检索工具(向量检索、BM25、Graph 遍历,甚至联网搜索)。
- 拿到结果后再判断:够了吗?不够→继续查;够了→生成回答。
- 不够的循环会自动调整查询词、换工具、换检索源,直到有把握。
13.3 最小可用的 Agentic RAG 代码
用 LangChain/LangGraph 搭一个最简的“检索 Agent”——它会把检索当工具,自主决定要不要检索、检索几次:
from langchain_core.tools import tool
from langchain_openai import ChatOpenAI
from langgraph.prebuilt import create_react_agent

@tool
def retrieve(query: str) -> list[str]:
    """从公司知识库检索与 query 最相关的文本块。"""
    cands = col.query(query_embeddings=embed([query]), n_results=5)
    return cands["documents"][0]

llm = ChatOpenAI(model="gpt-4o-mini", api_key="your-key")   # 可换任何 OpenAI 兼容模型
agent = create_react_agent(llm, tools=[retrieve])

result = agent.invoke({
    "messages": [{"role": "user", "content": "差旅费报销标准是多少?"}]
})
print(result["messages"][-1].content)
就这么简单:模型会在需要时自己调 retrieve 工具,调一次不够就调第二次,直到它觉得信息够了,再给最终答案。
给新手的判断标准:先把生产级流水线跑稳(第二章到第十二章),再上 Agentic RAG。Agentic RAG 不是替代流水线,而是把“检索决策”交给模型,让系统从“只会一条路”变成“能自己找路”。
十四、前沿:LLM Wiki——把知识库从“查询时做功”变成“摄入时编译”
2026 年 4 月,Andrej Karpathy 抛出了 LLM Wiki 这个概念,三个月内火遍全网。这一节讲讲它是什么、和 RAG 有什么关系、你要不要追。
14.1 一个扎心的观察:RAG 每次都在“从零开始”
Karpathy 点破了传统 RAG 的一个核心问题:查询时做功。你问 100 个问题,模型就做 100 次独立的检索+拼凑,每次都是从原始文档重新开始,没有积累。那些“被检索过、验证过、梳理过”的知识,全部随着对话消失。
他的思路是反过来:摄入时编译。文档进来时,先用 LLM 把它“编译”成一份结构化的 Markdown Wiki——有目录、有交叉引用、有摘要、有更新日志。以后问答都基于这份 Wiki,而不是每次都去原始文档里捞。知识的累积、交叉引用、甚至自修正,都发生在“编译”阶段。
14.2 三大范式的定位(不是替代,是分层)
2026 年的业界共识是:向量 RAG、GraphRAG、LLM Wiki 三者不是替代关系,而是分层协同。
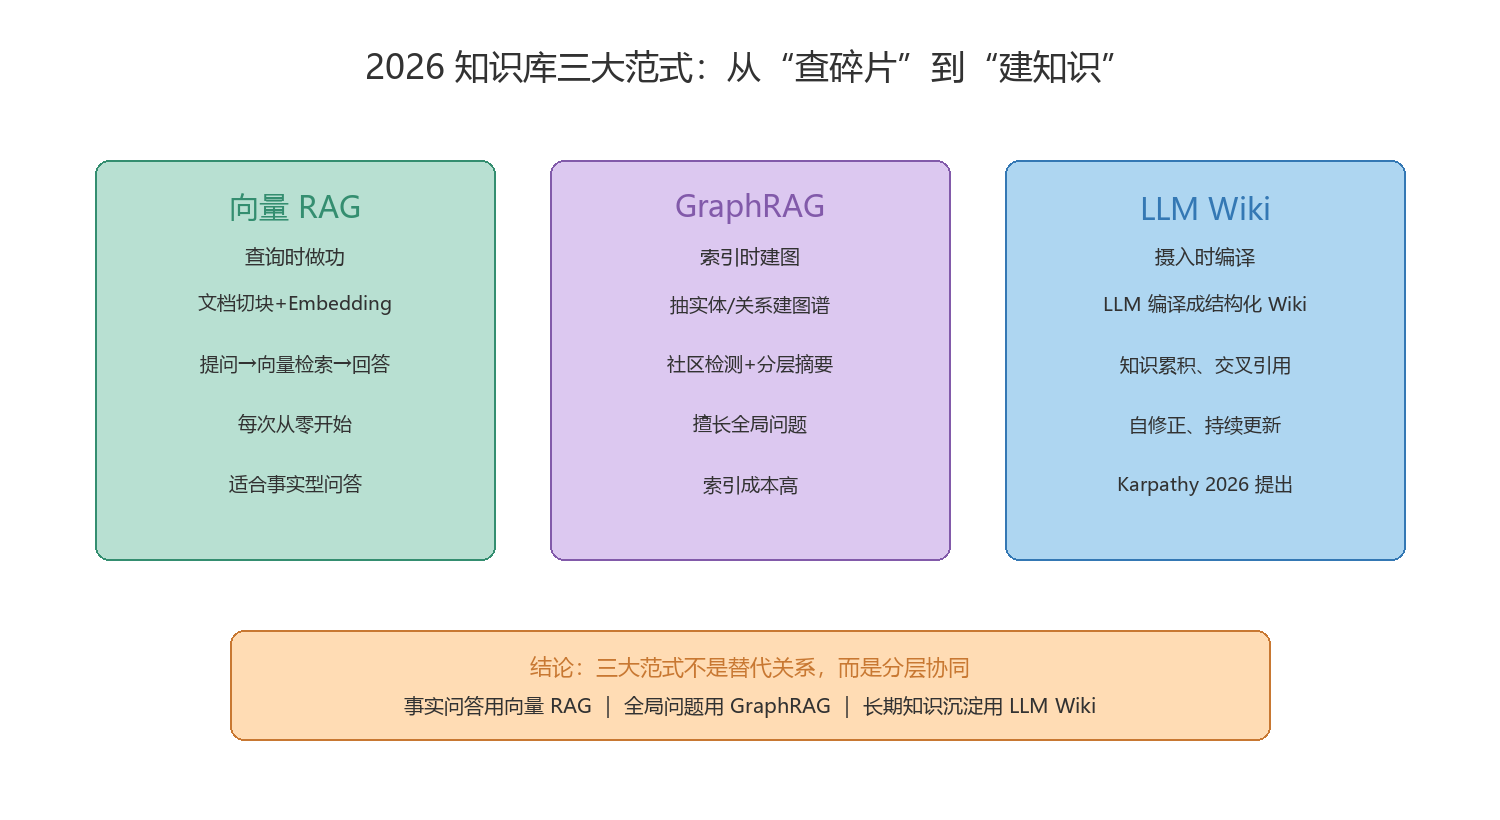
- 向量 RAG:查询时做功,擅长“事实型问答”,插入即生效,适合高频更新的小知识库。
- GraphRAG:索引时建图,擅长“全局问题、关系推理”,适合大规模复杂知识。
- LLM Wiki:摄入时编译,擅长“长期知识沉淀”,把知识变成可导航、可积累的 Wiki。
给你的建议:这篇博客里你先把向量 RAG 跑通(最容易、最通用),遇到全局问题再上 GraphRAG;如果你在做个人知识库、想让它“越用越聪明”,再研究 LLM Wiki。不要三种一起上,那样只会收获三份复杂度。
十五、三个真坑,每个都付过费
坑一:把“整个 PDF”一次喂给向量库
症状:把整个 PDF 当一块向量存进去,检索时命中率低得离谱,答非所问。
原因:一个 PDF 几十万字符,Embedding 模型只吃 512 token,被截断成了“平均语义”,什么都没表达清楚。
解:按章节切分(500~800 字符 + 重叠),别让大块进库。
坑二:盲目上 Milvus + 分布式,结果运维成本爆表
症状:个人知识库也“要上 Milvus”,结果部署、监控、扩容天天折腾,90% 的精力花在运维上,只剩 10% 做业务。
原因:Milvus 是为大规模、高并发、多租户场景设计的分布式系统。你的知识库可能就几百条文档,单机 Chroma 一秒查完,上 Milvus 纯属“拿牛刀杀鸡”。
解:开发阶段用 Chroma(零部署、Python 内置),等数据量真上来了(百万级向量、高并发)再平滑切到 Milvus。技术选型永远看场景,不是看“谁的架构更先进”。
坑三:只做了向量检索,没加 Rerank,召回一堆但答不准
症状:检索回来 Top-5 个块,看着都“相关”,但模型答出来总差点意思——明明命中了关键词,答案却拼接得不好。
原因:双编码器(Embedding 模型)的相似度是“粗筛”——它把问题和文档各自压缩成一个向量再比距离,精度天生有限。召回的 50 条里,排前面的未必是真正最相关的,模型被噪音干扰。
解:加 Rerank。用 Cross-Encoder(如 bge-reranker-v2-m3)对召回的候选逐对精排,只取 Top-5 喂模型。这是成本最低、收益最明显的优化——一句 reranker.predict() 调用,召回命中率常常直接翻倍。
十六、经验清单
- 判断 RAG 好坏的唯一标准是评估,不是感觉。 用 RAGAS 的四个指标(忠实度/相关性/精确率/召回率)建一份带标准答案的测试集,每次优化都跑一遍。
- 切分是地基,别偷懒。 默认
RecursiveCharacterTextSplitter+ 500~800 字符 + 10-20% 重叠,就够大多数场景;长文档进阶用父子切分。 - 向量库先轻后重。 小 Demo 用 Chroma,算法实验用 FAISS,已有 PG 用 pgvector,数据规模真上来了再上 Milvus。
- 混合检索 + Rerank 是生产级的底线配置。 向量 + BM25 双重召回,Cross-Encoder 二次精排,这套是 2026 标准配方。
- Agentic RAG 是下一站,但不是起点。 先把固定流水线跑通、评估、调优,再让模型接管“检索决策”;GraphRAG/LLM Wiki 是特定场景的特效药,不是保健品。
下篇预告
下一篇《大模型实战指南(9)——Agent 工程实战:让模型学会自己干活》。
前八篇我们把“怎么让模型说话、怎么让它查你的文档”讲完了。这一篇要跨一大步:让模型不是被动回答,而是主动规划、调用工具、一步步完成任务——你喊一声“帮我查一下季度报表并做成 PPT”,它自己去查、自己写、自己交。
我们将拆解 ReAct 循环、Function Calling、工具定义、多 Agent 协作,以及让 Agent 稳定的那套“护栏”(沙箱、权限、超时、重试)。文末附一套能跑通“让 Agent 查数据并出报告”的完整代码。
数据来源声明
- RAG 开山论文:Lewis et al., Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, 2020 年 5 月 arXiv。
- Gartner《企业级 AI 基础设施成熟度曲线》(2026 年 7 月):超 68% 企业传统 RAG 未能跨越生产鸿沟。
- 向量库选型参考:腾讯云开发者《别急着上 Milvus》、CSDN 向量数据库选型实战对比。
- GraphRAG:微软研究院开源项目(GitHub 31K+ Stars);索引成本为传统 RAG 5-10 倍;Leiden 社区检测、全局/局部查询。
- RAGAS:开源 RAG 评估框架,四个核心指标定义。
- Adaptive RAG:2026 年报道称准确率提升约 40%。
- Agentic Search(Mistral,2026 年 8 月):FinanceBench 正确率 26.7% → 86%,p90 延迟降 39.6%;五步循环 search/open/navigate/read/grep。
- LLM Wiki(Andrej Karpathy,2026 年 4 月提出):把 RAG 从“查询时做功”升级为“摄入时编译”,GitHub 讨论量超 1500 万次浏览。
- 长上下文 vs RAG 对比:Gemini 1M/Claude 200K/GPT-4.1 128K 窗口;四堵墙(成本/中间迷失/权限/更新)观点来自 2026 年 CSDN 多篇文章综合。
更多推荐


 9
 0
- 0


 已为社区贡献10条内容

所有评论(0)