
大模型实战指南(2)——上下文窗口:为什么聊着聊着模型就“失忆”了?
大模型实战指南(2)——上下文窗口:为什么聊着聊着模型就“失忆”了?
你和模型聊到第 20 轮,它突然忘了你第 1 轮就说过“不要用 emoji”。你怀疑模型坏了,其实它只是“桌子太小,旧文件被挤掉地上了”。这张桌子叫上下文窗口,单位是 Token。这篇讲清楚:窗口到底是什么、满了会发生什么、为什么 2026 年 1M 窗口成了标配、以及窗口大是不是真的等于记得住。
0. 前言
上一讲我们搞懂了 Token:计费按它算、上下文按它量、速度被它拖。这一讲把“上下文”三个字拆开——它是怎么运作的、瓶颈在哪、以及为什么你会产生“模型失忆”的错觉。
这一篇你会收获:
- 一个直观的心智模型:上下文窗口 = 模型的工作台
- 为什么窗口会满、满了之后模型到底干了什么
- KV Cache 是什么,为什么它决定了窗口能多大
- 从 2K 到 2M 的窗口军备竞赛是怎么回事
- 窗口大 ≠ 模型强,“大海捞针”测试暴露的真相
- 三个实战坑 + 一套可跑的代码
老规矩,先讲人话,再上技术,最后给代码。
1. 模型真的“失忆”了吗?
先还原一个你可能经历过的场景。
你用 DeepSeek 写一篇技术博客,第 1 轮你说:“帮我写一篇关于 Token 的博客,要求通俗、有代码、不要 AI 腔。”模型答得不错。第 8 轮你说“把第二段改得更口语一点”,它照做了。第 15 轮你说“顺便把标题也改一下”。第 20 轮,你突然发现它写出来的东西开始用“综上所述”“总而言之”这种 AI 腔——你在第 1 轮就叮嘱过“不要 AI 腔”。
你心想:坏了,模型失忆了。
模型没有失忆,它只是“没看见”。 你第 1 轮的指令还在对话历史里,但对话历史已经超过了模型一次能处理的 Token 上限,最早的几条被系统自动截掉了。模型睁开眼睛看到的,只有最近 N 个 Token,第 1 轮的内容根本不在它的视野里。
这就像你在一张只够摆三张纸的桌子上干活:桌子满了,你放新纸进来,就得抽掉最旧的一张。不是你没写过那张纸,是它已经被挤下桌了。
这张桌子,就是上下文窗口(Context Window)。
先记住三个数字,后面都会用到:
- 2023 年主流模型:4K-32K Token(约 3000-25000 汉字)
- 2024-2025 年:128K-1M Token(约 10 万-70 万字)
- 2026 年 8 月:1M 是旗舰标配,Gemini 3.5 Pro 直接给到 2M
窗口从 4K 涨到 1M,涨了 250 倍。可模型的“记忆”问题,并没有因此消失。
2. 上下文窗口到底是什么
2.1 不是“对话框长度”,是“一次推理的总预算”
很多人以为上下文窗口是聊天窗口能显示多少条消息——不对。
上下文窗口是模型一次推理能处理的 Token 总量,它是四份东西的总和:
上下文窗口容量 = 系统提示词 + 历史对话 + 当前输入 + 模型输出(预留)
举个例子。DeepSeek-V4 的上下文窗口是 1M Token。当你发一段话过去,模型把下面这些东西一次性全部塞进窗口:
- 系统提示词(System Prompt):产品预设的规则(可能几百 Token)
- 历史对话:你之前所有轮次的输入和输出(长对话里这是大头)
- 当前输入:你刚发的这句话
- 输出预留:模型要生成回答的空间
四份加起来不能超过 1M。很多人只盯着“输入”那一块,忘了输出也要占窗口。
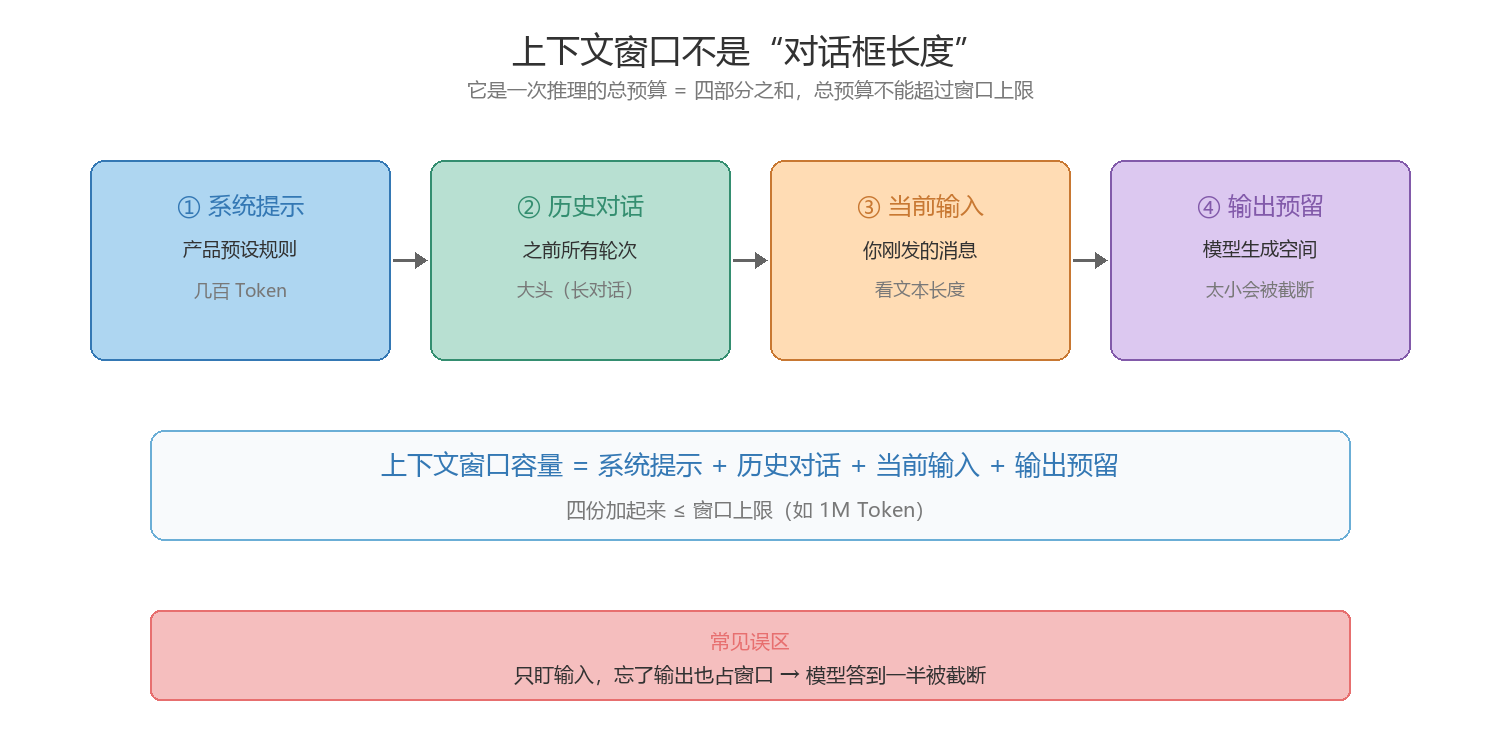
图1:上下文窗口不是“能显示多少消息”,而是系统提示、历史对话、当前输入、输出预留四部分加起来的预算。输出预留太少,模型答到一半就被截断。
2.2 工作台类比
把模型想象成一个厨师,上下文窗口是厨房的台面。
- 台面(窗口)大小固定,一次只能摊开这么多食材(Token)
- 新菜(新消息)端上来,旧食材要么叠起来(压缩/摘要),要么扔进垃圾桶(截断)
- 你随时可以点“再来一遍”(重新开始新会话),台面清零
这个类比能解释很多现象:
- 为什么长对话越聊越“笨”:台面被旧食材占满,能摊开的新食材(有效信息)越来越少
- 为什么“开新会话”能救回来:台面清空,全用来处理眼前这盘菜
- 为什么重发一遍关键信息有用:把重要食材直接放到台面最上层,确保它还在视野内
- 为什么上下文越长越贵:台面越大,备菜(KV Cache,第 4 节)占的仓库空间越大
2.3 模型没有“记忆”,只有“重读”
这是整篇最重要的一句话:大模型没有记忆,它每轮都是“重新读一遍”。
你以为它“记得”你 20 轮前说的事,实际上每轮它都把当前窗口里的内容从头“读”一遍再作答。它既不是想起了你,也不是忘了你——它只是恰好看到、或者恰好没看到。
所以“记忆”这个说法从一开始就误导人。正确的心智模型是:上下文窗口 = 模型的“临时工作记忆”,窗口外的一切对它来说等于不存在。
这也是为什么 RAG(检索增强)、Agent 工具调用这些架构会出现:因为窗口装不下全部知识,人得把最重要的内容先找出来,塞进窗口给模型看。
3. 窗口满了,会发生什么?
3.1 三种“满”的处理方式
窗口装满了,各家处理方式不同,主要三种:
方式一:硬截断(最简单也最粗暴)
最早的 API 就是这么干的:超出窗口的直接报错“context_length_exceeded”,或者静默截断最前面的内容。你的第 1 轮指令就是这么丢的。
方式二:滑动窗口(最常见)
保留最近 N 个 Token,丢掉最旧的。这正是 Claude Code、Cursor 等工具默认行为——对话太长了,旧内容自动滑出去,相当于给模型“断尾”。代价是早期信息丢失,比如你在第 1 轮设置的偏好。
方式三:自动压缩/摘要(最聪明)
把旧对话压缩成摘要再塞回去。ChatGPT 的“记忆”功能、Claude 的自动压缩(auto-compact)都类似这个思路——旧信息不是删掉,而是“压缩包”留在窗口里。代价是细节丢失(摘要永远比原文短)。
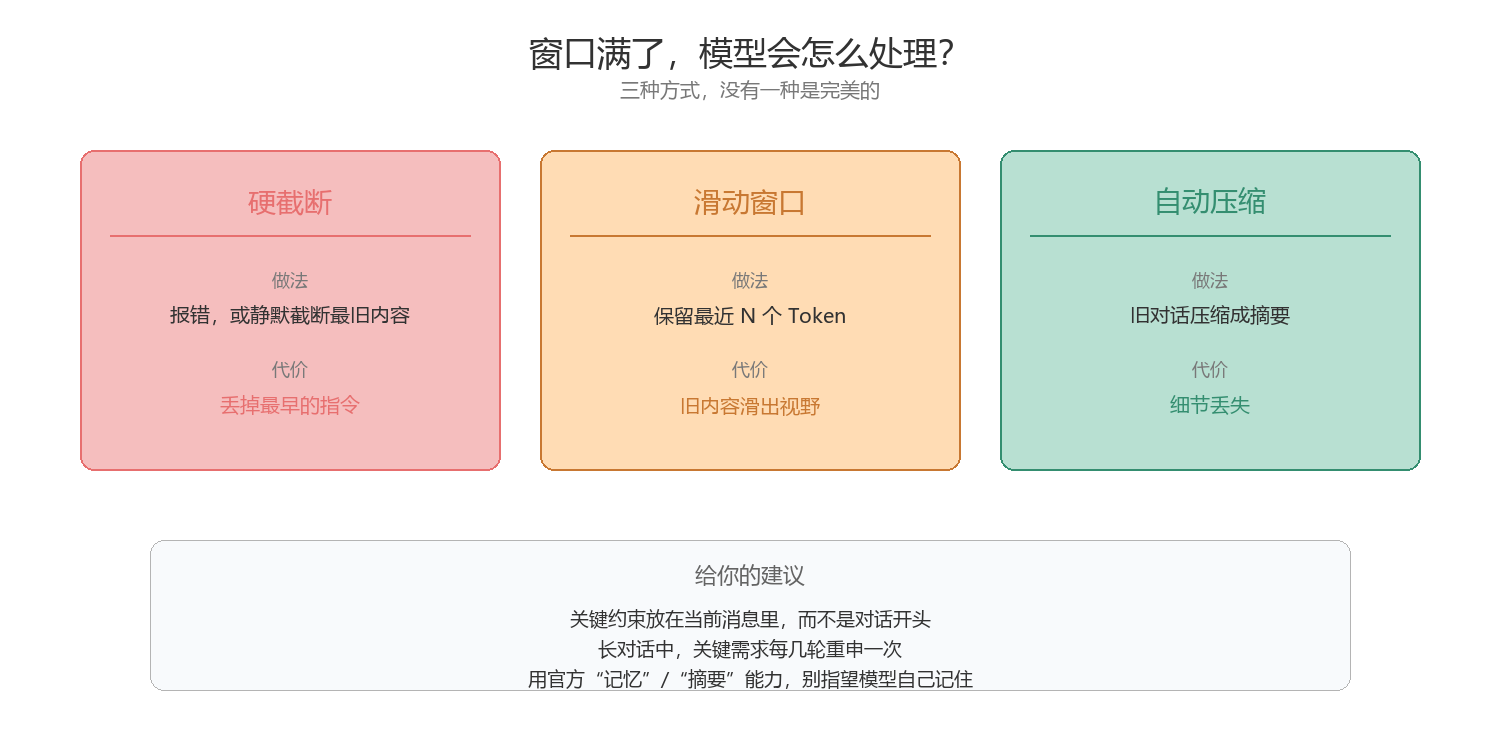
图2:窗口满了之后,要么直接截断最旧内容(丢信息),要么压缩成摘要(丢细节),要么保持硬限制报错。没有一种方式是完美的。
3.2 用代码模拟“滑动窗口”截断
def sliding_window(messages, max_tokens=4000, token_estimator=len):
    """模拟大模型的滑动窗口截断:保留最近 N 个 Token 的消息"""
    total = 0
    kept = []
    # 从最新消息往前数,直到累计 Token 数接近上限
    for msg in reversed(messages):
        tokens = token_estimator(msg)
        if total + tokens > max_tokens:
            # 窗口满了,这条只能部分保留或丢弃
            break
        kept.append(msg)
        total += tokens
    # 恢复时间顺序
    kept.reverse()
    return kept

# 模拟一个 8 轮对话
messages = [
    "我的需求是:写一篇通俗的技术博客,不要 AI 腔",   # 第1轮 关键指令
    "好的,我记住了。",
    "第一段写完了,你看看。",
    "第二段改得口语化一点",
    "第三段加个例子",
    "把标题也改了",
    "补充一段总结",
    "现在帮我把全文润色一下",                        # 第8轮 当前请求
]

# 每轮消息按 800 Token 估算,8 轮共 6400,窗口只有 4000
kept = sliding_window(messages, max_tokens=4000, token_estimator=lambda m: 800)
print("截断后保留的消息:")
for m in kept:
    print(" -", m[:20], "...")
跑完你会发现:第 1 轮的“不要出现 AI 腔”已经被滑出去了。模型看到的只有最近 5 轮,它并不知道有这个要求——这就是“失忆”的真相。
那你的指令怎么办? 三条实用建议:
- 关键约束(不要 AI 腔、风格要求、格式要求)提到窗口前排:放在当前消息里,而不是开头
- 长对话中,把关键需求每几轮重提一次
- 用官方提供的“记忆”或“摘要”能力,别指望模型自己记住
4. KV Cache:窗口为什么不能无限大
先接受一个事实:上下文窗口不是厂商“想多大就多大”的,真正的瓶颈在硬件——更准确地说,在显存。
要理解为什么,得从注意力机制讲起。
4.1 注意力:每个 Token 都要“看”一眼所有 Token
Transformer 处理文本时,每个位置的 Token 会生成三个向量:
- Q(Query,查询):这个 Token 想找什么
- K(Key,键):这个 Token 是什么
- V(Value,值):这个 Token 贡献什么信息
模型算注意力时,拿 Q 去跟之前所有 Token 的 K 做匹配,得到权重,再用权重对 V 加权求和。换句话说:生成第 1000 个 Token 时,模型要把前 999 个 Token 全部看一遍,才知道该输出什么。
如果你觉得 Q/K/V 太抽象,可以用一个图书馆的类比:
- Q 是你走进图书馆时手里的检索单:“我想找一本关于如何写技术博客的书”
- K 是每本书封面上的标签:“编程”“写作”“AI”“小说”
- V 是书的内容本身
注意力做的就是:拿你的检索单(Q)跟每本书的标签(K)比对,算出每本书的相关性分数,然后按分数把书的内容(V)加权搬走。相关性高的多拿一点,相关性低的少拿一点。这就是“加权求和”。
写成公式就是:
注意力分数 = softmax(Q·K^T / √d) · V
Q·K^T:Q 和 K 做点积,得到相关性分数/√d:除以维度开根号,防止分数过大把 softmax 推成“1 或 0”的两极分化softmax:把分数转成“加起来等于 1”的权重(哪个 Token 更重要)× V:按权重把 V 混合起来
4.1.1 用 numpy 手写一次注意力(可复制)
下面的代码不用任何深度学习框架,纯 numpy 就能跑,帮你亲眼看到“注意力到底在算什么”:
import numpy as np

def softmax(x):
    """数值稳定的 softmax"""
    e = np.exp(x - x.max(axis=-1, keepdims=True))
    return e / e.sum(axis=-1, keepdims=True)

def attention(Q, K, V):
    """最原始的注意力实现:Q·K^T/√d → softmax → ×V"""
    d = Q.shape[-1]
    scores = Q @ K.T / np.sqrt(d)   # 1) 相关性分数
    weights = softmax(scores)          # 2) 归一化成权重
    return weights @ V, weights         # 3) 加权求和 + 返回权重供观察

# 假设 4 个 Token,每个 Token 用一个 8 维向量表示
np.random.seed(42)
Q = np.random.randn(4, 8)   # 4 个查询向量
K = np.random.randn(4, 8)   # 4 个键向量
V = np.random.randn(4, 8)   # 4 个值向量

out, weights = attention(Q, K, V)
print("注意力权重矩阵(每行 = 一个 Token 对所有 Token 的关注度):")
print(np.round(weights, 3))
print()
print("第 1 个 Token 对自身的关注度:", round(weights[0][0], 3))
print("输出维度:", out.shape)
跑完你会发现:每个 Token 的输出,都是“按权重混合所有 Token 的值”的结果。这就是上下文窗口存在的根本原因——要生成下一个 Token,就得把窗口里所有 Token 的 K/V 都拿出来算一遍。
4.2 问题:如果每次重算,成本爆炸
假设对话历史有 1000 个 Token。你让模型“继续”,它要生成第 1001 个 Token——需要跟全部 1000 个历史 Token 计算注意力。
生成第 1002 个时,又要跟全部 1001 个历史 Token 算一遍。
如果不做任何缓存,每生成一个 Token 都要把全部历史的 Q、K、V 从头重新算一遍。对话越长,每步的重算成本越高——从第 1 个 Token 到第 n 个 Token 的总计算量是 O(n²) 的(n 个 Token,每个都要看前面全部)。而生成又是逐 Token 串行的,这个平方复杂度对长对话是致命的。
4.3 解法:KV Cache——把算过的 K/V 存起来
KV Cache(键值缓存)的思路特别简单:
既然前一轮已经把每个 Token 的 K、V 算出来了,那直接存进显存,下一轮直接用,不再重算。
于是生成过程变成:
- 第 1 轮:输入全部 1000 个 Token,算出它们的 K、V → 存入显存(KV Cache)
- 第 2 轮:只需算新 Token 的 Q,跟缓存里的 K 做注意力,V 加权 → 新 Token 的 K、V 继续追加进缓存
- 每轮只处理新增的 1 个 Token,而不是全部历史
KV Cache 是注意力机制+自回归生成这个组合的“必然产物”——没有它,长对话根本跑不动。你的每一个输入 Token,最终都变成显存里一组 K/V 向量,躺在 GPU 上等着被反复调用。
4.3.1 手写一个迷你 KV Cache(可复制)
光说不练假把式。下面用 numpy 手写一个“带 KV Cache 的注意力”,让你亲眼看到:加缓存之后,计算量是怎么降下来的。
import numpy as np

def softmax(x):
    e = np.exp(x - x.max(axis=-1, keepdims=True))
    return e / e.sum(axis=-1, keepdims=True)

class TinyAttentionWithCache:
    """迷你 KV Cache 演示:只处理新增 Token,复用历史 K/V"""
    def __init__(self, d_model=8):
        self.d = d_model
        self.K_cache = np.zeros((0, d_model))   # 历史 K 缓存
        self.V_cache = np.zeros((0, d_model))   # 历史 V 缓存
        self.steps = 0                          # 统计累计计算量

    def forward(self, q, k, v):
        """q/k/v 都是 (1, d) 的单个新 Token"""
        # 1) 把新 Token 的 K/V 追加进缓存
        self.K_cache = np.vstack([self.K_cache, k])
        self.V_cache = np.vstack([self.V_cache, v])
        # 2) 只用 Q 跟【缓存里所有 K】算注意力(历史 K 不用重算)
        scores = q @ self.K_cache.T / np.sqrt(self.d)
        weights = softmax(scores)
        # 3) 对缓存里的 V 加权求和
        out = weights @ self.V_cache
        self.steps += self.K_cache.shape[0]   # 这次看了多少历史 Token
        return out, self.K_cache.shape[0]

np.random.seed(7)
attn = TinyAttentionWithCache()
for t in range(1, 6):   # 模拟生成 5 个 Token
    q = np.random.randn(1, 8)
    k = np.random.randn(1, 8)
    v = np.random.randn(1, 8)
    out, seen = attn.forward(q, k, v)
    print(f"生成第 {t} 个 Token:只需与 {seen} 个历史 Token 算注意力")

print(f"\n累计计算量 = {attn.steps} 次点积")
print("如果不缓存(每次从头算),累计 =", sum(range(1, 6)), "次点积(且每次还得重算历史 K/V)")
跑完这个例子你会直观感受到:KV Cache 把“每次重算全部历史”变成了“只追加新增的”,省掉的是每一次都被重复计算的历史 K/V。 真实大模型里,这个省法直接决定了你聊天时响应有多快。
4.4 显存账本:KV Cache 占多少?
KV Cache 的显存占用有个公式:
KV Cache 大小(字节) = 2 × L × S × H × D × 精度字节数
- L = 层数(每个 Token 每层都要存一份 K/V)
- S = 序列长度(Token 数)
- H = 注意力头数
- D = 每头维度
- 乘以 2:K 和 V 各一份
- 精度字节:FP16 是 2 字节
拿一个真实的大家伙算账:Llama-4-405B(80 层、128 头、每头 128 维、FP16):
2 × 80 × 32768 × 128 × 128 × 2
= 4 × 80 × 32768 × 16384    (128 × 128 = 16384)
= 4 × 80 × 536,870,912      (32768 × 16384 = 536,870,912)
= 171,798,691,840 字节
≈ 160 GB
32K 上下文的 KV Cache 就吃掉 160GB 显存——这还没算模型本身的权重(FP16 下 405B 约 810GB)。A100(80GB)都得两台拼起来,4090(24GB)直接爆。
所以上下文窗口越大、并发请求越多,显存压力是指数级上升的。这直接解释了两个现象:
- 为什么 2023 年的模型窗口普遍只有 4K-32K:硬件扛不住
- 为什么 2026 年能到 1M:因为 KV 压缩技术(第 5 节)出现
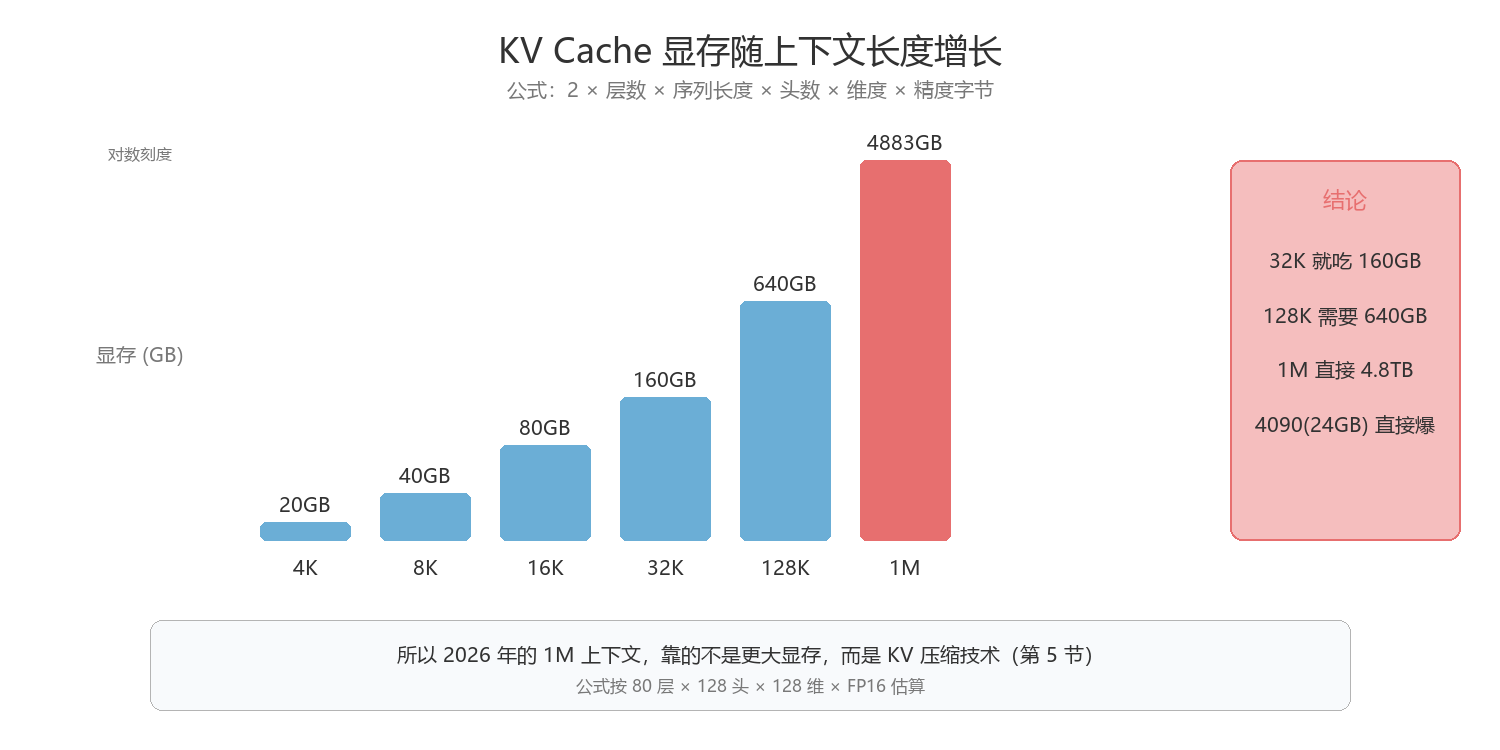
图3:上下文越长,KV Cache 占的显存线性增长;并发请求一多,显存直接爆。KV Cache 是“窗口军备竞赛”的最大物理瓶颈。
4.5 一个实用的显存估算器
def kv_cache_size_gb(layers, seq_len, heads, head_dim, dtype_bytes=2, concurrent=1):
    """估算 KV Cache 占用的显存(GB)"""
    per_request_bytes = 2 * layers * seq_len * heads * head_dim * dtype_bytes
    return per_request_bytes * concurrent / (1024**3)

# Llama-4-405B:80层, 32K 序列, 128头, 128维
print(kv_cache_size_gb(80, 32768, 128, 128))           # 单请求
print(kv_cache_size_gb(80, 32768, 128, 128, concurrent=4))  # 4 并发
print(kv_cache_size_gb(80, 1000000, 128, 128))       # 1M 序列(理论)

# 输出:
# 160.0 (单请求 32K)
# 640.0 (4 并发)
# 4882.8 (1M 序列,直接爆显存)
这段代码就是给“我的显卡能跑多长上下文”算账的。跑完你就理解,为什么 1M 上下文在 2026 年前只是传说。
4.6 显存三巨头:不只是 KV Cache
很多人以为显存只被模型权重占着,其实推理时显存被三样东西瓜分:
| 占用项 | 是什么 | 特点 | 7B 模型估算 |
|---|---|---|---|
| 模型权重 | 网络参数本身 | 静态,加载后固定 | FP16 约 14GB |
| KV Cache | 每层缓存的 K/V | 动态,随上下文线性涨 | 32K 上下文约 16GB(32头) |
| 激活值(activation) | 前向计算的中间结果 | 动态,随 batch 和长度涨 | 几个 GB 起 |
为什么本地显卡经常 OOM? 就是这三个一起爆。很多人只看权重:7B 模型 FP16 是 14GB,24GB 的 4090 应该够吧?结果一跑长上下文,KV Cache 再吃 16GB,激活值再吃几 GB——直接 OOM。
这就是为什么 2026 年跑本地模型,大家都要开量化(FP8/INT4):KV Cache 从 FP16 压到 INT4,直接省 75% 显存。但代价是精度损失,见第 5 节。
5. 窗口军备竞赛:从 2K 到 2M 的进化史
了解了 KV Cache 的瓶颈,就能看懂下面这条时间线:
| 年份 | 模型 | 上下文窗口 | 备注 |
|---|---|---|---|
| 2020 | GPT-3 | 2K (2048) | 起步期,窗口小得可怜 |
| 2023-03 | GPT-4 | 8K / 32K | 32K 是当时的天花板 |
| 2023-12 | Claude 2.1 | 200K | Anthropic 刷新纪录 |
| 2024-02 | Gemini 1.5 Pro | 1M (实测 2M) | Google 首次把窗口推到百万 |
| 2024-2025 | 各家旗舰 | 128K 成标配 | 窗口军备竞赛中场 |
| 2026-04 | GPT-5.5 | 1M | OpenAI 追上第一梯队 |
| 2026-05 | Claude Opus 4.8 | 1M (Foundry 200K) | 输出上限 128K |
| 2026-07 | Gemini 3.5 Pro | 2M | 窗口第一,价格不便宜 |
| 2026-08 | DeepSeek-V4-Pro | 1M | 国产 1M + 输出 384K |
| 2026-08 | Qwen3.8-27B | 262K(原生)/1M(YaRN外推) | 混合线性注意力 |
三个事实值得注意:
- 窗口翻倍的速度远超摩尔定律:6 年从 2K 到 2M,涨了 1000 倍。同期 GPU 显存只涨了十几倍。所以窗口增长不能靠“堆硬件”,必须靠“省内存”。
- 真正让 1M 落地的,是压缩技术,不是显存:详见下面三行。
- 国产模型在长上下文上追得非常快:DeepSeek-V4 直接把 1M 做成标配,Qwen 的 27B 小模型也能 1M,这是 2026 年的独特现象。
5.1 让 1M 变成现实的三大技术
1) FlashMLA(DeepSeek 的 KV 压缩)
DeepSeek-V4 用 MLA(Multi-head Latent Attention)把 KV 缓存大幅压缩。官方数据:1M 上下文的 KV Cache 从传统方案的 83.9GB 压到 9.6GB,单 token 的 FLOPs 只有上一代的 27%。这是 1M 能落地的核心原因。
2) 混合线性注意力(Qwen3.8-27B 等)
Qwen3.8-27B 用 Gated DeltaNet + Gated Attention 混合架构(64 层中 48 层线性注意力),把注意力复杂度从 O(n²) 砍到 O(n)。长序列推理不再被平方复杂度拖死。这意味着 1M 上下文不再需要一台服务器。
3) Flash Attention / PagedAttention(工程优化)
Flash Attention 让注意力计算不占额外显存;PagedAttention 借鉴操作系统内存分页,把 KV Cache 碎片化分配。vLLM 就是靠它把推理吞吐提上去的。
一句话总结:2026 年的 1M 上下文,是“省内存算法”(MLA/线性注意力)和“工程优化”(Flash/Paged)联合推上去的。 显卡没变大,软件变聪明了。
5.2 KV 瘦身四路线:MHA / GQA / MQA / MLA
上面提到的 MLA 不是凭空冒出来的,它是“怎么给 KV Cache 瘦身”这条路上最极端的一站。让我们从最原始的方案看起。
标准多头注意力(MHA,Multi-Head Attention)
GPT-4、Llama 2 等早期模型用的就是 MHA:每个注意力头都有一套独立的 K/V。
- KV Cache 大小 ∝
头数 × 每头维度 - 表达能力最强,但 KV 缓存也最臃肿
- Llama-4-405B 那种 128 头,KV 缓存直接爆表
多查询注意力(MQA,Multi-Query Attention)
谷歌 PaLM 等模型想省内存:让所有头共享一份 K/V。
- KV Cache 缩小到 MHA 的
1/头数 - 但表达能力下降明显——所有头共用同一份“记忆”,注意力“多样性”没了
分组查询注意力(GQA,Grouped-Query Attention)
这是目前开源模型的“折中方案”(Llama 3、Mistral 都是 GQA):把 32 个头分成 4 组,每组共享一份 KV。
- KV Cache 缩小到 MHA 的
组数/头数(如 4/32 = 1/8) - 表达能力损失比 MQA 小,省内存效果也不错
- 这是 2024-2025 年事实上的行业标准
多头潜在注意力(MLA,Multi-head Latent Attention)
DeepSeek 的创新:不砍头数,而是把 KV 压缩进一个低维“潜在向量”,用的时候再解压。
- KV Cache 缩小到 MHA 的约
1/15(体积减少 93.3%) - 表达能力和 MHA 几乎一样(因为解压能恢复大部分信息)
- 代价:训练时引入额外参数,推理时要多做一次解压计算
一句话记住四者的关系:MHA 是“全都要”,MQA 是“全共享”,GQA 是“分组共享”,MLA 是“压缩存储、用时解压”。
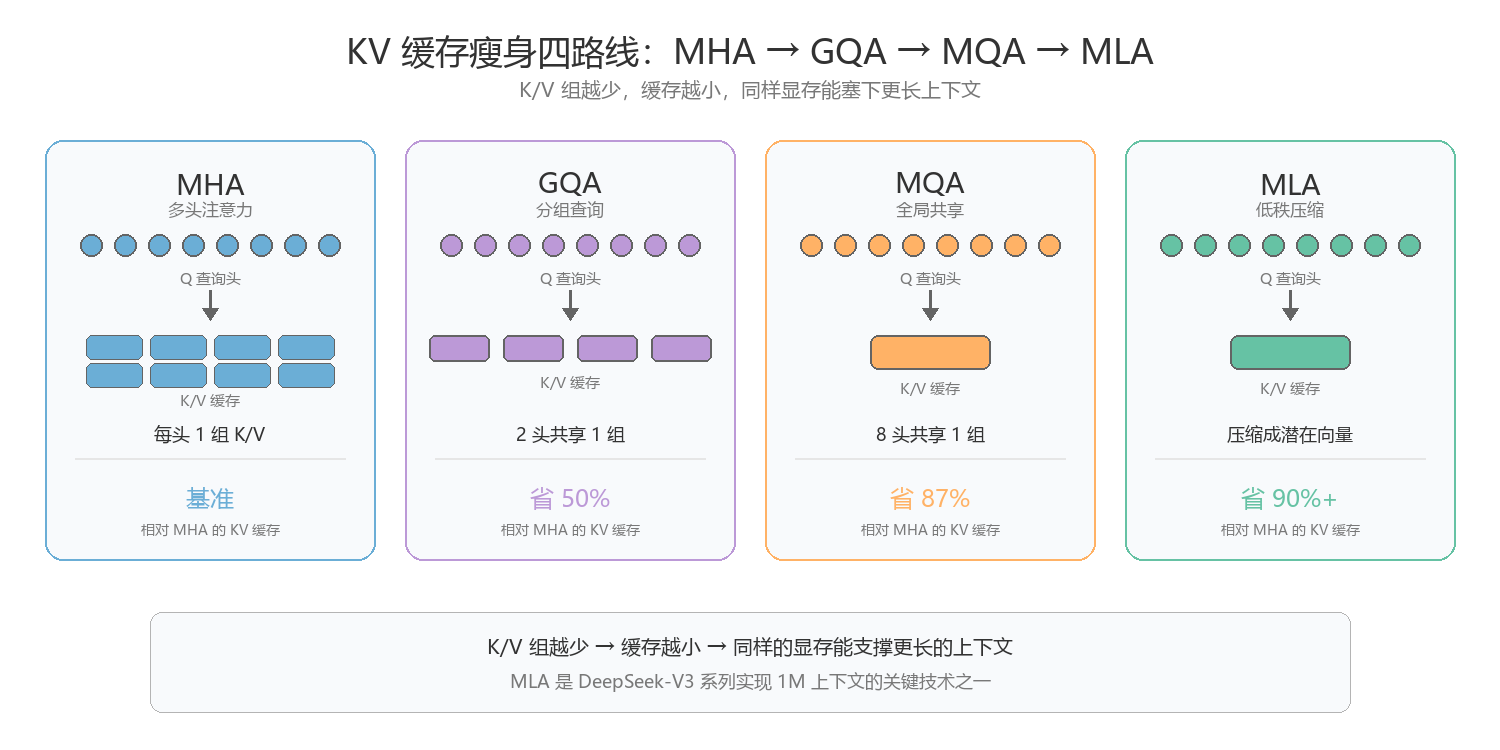
图4:从左到右,KV 缓存体积越来越小。MHA 每头独立,MQA 全头共享,GQA 分组共享,MLA 压缩成潜在向量。KV 越小,同样显存能塞下的上下文越长。
MLA 是怎么“压缩”的?
MLA 的核心思想是低秩近似:KV 矩阵其实有大量冗余,不需要把每个头完整的 K/V 都存下来。
标准做法:
c_t^KV = W_DKV · h_t      # 把隐藏状态压进低维空间(降维)
k_t = W_UK · c_t^KV      # 用的时候解压回 Key
v_t = W_UV · c_t^KV      # 用的时候解压回 Value
W_DKV:下投影(把大向量压成小向量,比如 128 维 → 16 维)W_UK/W_UV:上投影(解压回多头维度)- 推理时只存压缩后的
c_t^KV,不存完整 K/V
用人话讲:就像你把一本书的全文压缩成一个“摘要向量”存着,用的时候才展开成需要的细节。 完整信息其实可以靠投影恢复大部分,所以性能损失很小。
这是 DeepSeek-V2 起就有的技术,V3 继续用,V4 进一步升级(共享 KV + 稀疏注意力)。MLA 让 DeepSeek 在同样硬件下能塞进更长的上下文,是它“便宜又能打”的底层原因之一。
两种工程实现:Naive 与 Absorb
MLA 在实际部署时有两条路:
| 模式 | 原理 | 特点 | 适用场景 |
|---|---|---|---|
| Naive | 先解压 KV 到完整维度,再做标准注意力 | 实现简单,兼容 FlashAttention | 快速部署 |
| Absorb | 把解压矩阵“吸收”进 Q/O 投影,KV 全程保持压缩 | 性能极致,需定制 Kernel | 生产环境(FlashMLA) |
Absorb 的数学本质是利用矩阵乘法的结合律,把 W_UK 提前乘进 Q 投影里,这样 KV Cache 从头到尾都不用解压回高维。DeepSeek 开源的 FlashMLA 用的就是这条路。
KV 瘦身的另一条路:量化
除了改架构,还有一个纯工程的手段:降低 KV Cache 的精度。
- FP16(2 字节)→ FP8(1 字节)→ INT4(0.5 字节)
- KV Cache 显存直接省 50% / 75%
- 代价:精度损失,某些场景(如长文中的数字、代码)表现下降
- 手机端部署(如 iPhone 上的模型)基本都靠 INT4/FP8 量化 + KV Cache 量化才能跑
结论:2026 年的 1M 上下文,是“省内存算法”(MLA/线性注意力)、“省精度”(FP8/INT4 量化)和“省碎片”(FlashAttention/PagedAttention)三管齐下的结果。 显卡没变大,软件变聪明了。
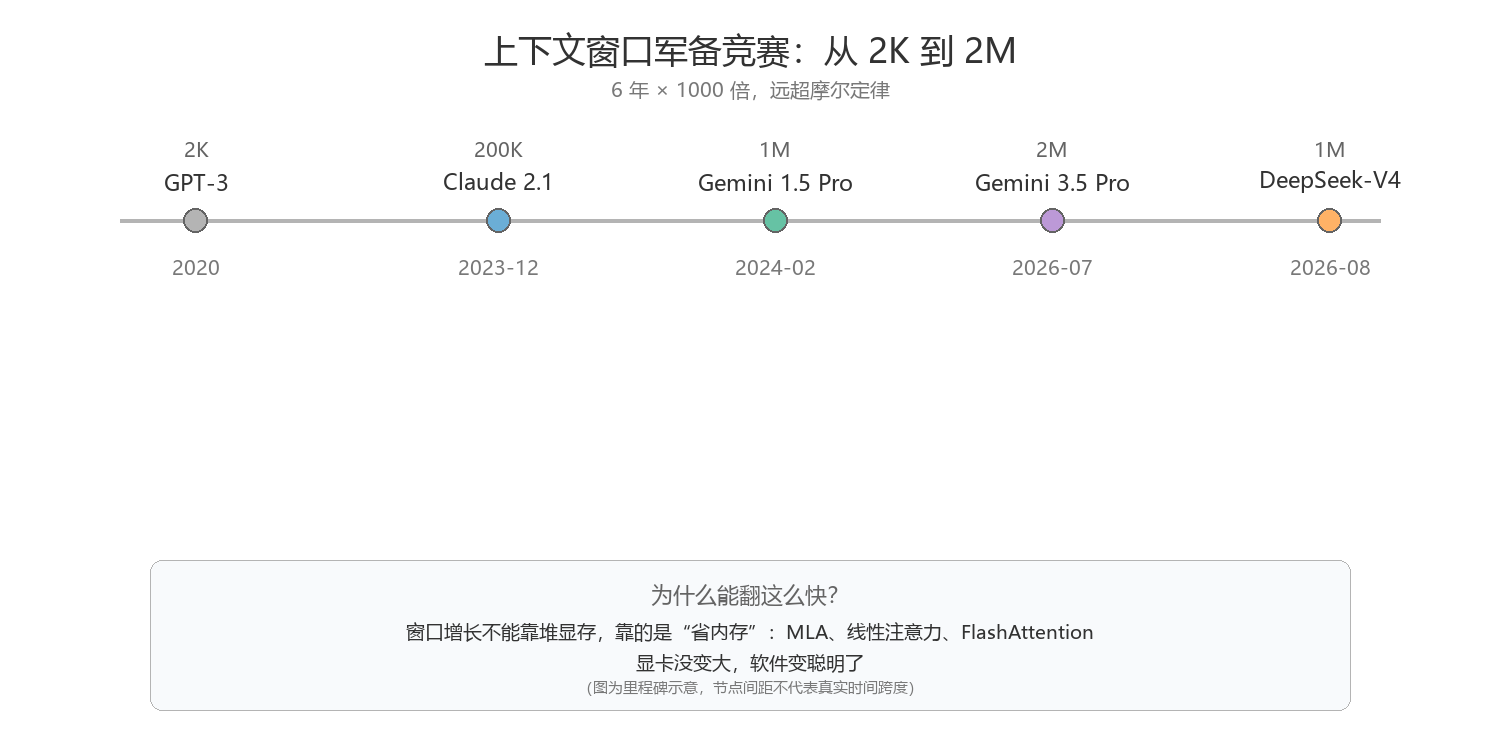
图5:6 年时间,上下文窗口从 GPT-3 的 2K 涨到 Gemini 3.5 Pro 的 2M,涨了 1000 倍。图中每个节点都是当时的天花板,背后都是 KV 压缩技术的突破。
6. 窗口大 ≠ 记得住:“大海捞针”与“迷失在中间”
窗口做到 1M、2M,就真的等于“过目不忘”吗?
6.1 大海捞针(Needle-in-a-Haystack,NIAH)
结果不乐观。模型在 4K-64K 的表现还可以,但到 128K 以上,埋在中部的“针”经常找不回来。窗口标称 128K,但实际有效容量可能只有 32K-64K。
6.2 迷失在中间(Lost in the Middle)
2023 年的一项经典研究(Liu et al.)也发现类似现象:长上下文中,模型对开头和结尾的信息记忆最好,对“中间的”最差。
原因是注意力分布:开头(首次出现)+ 结尾(最近出现)天然被模型更关注,中间的 Token 被“淹没”在长文本里。
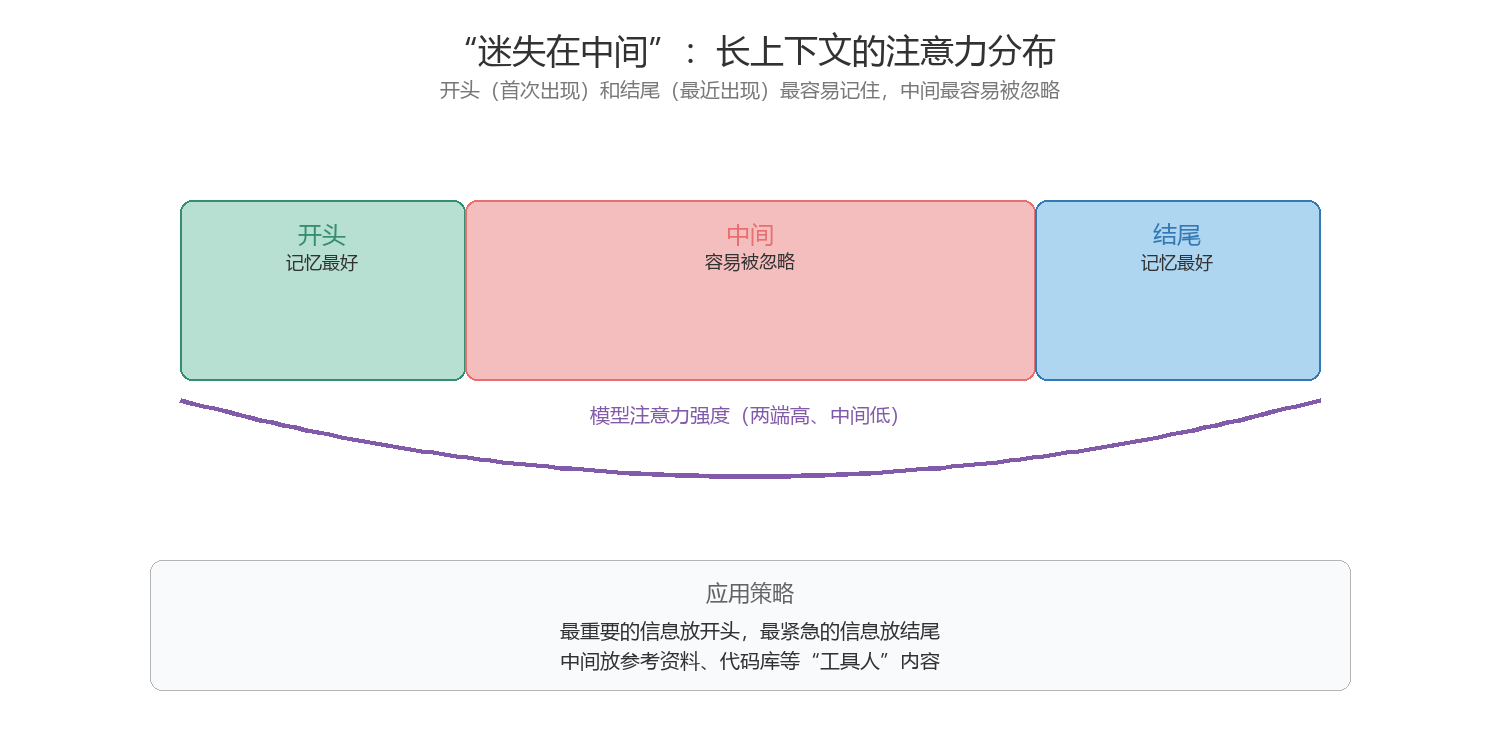
图6:在长上下文中,模型对开头和结尾的信息响应最好,对中间的信息容易“看不见”。这就是“窗口够大但记不住”的元凶。
6.3 长上下文的“五个真相”
- 窗口大 ≠ 记性好:有效上下文经常远小于标称值
- 中间信息最容易被忽略:关键指令放开头或结尾最保险
- 窗口越大,越贵、越慢:每轮输入都要扫描全部 Token
- “塞满窗口”不是好习惯:塞得越多,噪音越多,找重点越难
- 上下文压缩不是无损的:摘要会丢细节,这是物理限制
所以应用设计要记住:把最重要的信息放开头,把最紧急的信息放结尾,中间放“工具人”内容(如参考资料、代码库)。这是 2026 年长上下文应用的主流策略。
6.4 为什么“记不住”?两个技术原因
前面说了现象,这里讲透为什么窗口大了反而记不住。两个根因:
原因一:注意力被“稀释”了
还记得 4.1 的 softmax 吗?模型给每个历史 Token 分配一个注意力权重,所有权重加起来等于 1。
- 窗口 4K 时:每个 Token 能分到
1/4000的注意力预算 - 窗口 1M 时:每个 Token 只能分到
1/1000000
Token 越多,单个 Token 能分到的注意力越少——就像 100 个人分一块蛋糕和 1 万人分一块蛋糕,每个人能分到的量天差地别。埋在 1M 长文中间的一个关键信息,可能只拿到 0.000001 的注意力权重,等于没看见。
这就是为什么 NIAH 测试里,针埋得越深(越靠中间)、干草堆越厚(上下文越长),找回率越低。窗口越大,“记不住”的物理问题越严重。
原因二:相对位置信息丢失
Transformer 用的是位置编码,模型靠它知道“这句话在第几个 Token 位置”。但当上下文长到几万甚至上百万 Token,位置编码会逐渐“饱和”——太远的 Token 之间的相对位置关系变得模糊。
打个比方:你站在一栋楼前,能轻松分清 1 楼和 2 楼;但如果你退到 10 公里外,1 楼和 2 楼看起来完全一样。上下文越长,模型对\“谁先谁后、离得多近\”的感知越模糊。 这也是为什么长上下文里,中间信息经常\“串味\”或\“张冠李戴\”。
所以长上下文应用的正确姿势不是\“塞满\”,而是\“精选\”:
- 只放必要信息:无关内容越多,有效信息的注意力越稀
- 重要信息放两头:开头和结尾的注意力天然最高
- 把长文档拆成小块:分多次处理,避免一次塞太多
- 用 RAG 先检索再回答:先把最相关的几段捞出来,而不是整本塞进去
- 不要靠\“再发一遍\”:重复内容同样稀释注意力,重发未必更有效
7. 动手实验:测一测你的模型“有效窗口”
7.1 用 tiktoken 数一下你对话的 Token 占用
import tiktoken

enc = tiktoken.get_encoding("cl100k_base")

# 你的一整段对话
dialogue = """
用户:帮我写一篇技术博客
助手:好的,写什么主题?
用户:关于上下文窗口的
助手:好的,我写了一版初稿
用户:再加个 KV Cache 的章节
...
"""

tokens = enc.encode(dialogue)
print(f"这段对话占 {len(tokens)} Token")
print(f"占上下文窗口比例: {len(tokens)/128000*100:.1f}%")  # 假设 128K 窗口
7.2 迷你“大海捞针”测试(可复制)
import tiktoken

def needle_test(needle, haystack_tokens):
    """构造迷你 NIAH 测试 prompt:把一句话埋在长文中段,看模型能否找回"""
    enc = tiktoken.get_encoding("cl100k_base")
    filler = "这个段落没有任何实际意义,只是用来填充上下文长度。"
    fillers, total = [], 0
    while total < haystack_tokens:
        fillers.append(filler)
        total += len(enc.encode(filler))
    mid = len(fillers) // 2
    haystack = "\n".join(fillers[:mid] + [needle] + fillers[mid:])
    return f"在下面这段文本里,找出包含'秘密句子'的那句话:\n{haystack}\n\n请问:'秘密句子'是什么?"

needle = "秘密句子:The secret is to always split the bill."
prompt = needle_test(needle, haystack_tokens=32000)
print(f"测试 prompt 共 {len(prompt)} 字符")
# 把这段 prompt 发给任意模型 API,看它能否说出"秘密句子"的内容
代码写好了,剩下的就是:把这段 prompt 发给你的模型,看它能不能说出“秘密句子”的内容。 把 haystack_tokens 分别改成 16000、32000、64000、128000 跑四次,你就知道你的模型“有效窗口”是多少了。
7.3 KV Cache 显存预算表
用第 4 节的公式,直接算不同场景:
| 模型/场景 | 层数 | 头数×维度 | 序列长度 | 显存估算 |
|---|---|---|---|---|
| 7B 小模型 4K | 32 | 32×128 | 4096 | 约 2GB |
| 7B 小模型 32K | 32 | 32×128 | 32768 | 约 16GB |
| 70B 模型 32K | 80 | 64×128 | 32768 | 约 80GB |
| 405B 模型 32K | 80 | 128×128 | 32768 | 约 160GB |
| 405B 模型 128K | 80 | 128×128 | 131072 | 约 640GB |
结论:就算你有 4090 的 24GB,装下 70B 的权重已经够呛,再叠加 KV 显存基本没戏。 这也解释了为什么本地跑大模型,长上下文几乎都是“纸面参数”。
8. 三个真坑,每个都付过费
坑 1:把“上下文窗口”当“对话框长度”
有次我把一个 200 页的 PDF 发给模型(大约 50 万 Token),心想 1M 窗口够用了吧?结果模型告诉我:“内容太长,我处理不了。”——它把系统提示 + 我的历史 + PDF + 输出预留一算,窗口快满了,模型直接拒绝。
教训:上下文窗口是四部分总和,不是单看输入。发长文档前,先数一下 Token 总量,给输出预留 10-20% 的余量。
坑 2:max_tokens 填错,输出被拦腰截断
有个同事用 API 写长报告,设 max_tokens=200 心想“输出短点省钱”。结果模型答到一半就断了,他以为是模型 bug,其实是他把“输出预留”设成了 200 Token——一个报告怎么也得几千 Token。
教训:max_tokens 是你给输出的“预算”,不是“上限”。如果你要写 2000 字,预算至少 1500 Token;要写长文,要么分多次生成(第一篇提过“接力写作”),要么设大 max_tokens。
坑 3:1M 窗口 = 天价账单
2026 年 DeepSeek-V4 给了 1M 窗口,我以为可以随便塞长文。结果有一天我喂了一份 50 万 Token 的法律文书,一算钱——按 V4-Pro 高峰档输入 9 元/百万 Token 算,光输入就 4.5 元;而且每多一轮对话,同样的输入重新计费(除非走缓存)。长上下文 = 每轮都贵,多轮更贵。
解法:长文档一次性分析(而不是多轮追问)、把长文档拆块、用“摘要压缩”减少重复输入。API 的“上下文缓存”就是为这个场景设计的——V4-Pro 高峰档缓存命中输入 0.3 元 vs 未命中 9 元,命中率越高,成本降得越狠(理想情况接近 30 倍)。
坑 4:并发请求一起爆显存
你以为 KV Cache 只算自己一个人?服务端是很多人共享同一块显存的。 假设你有 4 个并发请求,每个都在处理 32K 上下文——KV Cache 总量直接 ×4(参考 4.5 的代码,4 并发 = 640GB)。这就是为什么 API 服务经常“高峰时段排队变慢”——显存被打满了。
教训:调用 API 时,不要开太多并发;长上下文请求尽量串行。本地部署也一样,一次只跑一个长上下文任务。
坑 5:以为“上下文缓存”会自动生效
DeepSeek 等 API 的“上下文缓存”确实能省钱(命中 0.3 vs 未命中 9 元),但它不是自动的:必须命中“完全相同的前缀”才有效。你只要在对话中间插一句“顺便把第三段改一下”,缓存就断了,整段重新计费。
教训:长上下文对话,修改放在最后,不要在中间插入。或者干脆一次性把需求讲完,减少多次追问。
9. 经验清单:带走这 5 条
-
上下文窗口 = 模型的一次性工作台:不是“能存多少消息”,是“系统提示 + 历史 + 输入 + 输出”的总预算。模型没有记忆,只有每次重读窗口。
-
“失忆”的真相是滑动截断:窗口满了,最早的指令被滑出去。关键约束放到窗口前排,或者每几轮重申一次。
-
KV Cache 是窗口的物理瓶颈:显存公式 2×L×S×H×D×精度。1M 上下文 + 大模型,KV 显存轻松几百 GB。2026 年的 1M 是 MLA/线性注意力等压缩技术推上去的,不是堆显卡。
-
窗口大 ≠ 记得住:大海捞针测试显示,有效上下文经常远小于标称;“迷失在中间”让开头结尾的信息最好记。重要信息放开头,紧急信息放结尾。
-
长上下文要算账:输入长文档每轮都按全文计费,多轮对话成本爆炸。用摘要、缓存、一次性分析,别把长文档一遍又一遍地发给模型。
本文所有数据基于 2026 年 8 月公开信息整理。模型规格、上下文窗口、价格数据来自官方文档/发布公告:OpenAI、Anthropic、Google、DeepSeek(api-docs.deepseek.com 价格页与发布公告)、Qwen 官方 GitHub 与 Hugging Face 模型卡(Qwen3.8-27B)。KV Cache 公式、MHA/GQA/MQA/MLA 原理、FlashMLA 数据来自 DeepSeek 技术报告(arxiv.org/abs/2405.04434,DeepSeek-V2)、Gated DeltaNet 论文(arxiv.org/abs/2412.06464,ICLR 2025)及社区验证。Llama-4-405B 规格来自 Meta 官方。价格(高峰档缓存命中 0.3 元 / 未命中 9 元 / 输出 27 元,每百万 Token)为 DeepSeek 官方 2026-08-17 起实行峰谷定价公告,具体以官网最新为准。
下篇预告
下一篇:《大模型实战指南(3)——温度与采样:为什么同一个问题,模型每次答得不一样?》
同样是问“1+1 等于几”,为什么有时答“2”,有时给你推荐 C 语言实现?温度参数 0 和 1 到底差在哪?采样策略里的 Top-K、Top-P 是什么意思?下一讲我们揭开大模型“创造性”的秘密,还能让你用代码控制模型的“疯狂程度”。
系列:大模型实战指南,篇篇连载,从 Token 到 Agent,带你从零搞懂大模型。关注不迷路。下篇:温度与采样。
更多推荐


 6
 0
- 0


 已为社区贡献10条内容

所有评论(0)