
大模型实战指南(3)——温度与采样:为什么同一个问题,模型每次答得不一样?
大模型实战指南(3)——温度与采样:为什么同一个问题,模型每次答得不一样?
上一篇讲完上下文窗口,你已经知道:模型每次收到你的消息,是在一个“工作台”上处理所有 Token。但有个问题一直没回答——同一个 Prompt,为什么模型有时答“2”,有时给你推荐 C 语言实现?
你以为是 Bug,其实是 Feature。答案藏在模型生成文本的最后一步:采样。
这一讲把“温度”“Top-P”“Top-K”这些你天天调、但从没真正搞懂的参数拆到底。先讲人话,再上数学,最后给可运行代码。读完你会知道:
- 模型输出一个 Token 前,内部到底发生了什么
- 温度参数怎样改变概率分布的“形状”
- Top-K 和 Top-P 到底在过滤什么,哪个更该用
- 2024 年横空出世的 Min-P 凭什么比前两者更简单更好用
- 为什么 Agent 和 RAG 项目清一色 temperature=0
- DeepSeek-V3 的“动态温度”是什么新玩法
老规矩:先讲人话,再上技术,最后给代码。
0. 前情提要
在讲采样之前,得先搞清楚一件事:大模型不是一个“问答机器”,它是一个“概率预测器”。
你在第 1 篇学了 Token,第 2 篇学了上下文窗口。今天补上最后一块拼图:模型怎么从一堆候选 Token 里,挑出下一个要输出的?
这个过程叫解码(Decoding),也叫采样(Sampling)。它是模型从“概率”到“文字”的桥梁。理解了它,你就理解了模型“创造性”的全部秘密。
1. 从概率到选择:模型输出的最后一步
1.1 模型不是“想好了”才说,是“算概率”再说
先纠正一个最常见的误区:很多人以为模型是先“想好”了一句话,再逐字输出。不是的。
模型每次只算一件事:给定前面所有 Token,下一个 Token 是词表中每个词的概率分别是多少。
比如你问“1+1 等于”,模型内部会算出一个覆盖整个词表(几万个 Token)的概率分布:
| Token | 概率 |
|---|---|
| “2” | 0.88 |
| “几” | 0.06 |
| “1” | 0.04 |
| “多” | 0.02 |
| “二” | 0.01 |
| ……(剩下几万个) | 各自很小 |
模型不知道“正确答案是 2”,它只知道“在它见过的所有训练数据里,1+1 等于后面最常出现的是 2”。
那最终输出哪个? 这就是采样策略要决定的事。
1.2 Logits:概率的“原材料”
模型最后一层输出的不是概率,而是** logits**——一组没归一化的分数(可以是任意实数,正的负的都行)。
比如词表有 5 个词,模型可能输出 logits = [3.2, 0.5, 0.0, -0.6, -1.2]。
要把它变成概率,得过一个函数:Softmax。
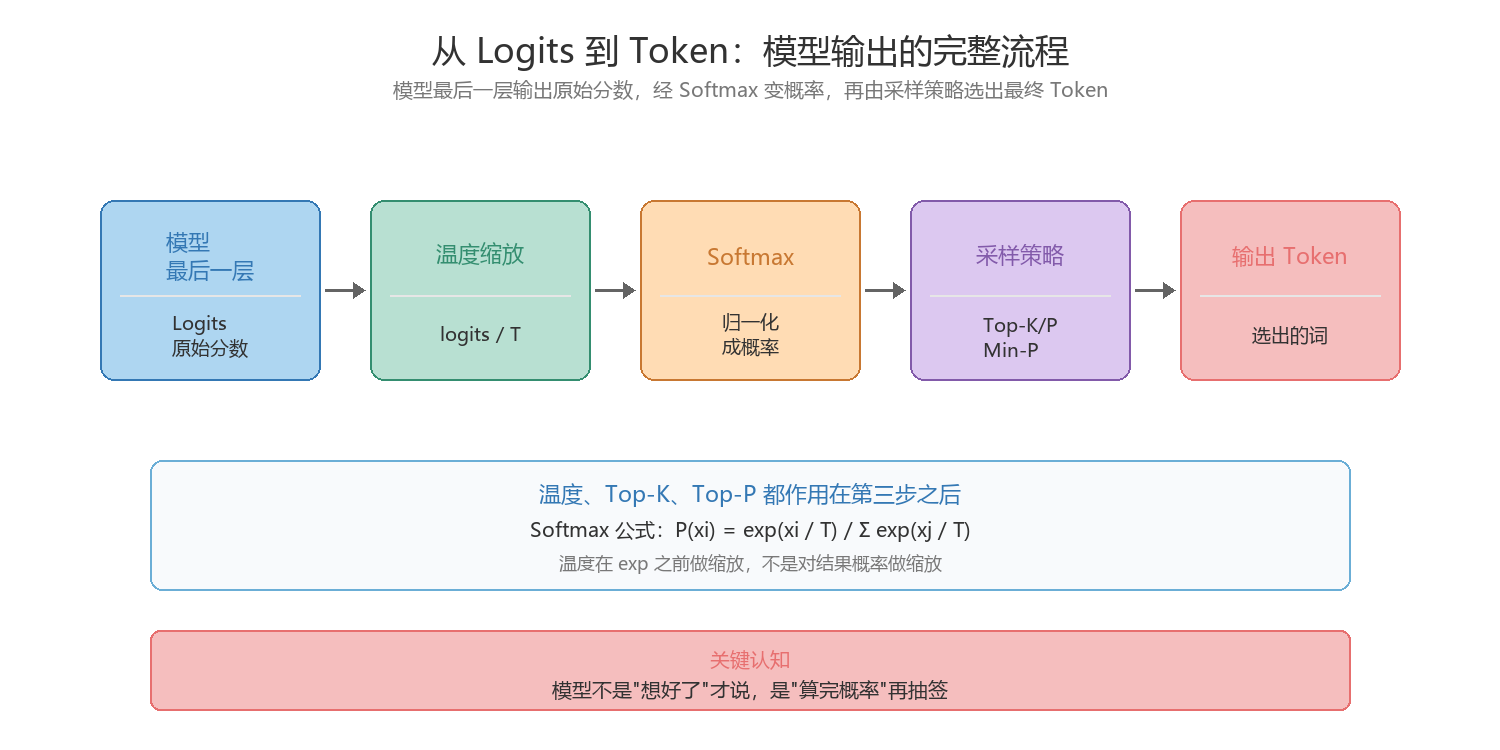
图1:模型最后一层输出 Logits(原始分数),经 Softmax 归一化成概率分布,再由采样策略选出最终 Token。温度、Top-K、Top-P 全部作用在“采什么”这一步。
1.3 Softmax:把分数变成概率
Softmax 的公式:
P(xi) = exp(xi) / Σ exp(xj)
意思是:每个 Token 的分数取指数(e 的幂),然后除以所有 Token 指数之和,让所有概率加起来等于 1。
用上面的 logits 举例:
import numpy as np

logits = np.array([3.2, 0.5, 0.0, -0.6, -1.2])

# Softmax
exp_x = np.exp(logits - logits.max())  # 减最大值防溢出
probs = exp_x / exp_x.sum()

print(np.round(probs, 4))
# [0.8752 0.0588 0.0357 0.0196 0.0107]
你看,“2”这个 Token(logits=3.2)的概率达到 87.5%,其他都不到 10%。
这就是模型生成文本的核心逻辑:算 logits → Softmax 变概率 → 从概率分布里“抽签”。
问题是:这个“抽签”怎么抽?直接按概率随机抽?还是只抽概率最高的?还是设个门槛只抽高概率的?
这就是温度、Top-K、Top-P 要解决的问题。
2. 温度(Temperature):概率分布的“音量旋钮”
2.1 温度到底在调什么
温度(temperature,通常缩写 T)是采样最基础的参数。它的作用用一句话说清楚:温度改变概率分布的“尖锐程度”。
数学上,温度是插在 Softmax 前面的一步除法:
P(xi) = exp(xi / T) / Σ exp(xj / T)
注意,不是对 Softmax 的输出做缩放,而是在取指数之前,先把 logits 除以 T。这个区别很重要,直接影响温度的效果。
- T = 1:不缩放,用原始 logits 算概率,模型“本色出演”
- T < 1(如 0.3):logits 被缩小,差距被放大,高概率的 Token 概率更高,低概率的更没机会 → 输出更保守、更确定
- T > 1(如 1.5):logits 被缩小,差距被压缩,所有 Token 概率趋于均匀 → 输出更多样、更“狂野”
- T = 0:理论上等同于选概率最高的 Token(贪心解码),但工程实现上通常用很小的值(如 0.01)近似
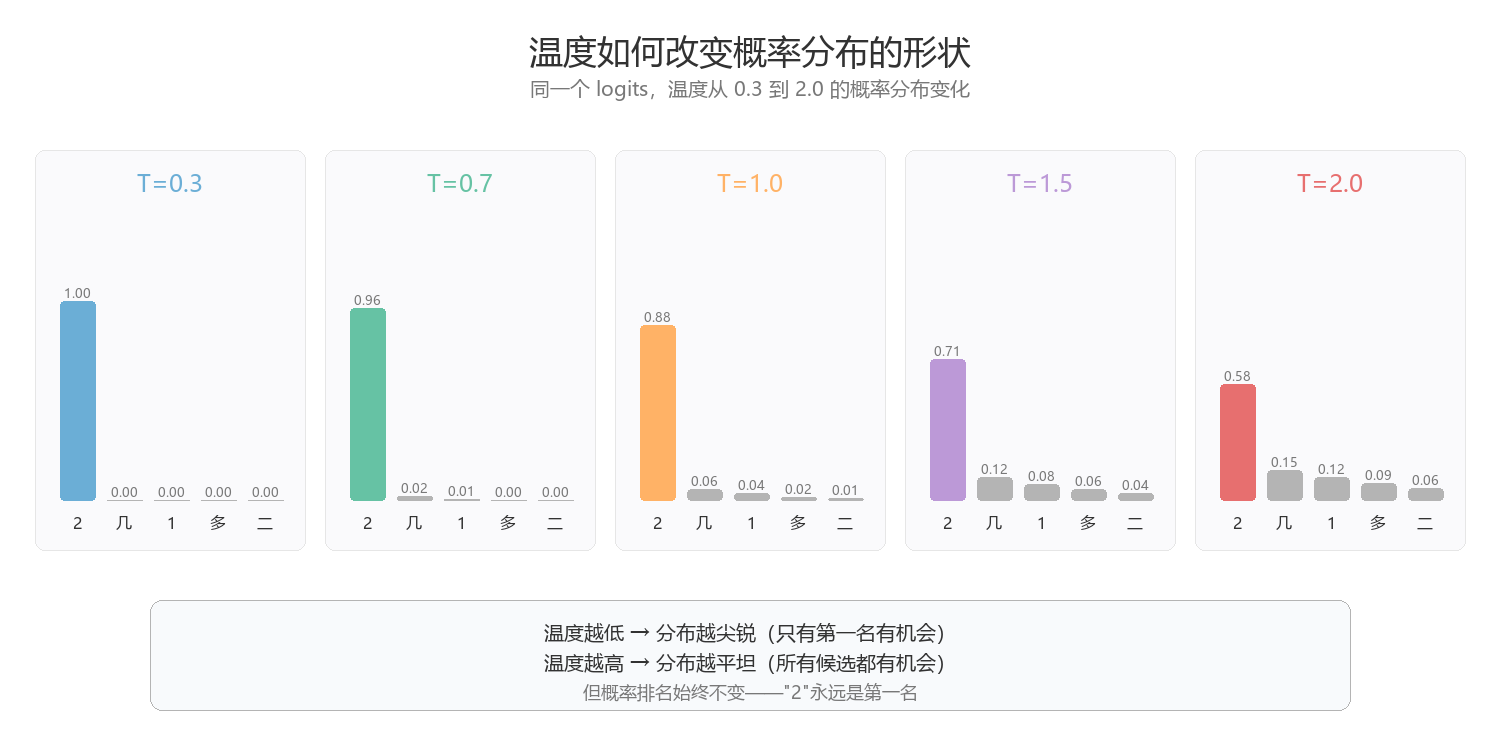
图2:同一个 logits 分布,温度从 0.3 到 2.0 的变化。低温让分布尖锐(几乎只有一个候选),高温让分布平坦(所有候选都有机会)。注意 T=0.3 和 T=2.0 不是简单的“反义词”,它们对分布形状的影响是非对称的。
2.2 用代码看温度的效果
不要光看概念,跑一下代码就懂了:
import numpy as np

logits = np.array([3.2, 0.5, 0.0, -0.6, -1.2])
labels = ["2", "几", "1", "多", "二"]

def softmax_with_temperature(logits, T):
    """带温度的 Softmax"""
    scaled = logits / T
    exp_x = np.exp(scaled - scaled.max())  # 减最大值防溢出
    return exp_x / exp_x.sum()

for T in [0.3, 0.7, 1.0, 1.5, 2.0]:
    probs = softmax_with_temperature(logits, T)
    bar = " ".join(f"{l}:{p:.3f}" for l, p in zip(labels, probs))
    print(f"T={T:<4}  {bar}")
跑完你会看到这样的变化:
T=0.3   2:1.000 几:0.000 1:0.000 多:0.000 二:0.000
T=0.7   2:0.964 几:0.020 1:0.010 多:0.004 二:0.002
T=1.0   2:0.875 几:0.059 1:0.036 多:0.020 二:0.011
T=1.5   2:0.706 几:0.117 1:0.084 多:0.056 二:0.038
T=2.0   2:0.581 几:0.151 1:0.117 多:0.087 二:0.064
直观感受:
- T=0.3 时,“2”几乎吃掉全部概率(1.000),你问一百次都是“2”
- T=1.0 时,“2”还有 85%,但有 15% 的概率选别的
- T=2.0 时,“2”只剩 45%,其他候选项的概率大幅上升,模型开始“开脑洞”
2.3 一个关键细节:温度不改变排名
注意一个容易被忽略的事实:温度只改变概率的“差距”,不改变概率的“排名”。
不管温度怎么调,概率最高的 Token 始终是同一个(上例中的“2”)。温度改变的是“第二名追上第一名的概率有多大”。
这就是为什么很多人说“低温更准”——不是低温让模型变聪明了,而是低温让模型更倾向于选它本来就认为最可能的答案。
2.4 T=0 不是绝对固定输出
很多人以为 temperature=0 就等于“每次输出一模一样”。严格来说不是。
原因有三:
- 浮点精度:不同硬件(CPU/GPU/不同型号显卡)的浮点运算结果有微小差异,Softmax 的概率分布可能不完全相同
- 实现差异:有些框架在 T=0 时走的是
argmax(直接取最大值的索引),有些用极小温度近似(如 T=0.01),行为不完全一致 - 批处理效应:多个请求一起推理时,由于 padding 和 batching 的实现,即使 T=0 也可能有数值差异
所以 OpenAI 官方文档说的是“low temperatures will result in more deterministic completions”(更确定,而非完全确定),这个措辞是很严谨的。
如果你需要严格可复现,不能只靠 temperature=0,需要固定 seed、固定 batch size、固定硬件,甚至锁模型版本快照。
3. Top-K:固定候选人数量
3.1 问题:温度调不动了怎么办
温度有个局限:它改变的是整体分布的“陡峭程度”,但不删除任何候选 Token。
比如 T=2.0 时,虽然“二”这个 Token 的概率从 1.1% 涨到了 6.2%,但那些概率只有 0.0001% 的垃圾 Token 依然在候选池里。万一抽签运气好(或不好),模型就可能输出一个完全不合理的 Token。
Top-K 就是来解决这个问题的:直接砍掉概率最低的那些候选。
3.2 原理:只留前 K 名
Top-K 采样(Top-K Sampling)的逻辑特别简单:概率从高到低排序,只保留前 K 个 Token,其余的全部置零,然后在剩下的 K 个里按概率采样。
比如设 K=3:
原始概率:2:0.88, 几:0.06, 1:0.04, 多:0.02, 二:0.01, ...

Top-K=3 后:2:0.88, 几:0.06, 1:0.04, 多:0, 二:0, ...

重新归一化:2:0.903, 几:0.061, 1:0.037
“多”和“二”被直接踢出候选池,不管温度多高都不会被选中。
3.3 Top-K 的问题:K 是死的,分布是活的
Top-K 最大的问题是 K 是一个固定数字,但概率分布是千变万化的。
来看两种极端情况:
情况一:模型非常确定(如“1+1 等于”)
概率分布:2:0.99, 几:0.005, 1:0.002, ...
K=40 的话,会保留 40 个 Token,但其中 39 个概率几乎为零。Top-K 在这里没有起到任何过滤作用——反正概率最高的那个几乎必中。
情况二:模型很不确定(如“今天天气怎么样”)
概率分布可能是:晴:0.15, 阴:0.12, 雨:0.11, 雪:0.08, 风:0.07, ...
前 5 个 Token 的概率加起来才 53%,K=40 会保留一堆低概率的长尾候选,但 K=5 又可能漏掉一些合理选项。
这就是 Top-K 的困境:它不知道当前分布是“尖锐”还是“平坦”,一刀切 K 个,两头不讨好。
3.4 谁还在用 Top-K
2026 年的现状:
| 平台 | Top-K 支持 | 备注 |
|---|---|---|
| OpenAI API | 不支持 | ChatGPT 和 API 均不支持 top_k 参数 |
| Anthropic Claude API | 支持 | 不填=不过滤,官方未公布具体范围 |
| Google Gemini API | 支持 | 默认值 -1(不过滤),范围 1-1000 |
| DeepSeek API | 不支持 | 兼容 OpenAI 协议,无 top_k |
| vLLM / llama.cpp | 支持 | 默认 -1(不过滤),本地部署常用 |
结论:Top-K 正在被边缘化。 商业 API 支持度低,行业首选是 Top-P。但它在本地部署(vLLM、llama.cpp)中依然是常用选项。
4. Top-P:动态候选人
4.1 原理:不固定数量,固定概率总和
Top-P(也叫核采样,Nucleus Sampling)的思路是:不固定保留多少个 Token,而是保留概率累加到 P 的那些 Token。
以 P=0.9 为例:
排序后概率:2:0.88, 几:0.06, 1:0.04, 多:0.02, 二:0.01, ...

累计概率:
  2:     0.88  → 还没到 0.9,继续
  几:    0.94  → 到了!停。

保留:2, 几
其余置零,重新归一化
注意:0.85 已经很接近 0.9 了,所以只多留了 1 个候选。 如果概率分布很分散(如“晴:0.15, 阴:0.12, 雨:0.11…”),Top-P=0.9 可能会保留六七个候选。
4.2 为什么 Top-P 比 Top-K 好用
一句话:Top-P 是自适应的。
- 概率分布尖锐时(模型很确定),Top-P 只保留很少几个 Token
- 概率分布平坦时(模型不确定),Top-P 保留更多 Token
它不像 Top-K 那样“不管三七二十一留 K 个”,而是根据当前分布的形状动态调整候选池大小。这就是为什么 Top-P 成了 2024-2026 年行业首选。
4.3 Top-P 的选择建议
| Top-P 值 | 效果 | 适用场景 |
|---|---|---|
| 0.9 | 常用默认值 | 大多数对话/创作场景 |
| 0.1-0.3 | 极度保守 | 代码生成、数学计算、事实问答 |
| 0.5-0.7 | 偏保守 | 客服、摘要、结构化输出 |
| 1.0 | 不过滤 | 等同于只用温度控制 |
| >1.0 | 无意义 | Top-P 最大就是 1.0,超过等于不过滤 |
4.4 搭配温度使用
Top-P 和温度可以同时用,但 OpenAI 官方建议不要同时改两个:
“We generally recommend altering this or temperature but not both.”
原因:两个参数都在影响概率分布,同时调容易“过度矫正”,导致输出偏离预期。实践中的常见做法是:
- 需要精确输出:temperature=0.1~0.3, top_p=0.9(或者只设 temperature=0)
- 需要创意输出:temperature=0.7~0.9, top_p=0.95
- 需要最大多样:temperature=1.0~1.2, top_p=1.0(不过滤,全靠温度)
5. Min-P:2024 年的新选手
5.1 Top-P 的一个隐藏痛点
Top-P 虽好,但有个不太显眼的痛点:它的计算依赖“概率排序后的累计”,需要遍历整个词表,在词表很大(如 128K+)时有额外开销。
更重要的是,Top-P 的阈值 P 是一个“绝对概率值”。但不同 Token 位置的概率分布天差地别——有些位置模型很确定(最高概率 0.99),有些位置模型很犹豫(最高概率 0.15)。用同一个 P=0.9 去卡,在不同位置的“宽松程度”是不一样的。
5.2 Min-P 的思路:不卡累计,卡绝对值
Min-P(Minimum Probability Sampling)的逻辑更简单:只保留概率 ≥(最高概率 × min_p)的 Token。
比如设 min_p=0.05,当前最高概率是 0.88:
阈值 = 0.88 × 0.05 = 0.044

保留概率 ≥ 0.044 的 Token:
  2:  0.88  ✓ 保留
  几: 0.06  ✓ 保留
  1:  0.04  ✗ 丢弃(0.04 < 0.044)
  多: 0.02  ✗ 丢弃
  二: 0.01  ✗ 丢弃
如果最高概率只有 0.15 呢?
阈值 = 0.15 × 0.05 = 0.0075

保留概率 ≥ 0.0075 的 Token → 更多候选被保留
看到区别了吗?Min-P 的阈值是“相对的”——跟当前最高概率成正比。 模型确定时,阈值高,候选少;模型犹豫时,阈值低,候选多。这个自适应性和 Top-P 类似,但实现更简单。
5.3 为什么说 Min-P 更好
社区实践表明 Min-P 有几个优势:
- 更简单:不需要排序+累加,只需要一次比较
- 更自适应:阈值随最高概率动态缩放,天然适配不同确定性程度
- 更可预测:min_p=0.05 在任何分布下的“宽松程度”是一致的;而 top_p=0.9 在不同分布下保留的候选数可以差好几倍
- 在大词表上更高效:不需要遍历整个排序序列
llama.cpp、vLLM、Hugging Face Transformers 都已支持 Min-P。越来越多本地部署的用户从 top_p=0.9 切换到 min_p=0.05~0.1,反馈效果更好。
但要注意:Min-P 目前主要在本地推理框架中可用,商业 API(OpenAI、Claude、DeepSeek)还不支持 min_p 参数。
6. 三者关系:执行顺序与组合
6.1 它们不是“三选一”
很多人把 Temperature、Top-K、Top-P 当成三种独立的采样策略,以为“选一个用就行”。实际上它们是流水线上的三道工序,可以串联。
真实的采样流程:
原始 Logits
    ↓
[1] 温度缩放:logits / T
    ↓
[2] Softmax → 概率分布
    ↓
[3] Top-K 过滤:只留前 K 个(如果设了)
    ↓
[4] Top-P 过滤:只留累计到 P 的(如果设了)
    ↓
[5] Min-P 过滤:只留 ≥ max_prob × min_p 的(如果设了)
    ↓
[6] 从过滤后的分布中采样
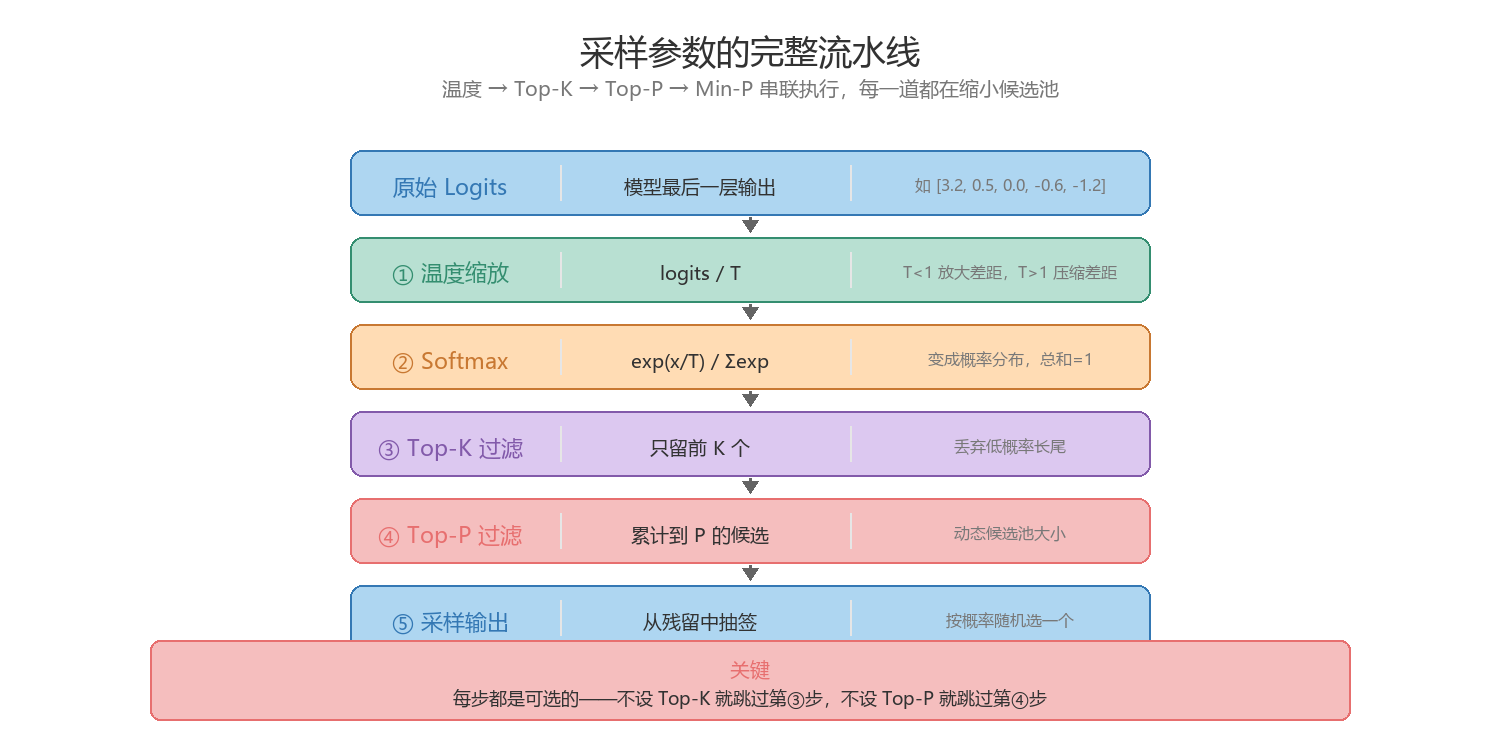
图3:Logits 先过温度缩放,变概率后依次通过 Top-K、Top-P、Min-P 三道过滤,最后从残留候选中采样。三道过滤不是“三选一”,而是串联的流水线——每一道都在缩小候选池。
6.2 用代码实现完整流水线
下面这段代码完整展示了“温度 + Top-K + Top-P”的采样流程,你可以直接跑:
import numpy as np

def sample_token(logits, temperature=1.0, top_k=0, top_p=1.0):
    """
    完整采样流水线:温度 → Top-K → Top-P → 采样
    top_k=0 表示不过滤;top_p=1.0 表示不过滤
    """
    # 1) 温度缩放
    if temperature == 0:
        return np.argmax(logits)  # 贪心解码
    scaled = logits / temperature

    # 2) Softmax
    exp_x = np.exp(scaled - scaled.max())
    probs = exp_x / exp_x.sum()

    # 3) Top-K 过滤
    if top_k > 0 and top_k < len(probs):
        # 找到第 K 大的概率,低于它的全部置零
        threshold = np.sort(probs)[-top_k]
        probs[probs < threshold] = 0
        probs = probs / probs.sum()  # 重新归一化

    # 4) Top-P 过滤
    if top_p < 1.0:
        sorted_idx = np.argsort(probs)[::-1]  # 从高到低排
        cumsum = np.cumsum(probs[sorted_idx])
        # 找到累计超过 top_p 的位置,之后的全部置零
        cutoff = np.searchsorted(cumsum, top_p) + 1
        mask = np.zeros_like(probs, dtype=bool)
        mask[sorted_idx[:cutoff]] = True
        probs[~mask] = 0
        probs = probs / probs.sum()  # 重新归一化

    # 5) 采样
    return np.random.choice(len(probs), p=probs)

# 测试
logits = np.array([3.2, 0.5, 0.0, -0.6, -1.2])
labels = ["2", "几", "1", "多", "二"]

np.random.seed(42)
print("T=1.0, no filter:    ", labels[sample_token(logits, temperature=1.0)])
print("T=0.3, no filter:    ", labels[sample_token(logits, temperature=0.3)])
print("T=1.0, top_k=2:      ", labels[sample_token(logits, temperature=1.0, top_k=2)])
print("T=1.0, top_p=0.9:    ", labels[sample_token(logits, temperature=1.0, top_p=0.9)])
print("T=1.5, top_p=0.9:    ", labels[sample_token(logits, temperature=1.5, top_p=0.9)])
跑几遍你会直观感受到:温度控制“敢不敢选冷门”,Top-K/Top-P 控制“冷门有多冷”。两个维度叠加,才是完整的采样控制。
6.3 温度和 Top-P 的交互
一个容易搞混的点:温度和 Top-P 是先后执行的,不是同时生效的。
温度先改变概率分布的形状,Top-P 再在这个被改变后的分布上做过滤。所以:
- T=2.0 + top_p=0.9:先让分布变平坦,再留累计 90% 的候选 → 候选数可能比 T=1.0 时更多
- T=0.3 + top_p=0.9:先让分布变尖锐,再留累计 90% 的候选 → 可能只留 1~2 个
这就是为什么 OpenAI 说“不要同时改两个”——效果是叠加的,很容易矫枉过正。
7. 不只是采样:贪心解码与 Beam Search
采样策略不是只有“温度 + Top-K/P”这一条路。在它们之前,还有两种更基础的解码方式。
7.1 贪心解码(Greedy Decoding)
最简单的解码方式:每步直接选概率最高的 Token,不做任何随机。
等价于 temperature=0 或 np.argmax(logits)。
优点:速度快、完全确定、不会选到离谱的 Token。
缺点:容易陷入局部最优。贪心只看单步概率最高,不保障整句话是最优的。经典例子:
Prompt: "The cat sat on the"

贪心解码可能输出: "The cat sat on the mat."
(但更通顺的可能是 "The cat sat on the floor.")
贪心选了“mat”(单步概率最高),但不一定是整句最通顺的选择。这就是为什么 temperature=0 的输出有时会“机械重复”或“不太自然”。
7.2 Beam Search(束搜索)
贪心只保留 1 条路径,Beam Search 保留 B 条候选路径并行比较。
原理:每个时间步保留概率最高的 B 个候选序列,用这些序列继续往下生成,最后选总概率最高的那条。
比如 beam_width=3:
步骤1: 保留 3 个候选 → ["2", "几", "1"]
步骤2: 每个候选各生成 3 个后续,共 9 个,再选概率最高的 3 个
步骤3: 继续扩展...
最后: 从 3 条完整路径中选总概率最高的输出
优点:比贪心更全局、输出更通顺。
缺点:
- 计算开销大:beam_width=B,计算量约为贪心的 B 倍
- 缺乏多样性:始终选概率最高路径,输出偏保守
- 大模型时代不太用了:Beam Search 在小模型时代(GPT-2、翻译模型)是标配,但大模型本身能力足够强,贪心/低温采样就够好了
7.3 四种解码方式对比
| 方式 | 原理 | 确定性 | 多样性 | 计算开销 | 适用场景 |
|---|---|---|---|---|---|
| 贪心解码 | argmax(logits) | 完全确定 | 无 | 最低 | 代码、数学、事实问答 |
| Beam Search | 保留 B 条路径 | 确定性(弱) | 低 | 高(×B) | 翻译、摘要(传统NLP) |
| 温度采样 | 概率缩放后随机 | 不确定 | 中~高 | 低 | 对话、创作(主流) |
| Top-K/P 采样 | 过滤后随机 | 不确定 | 可调 | 低 | 对话、创作(主流) |
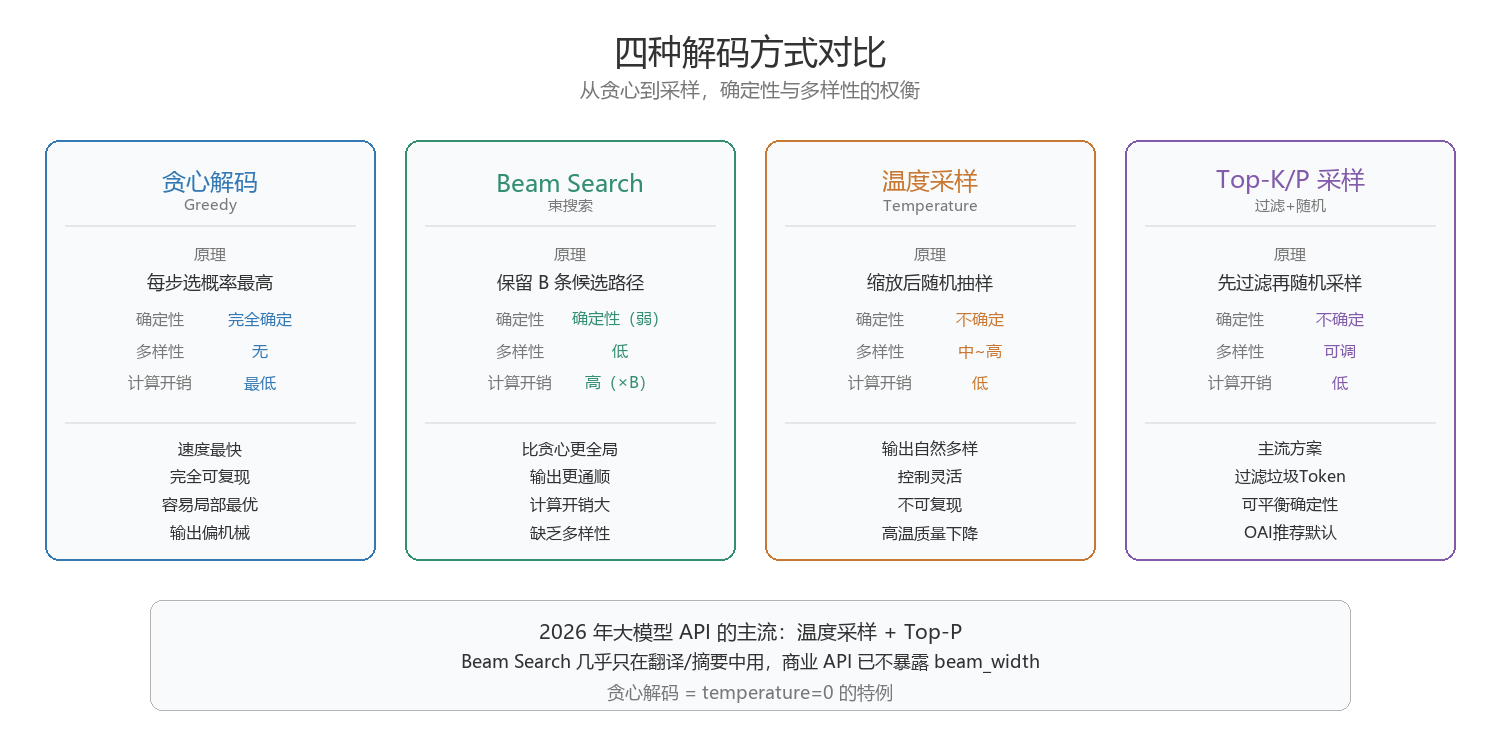
图4:贪心解码只走一条路(最快但容易局部最优),Beam Search 并行搜索多条路(更优但更贵),采样策略引入随机性(更自然但不确定)。大模型时代的主流是“低温 + Top-P 采样”。
关键结论:2026 年的大模型 API 场景,Beam Search 几乎不用了。 你在 OpenAI、Claude、DeepSeek 的 API 中看不到 beam_width 参数——这些模型默认用采样策略。Beam Search 主要残留在翻译引擎和摘要系统中。
8. 各家 API 参数一览(2026 年版)
讲完原理,给你一张可以直接查的参数汇总表。所有数据基于 2026 年 8 月各平台官方文档。
| 平台 | temperature 范围 | 默认值 | top_p 支持 | top_k 支持 | min_p 支持 | 备注 |
|---|---|---|---|---|---|---|
| OpenAI | 0~2 | 1.0 | 是(默认 1.0) | 否 | 否 | 建议改 temperature 或 top_p 其一 |
| Anthropic Claude | 0~1 | 1.0 | 是(默认 1.0) | 是(不填=不过滤) | 否 | temperature 上限 1.0(比别家低) |
| Google Gemini | 0~2 | 1.0 | 是(默认 1.0) | 是(默认 -1) | 否 | top_k 范围 1~1000 |
| DeepSeek | 0~2 | 1.0 | 是(默认 1.0) | 否 | 否 | 兼容 OpenAI 协议 |
| Qwen(灵积/DashScope) | 0~2 | 1.0 | 是(默认 1.0) | 是 | 否 | 部分模型支持 top_k |
| vLLM(本地部署) | 0~任意 | 1.0 | 是 | 是 | 是 | 全功能支持 |
| llama.cpp(本地部署) | 0~任意 | 0.8 | 是 | 是 | 是 | 全功能支持 |
几个值得注意的事实:
- 几乎所有平台的 temperature 默认都是 1.0——这是行业共识
- Anthropic 的 temperature 上限是 1.0(不是 2.0),比其他平台更保守
- OpenAI 和 DeepSeek 都不支持 top_k——Top-K 在商业 API 中确实在被淘汰
- Min-P 只在本地部署框架中可用——商业 API 还没跟进
8.1 认知模型(Reasoning Models)的特殊行为
2024 年以来,OpenAI o1/o3、DeepSeek-R1、Claude Thinking 等认知模型引入了“推理模式”。这些模型在“思考阶段”(thinking/reasoning tokens)的采样行为和正常输出不同:
- 思考阶段的温度通常固定,不受用户设的 temperature 影响(模型内部自主调节)
- 最终回答阶段才用用户设的采样参数
- DeepSeek-V3 进一步引入了“动态温度调节”(见下一节)
这就是为什么你给 o1 设 temperature=0,它的“思考过程”依然会有不同路径——思考阶段的采样你控不了。
9. DeepSeek-V3 的动态温度:采样的新范式
9.1 静态温度的局限
到目前为止,我们讲的温度都是“静态的”——你设一个 T 值,模型从头到尾都用这个值。但“一刀切”有问题:
- 生成开头需要“确定引导”,温度应该低一些
- 展开论述需要“丰富表达”,温度可以高一些
- 收尾需要“稳准收束”,温度又应该低一些
固定温度无法兼顾这些不同阶段的需求。
9.2 DeepSeek-V3 的做法
DeepSeek-V3 引入了动态温度调节算法(Dynamic Temperature Scaling,DTS):
根据当前推理阶段的“任务负载”和输出特征,动态调整温度值:
- 高置信度场景(如数学推理的中间步骤):自动降低温度,确保确定性
- 低置信度场景(如开放性生成):适当提高温度,增加多样性
- 过渡阶段:平滑调节,避免输出风格突变
你不需要手动调温度——模型自己根据上下文“感知”当前该不该放飞。
9.3 这意味着什么
动态温度对开发者的直接影响:
- API 层面的 temperature 参数,在 DeepSeek-V3 上更像是“建议值”而非“精确控制”——模型会在你设的值附近动态波动
- Agent/RAG 项目用 DeepSeek 时,设 temperature=0 的“确定性”比传统模型更稳健——因为模型在关键步骤会自动降温度
- 这可能是未来趋势——从“手动调参”到“模型自适应”,就像从“手动挡”进化到“自动挡”
其他厂商也在跟进类似思路:OpenAI 的认知模型在推理阶段内部做“自温控”,Claude 的 Thinking 模式也会在思考链中隐式调节采样行为。采样正在从“外部参数”变成“内部能力”。
10. 三个真坑,每个都付过费
坑 1:把 temperature=0 当“完全可复现”
有次我写了一个自动化测试框架,调 GPT API 做“给定输入→期望输出”的断言。设了 temperature=0,心想“这不就确定了吗?”结果跑十次有八次通过,两次失败——模型偶尔会输出不同的 Token 序列。
原因:前面说过,T=0 不是绝对确定。浮点精度差异、批处理效应、甚至 API 后端的路由(不同 GPU 实例)都会影响。
解法:
- 不要对大模型做精确字符串匹配的断言
- 改用语义相似度、结构化校验(如 JSON Schema)、或多次采样取众数
- 如果必须可复现,固定
seed参数(OpenAI 支持seed)+ 固定模型版本快照(如gpt-5.5-2026-04-23),但仍不保障 100%
坑 2:temperature 调太高,模型“胡言乱语”
同事做一个客服 Bot,为了让回复“更自然”,设了 temperature=1.5。结果 Bot 开始“开脑洞”——用户问“退货流程”,它回复“退货是一种哲学,反映了消费主义时代的存在焦虑……”
原因:T=1.5 让概率分布极度平坦,模型从“选最优”变成了“几乎随机抽”,低概率 Token 频繁被选中。
解法:
- 客服/问答/代码:T=0.1~0.3
- 对话/摘要/改写:T=0.5~0.7
- 创意写作/故事:T=0.7~0.9
- 不要超过 1.2——超过后输出质量急剧下降,不是“更有创意”而是“更不靠谱”
坑 3:不知道 Agent/RAG 要设 temperature=0
团队做 RAG 系统,用 temperature=0.7 调模型生成回答。结果同一个问题每次回答风格都不同,有时还出现不同的“幻觉”——第一次说“根据文档……”,第二次说“我觉得……”。
原因:RAG 系统的核心是“基于检索到的文档回答”,需要的是确定性和事实准确性,不是创意。高温引入的随机性会让模型在同一组文档上生成不同的推理路径,部分路径可能是错的。
解法:Agent 和 RAG 项目,清一色 temperature=0(或尽量低)。这是行业默认实践,原因有三:
- Agent 需要可预测的行为链:工具调用、决策路径不能“掷骰子”
- RAG 需要事实一致性:同一个知识库不能每次给出不同的答案
- 调试成本:高温输出不可复现,Bug 报了也查不出来
11. 动手实验:感受温度的力量
11.1 用 Python 模拟不同温度下的采样
这段代码让你直观看到温度如何改变模型的“选择倾向”:
import numpy as np

def softmax_with_temp(logits, T):
    """带温度的 Softmax"""
    if T == 0:
        result = np.zeros_like(logits)
        result[np.argmax(logits)] = 1.0
        return result
    scaled = logits / T
    exp_x = np.exp(scaled - scaled.max())
    return exp_x / exp_x.sum()

# 模拟一个真实场景的 logits(10 个候选 Token)
np.random.seed(0)
logits = np.array([6.8, 3.2, 2.5, 1.8, 0.9, 0.3, -0.5, -1.2, -2.0, -3.0])
labels = ["的", "了", "在", "是", "有", "和", "人", "这", "中", "大"]

print("温度对采样分布的影响(模拟)\n")
for T in [0.1, 0.5, 1.0, 1.5, 2.0]:
    probs = softmax_with_temp(logits, T)
    # 模拟采样 1000 次
    samples = np.random.choice(len(labels), size=1000, p=probs)
    counts = np.bincount(samples, minlength=len(labels))
    dist = " ".join(f"{l}:{c:3d}" for l, c in zip(labels, counts))
    print(f"T={T:<4}  {dist}")

print("\n观察:T=0.1 几乎只选'的',T=2.0 开始'百花齐放'")
print("但注意:概率排名始终不变——'的'永远是第一名")
11.2 采样参数推荐速查表
根据不同场景,给你一套直接能用的参数组合:
| 场景 | temperature | top_p | top_k | 备注 |
|---|---|---|---|---|
| 代码生成 | 0~0.2 | 0.9 | 不设 | 确定性优先 |
| 数学/逻辑推理 | 0~0.1 | 0.9 | 不设 | 越低越好 |
| Agent/工具调用 | 0 | 1.0 | 不设 | 必须确定性 |
| RAG 问答 | 0~0.3 | 0.9 | 不设 | 事实优先 |
| 客服对话 | 0.3~0.5 | 0.85 | 不设 | 稳中有变 |
| 摘要/改写 | 0.3~0.5 | 0.9 | 不设 | 忠于原文 |
| 闲聊/创意对话 | 0.7~0.9 | 0.95 | 不设 | 自然多样 |
| 故事/小说创作 | 0.8~1.0 | 0.97 | 不设 | 追求创意 |
| 头脑风暴 | 1.0~1.2 | 1.0 | 不设 | 越发散越好 |
| JSON/结构化输出 | 0 | 1.0 | 不设 | 必须确定性 |
一个经验法则:如果你不确定该设多少,先从 temperature=0.7, top_p=0.9 开始,根据效果微调。 这是 90% 场景下的安全默认值。
12. 经验清单:带走这 5 条
-
温度改变概率差距,不改变概率排名:T=0.3 和 T=2.0 的区别是“第二名追第一名的概率有多大”,不是“谁是第一名”。低温更保守不是更聪明,是更倾向于选它早就觉得最可能的答案。
-
Top-K 在死,Top-P 在活,Min-P 在涨:商业 API 已不支持 Top-K(OpenAI、DeepSeek),Top-P 是行业首选,Min-P 是本地部署新趋势。如果你用本地模型(vLLM、llama.cpp),试试
min_p=0.05替代top_p=0.9,可能效果更好。 -
Agent 和 RAG 必须 temperature=0:工具调用、事实问答需要确定性,随机性只会引入不可复现的 Bug。但记住 T=0 不等于 100% 可复现——需要固定 seed、锁模型版本。
-
认知模型的采样你控不了:o1/o3 的思考阶段、DeepSeek 的动态温度,模型内部自主调节采样,你设的 temperature 只影响“最终回答”阶段。从“手动调参”到“模型自温控”是趋势。
-
别同时调 temperature 和 top_p:OpenAI 官方建议二选一。要精确就降温度(到 0.1~0.3),要创意就升温度(到 0.7~0.9),不要“一个降一个升”地对拉——容易矫枉过正。
本文所有数据基于 2026 年 8 月公开信息整理。各平台 API 参数范围与默认值来自官方文档:OpenAI(platform.openai.com/docs)、Anthropic(docs.anthropic.com)、Google Gemini(ai.google.dev)、DeepSeek(api-docs.deepseek.com)。Min-P 原理参考社区实践与 llama.cpp/vLLM 文档。DeepSeek-V3 动态温度算法参考百度智能云技术文章及社区分析。采样公式与 Softmax 推导参考 Hugging Face Transformers 文档及多篇 CSDN 技术博客。具体参数以各平台最新文档为准。
下篇预告
下一篇:《大模型实战指南(4)——Embedding 与向量检索:让模型“记住”百万篇文章的秘密》
上一篇讲了模型怎么从概率中“选词”。但模型每次对话都得把所有内容塞进上下文窗口——窗口满了怎么办?答案就是向量检索(RAG)。Embedding 是什么?为什么一段文字能变成一组数字就能“算相似度”?Faiss 和 Milvus 到底在干什么?下一讲揭开“模型记忆”的秘密。
系列:大模型实战指南,篇篇连载,从 Token 到 Agent,带你从零搞懂大模型。关注不迷路。下篇:Embedding 与向量检索。
更多推荐

 5
 0
- 0


 已为社区贡献10条内容

所有评论(0)