


- @weixin_43283487


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
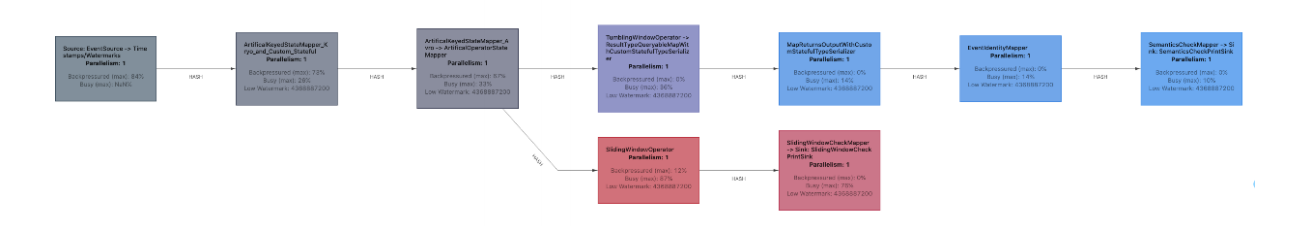
我这个是并行度是 4 ,所以会有 0、1、2、3 代表是哪个 subTask(task 下每个并行task),其中看到的比较多的是这两个,outPutUsage 代表发送端 Buffer 的使用率,inPutusage 代表的接收端 Buffer 的使用率。也可能是 TaskManager 的内存引起的 GC 问题,也会导致反压,我们一般使用 G1 回收机制,有可能是 TaskManager JV
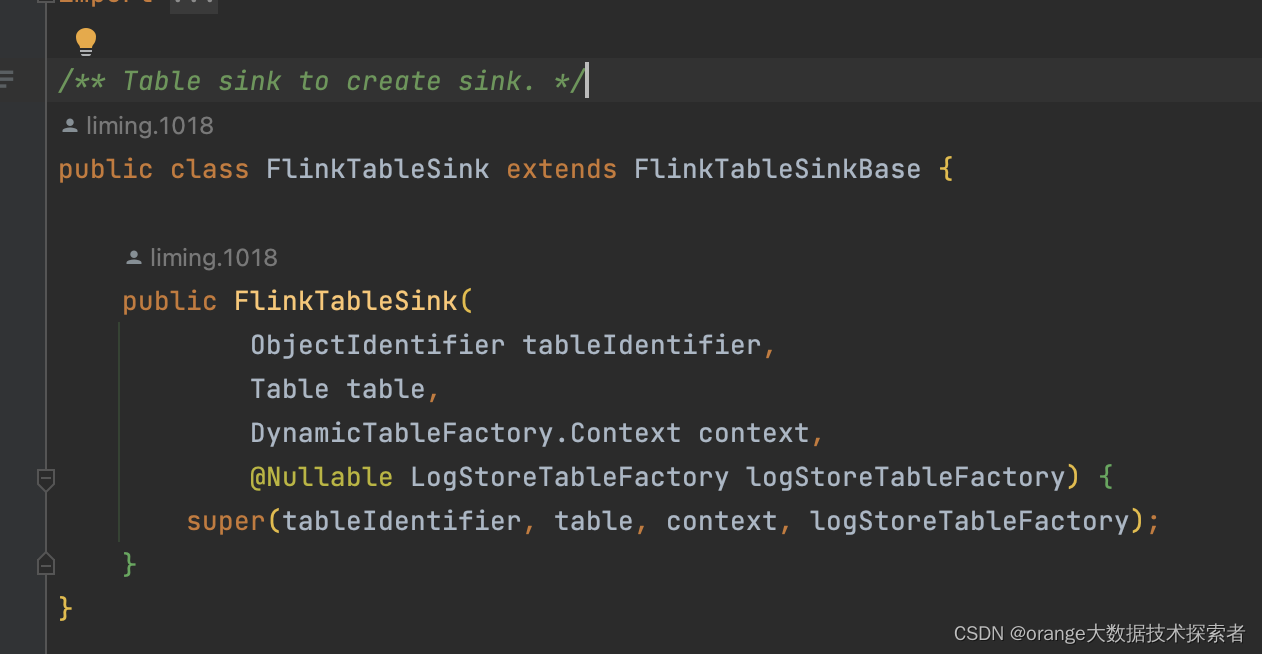
RowDataStoreWriteOperator继承TableWriteOperator,这个类又通过provider初始化了write,RowDataStoreWriteOperator类刚才用到了父类TableWriteOperator的write对象。以StoreSinkWrite.Provider是StoreSinkWriteImpl为例,那上面的write()实际调用就是这个类的wri
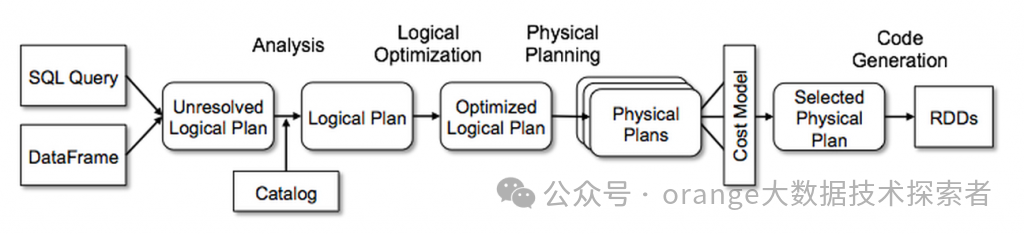
大致的流程是这样的,先记好每个阶段,我们来一起探索每个阶段在哪里,又做了什么。
url编码%2A 之类ENCODE可以不写,也可以是自定义的编码格式例如GBK UTF-8解码java.net.URLDecoder.decode(str, ENCODE);转码java.net.URLEncoder.encode(str, ENCODE);
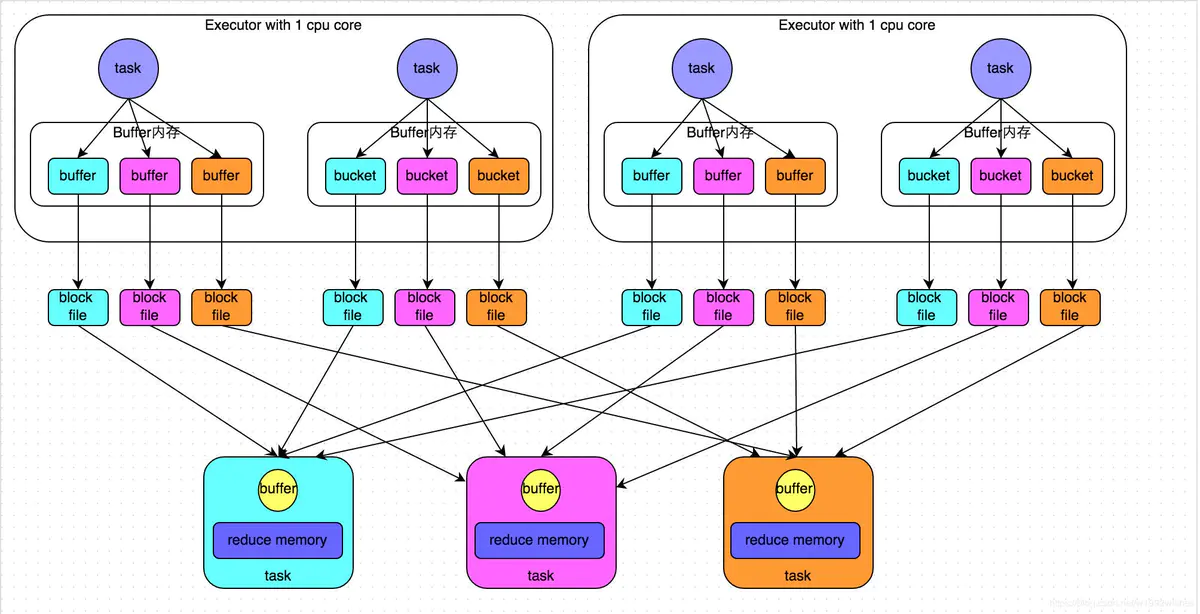
task的生成:首先需要stage划分,依据划分的stage来生成tasktask的数量和分区的数量和sttage的数量是有直接关系的在发送shuffle的过程中,会产生shuffle write 和shuffle readeshuffle write : 发生在shuf/fle之前,把需要shuffle的数据写到磁盘,保证了数据的可靠性为什么在发送shuffle的时候,需要把数...
案例场景数据结构(k,t,v) k是id,t是时间,v是这个id在某个时间点对应的值股票代码,时间,收盘价AA,2017-1-7,10.8AA,2017-1-8,10.9AA,2017-1-9,11AA,2017-1-30,10.5BB,2017-1-31,10.7BB,2017-2-1,10.9BB,2017-2-2,11.1...
依赖(血缘)的作用RDD只支持粗粒度转换,即在大量记录上执行的单个操作。将创建RDD的一系列Lineage(即血统,依赖)记录下来,以便恢复丢失的分区。RDD的Lineage会记录RDD的元数据信息和转换行为,当该RDD的部分分区数据丢失时,它可以根据这些信息来重新运算和恢复丢失的数据分区。spark的宽窄依赖RDD和依赖的父RDD关系有两种,就是宽依赖和窄依赖宽依赖: 多个子RDD的partit
安装jdk
安装jdk
