


- @weixin_42914912


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
这里写自定义目录标题欢迎使用Markdown编辑器新的改变功能快捷键合理的创建标题,有助于目录的生成如何改变文本的样式插入链接与图片如何插入一段漂亮的代码片生成一个适合你的列表创建一个表格设定内容居中、居左、居右SmartyPants创建一个自定义列表如何创建一个注脚注释也是必不可少的KaTeX数学公式新的甘特图功能,丰富你的文章UML 图表FLowchart流程图导出与导入导出导入欢迎使用Mar
三维高斯溅射是一种场景表达方式,基于高斯椭球小颗粒重建场景的三维结构,通过溅射的方式打到二维平面显示器实现快速的画面渲染。从应用上讲,用户输入多幅目标场景图片给模型,模型将重建3D Gaussian场景,继而能够通过溅射场景3D模型到不同相机位置的2D平面进行渲染。这里作个不严谨的比喻,椭球相当于组成人体结构的细胞,而当我们用眼睛看人体时,我们是看到表皮细胞反射的光线溅射到我们眼底视网膜上的形象。
Livox ROS Driver 2教程摘要:本文介绍了Livox第二代激光雷达驱动在ROS2环境下的使用方法,支持MID360和HAP等设备。内容涵盖驱动安装(需Livox-SDK2和ROS2环境)、配置文件说明(包括网络参数和点云格式)、工作空间结构(含启动文件和消息定义)以及运行方法(基础消息发布和可视化)。文档详细解析了自定义点云数据结构、发布的话题类型(/livox/lidar等),并提
摘要:本研究在CartPole-v1环境中对比了四种强化学习算法性能。实验采用Orin GPU(61.3GB显存)加速训练,PPO算法表现最优:评估平均分500.00,成功率100%,仅需228轮收敛,且稳定性最佳(标准差0.00)。Actor-Critic和Q-Learning虽未达标但表现尚可,GRPO则完全失效。GPU加速显著提升训练效率,其中Q-Learning训练时间最短(121.1秒)
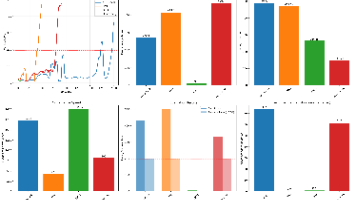
摘要:本研究在CartPole-v1环境中对比了四种强化学习算法性能。实验采用Orin GPU(61.3GB显存)加速训练,PPO算法表现最优:评估平均分500.00,成功率100%,仅需228轮收敛,且稳定性最佳(标准差0.00)。Actor-Critic和Q-Learning虽未达标但表现尚可,GRPO则完全失效。GPU加速显著提升训练效率,其中Q-Learning训练时间最短(121.1秒)
摘要:本研究在CartPole-v1环境中对比了四种强化学习算法性能。实验采用Orin GPU(61.3GB显存)加速训练,PPO算法表现最优:评估平均分500.00,成功率100%,仅需228轮收敛,且稳定性最佳(标准差0.00)。Actor-Critic和Q-Learning虽未达标但表现尚可,GRPO则完全失效。GPU加速显著提升训练效率,其中Q-Learning训练时间最短(121.1秒)
摘要:本研究在CartPole-v1环境中对比了四种强化学习算法性能。实验采用Orin GPU(61.3GB显存)加速训练,PPO算法表现最优:评估平均分500.00,成功率100%,仅需228轮收敛,且稳定性最佳(标准差0.00)。Actor-Critic和Q-Learning虽未达标但表现尚可,GRPO则完全失效。GPU加速显著提升训练效率,其中Q-Learning训练时间最短(121.1秒)