


- @weixin_35810071


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
多层transformer block指的是使用多个transformer结构,按照线性的排列方式,拿到上层的transformer输出,投入到下一个transformer中进行计算。LN2_out只经过了一层transformer block计算、并且这一层的transformer只有一个头的自注意力计算,这个结果是不够全面的,不够完整的。单头注意力不是看不见,而是“只能从一个角度看”, 同一时
举个例子来说:上一篇的美女图片通过我们的眼睛(自注意力机制)看到传入我们的大脑(前馈神经网络),在经过复杂的、多层的传递和计算时,会将一些信息越计算越模糊(比如本就没有占据太多权重的夕阳倒影),所以我们每次在神经网络中传递都在计算结果上。通过残差相加,模型在学习新特征的同时,强行保留了最初的输入信号,防止模型越学越糊涂。比如:美女图片中本就占据很大权重的美女胸部,再经过多层计算,会被放大到更大的范
2025 年初 DeepSeek的爆火,不仅是单一公司的突围,更是全球 AI 行业从“参数军备竞赛”转向“极致工程化”的历史分水岭。经过 2025 全年的行业验证,DeepSeek 所代表的 MoE 架构、MLA 机制、FP8 训练及纯强化学习(Pure RL) 路线,已被证明是平衡性能与成本的综合最优解。它迫使全球 AI 厂商完成了技术栈的重构,确立了“精益计算”的新工业标准。
2025 年初 DeepSeek的爆火,不仅是单一公司的突围,更是全球 AI 行业从“参数军备竞赛”转向“极致工程化”的历史分水岭。经过 2025 全年的行业验证,DeepSeek 所代表的 MoE 架构、MLA 机制、FP8 训练及纯强化学习(Pure RL) 路线,已被证明是平衡性能与成本的综合最优解。它迫使全球 AI 厂商完成了技术栈的重构,确立了“精益计算”的新工业标准。
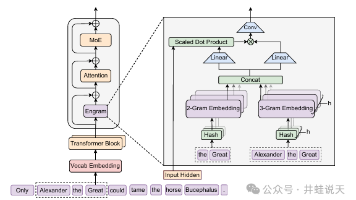
不是比别人多算点题,而是——很多人以为,大模型变强,只有一条路:参数更多、算力更猛、烧钱更狠。而这一次,不是参数,不是算力,而是记忆。
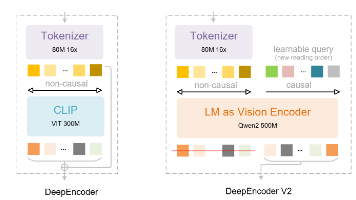
一旦这个思路走通,全模态统一的编码器就有了雏形,未来的 AI 模型就不用再为不同的模态设计不同的处理逻辑,能大幅降低模型的复杂度,提升多模态理解的效率和效果。测试结果显示,在视觉Token 上限更低的情况下,DeepSeek-OCR-2 的整体得分达到了 91.09%,相较 DeepSeek-OCR 提升了 3.73%。你是否有过这样的经历:好不容易找到一篇重要论文,想把里面的内容复制出来,结果O
不是做不出来,是“不愿意这样做”。大厂的核心在模型、算力、API。而 Manus 做的是:脏活累活大量工程细节大量真实场景磨合这不是技术问题,是组织结构和激励机制的问题。
全民养龙虾,是 AI 革命,还是一场幻觉?

全民养龙虾,是 AI 革命,还是一场幻觉?
想象一下,办公室突然空了一大半,桌子还在,人却没了,裁掉的很多人甚至和你私下关系很好,也是曾经你万般邀请才加入你的团队,这份责任感、压力太重了。这就是英伟达的故事,一个从烂工作中起步,在挫折中挣扎,靠运气和坚持活下来,最终承认自己不行的公司。”说实话,我第一次看到 NV1 失败的细节时,感同身受,心心念念的一个自认为很好的想法,结果在市场证明了他就是一堆垃圾。更糟糕的是,微软在1995年推出了Wi
