


- @u010770993


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
在查方法的时候始终有些困扰发觉可以按照增加(Create)、读取查询(Retrieve)、更新(Update)和删除(Delete)来归纳pandas方法中的增删改查,打算近期整理下。最近遇到一个郁闷的问题,就是列名为日期的时候,使用字符串查询列会出现KeyError。但是你单独取df.columns出来,所得的类型又是str,郁闷死。取出来的是str,但是你用str是无法检索的,类型不对。有空得
按照官方教程配置好server.xml后,无论怎么启动tomcat,死活都无法访问加密网页。在cmd下开启tomcat发现如下报错27-Aug-2018 15:39:26.420 信息 [main] org.apache.catalina.startup.VersionLoggerListener.log Server version:Apache Tomcat/9.0.11...
最近写论文,由于学会要求PDF稿内的图片大于300dpi,于是在word那儿折腾了半天。有人推荐用LaTeX类软件来写作,那样导出画质啊格式啊啥的都可调,而且完美……但是抱歉我只有3天时间了,来不及学这么个用编程思维来写文章的软件。于是下列问题如何解决呢?1.Word2013预览里的图片是正常的,但是打印的时候居然只显示一小部分。注意这是放大后的一小部分,别提多蛋碎了,意味着在word
配置好yarn《【解决】处于ACCEPTED状态不running,Oozie提交pyspark任务后》,并解决宕机问题《运行yarn宕机(pyspark任务,通过Oozie提交)》后,出现新的问题:java.io.IOException: Cannot runprogram "python": error=2, No such file or directoryatjava
可以在一个Controller里面实现spark抓取的代码: import org.apache.spark.sql.Dataset;import org.apache.spark.sql.Row;import org.springframework.web.bind.annotation.RequestMapping;import org.springframework.web....
最近一直在钻研IDE直连spark的问题。用vmware建了3个虚拟机,来跑spark集群。安装的python版本是anaconda2的python2在使用pycharm编写pyspark程序连接虚拟机的时候,出现了这样的问题:17/02/23 16:58:52 WARNTaskSetManager: Lost task 1.0 in stage 0.0 (TID 1, hadoop)
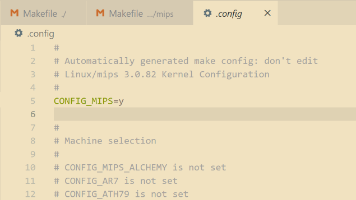
本文记录了在WSL系统中配置MIPS工具链及编译内核的过程。首先解决了32位工具链依赖问题,包括安装strace、libc6-i386和lib32z1库。其次指出WSL与Linux虚拟机文件系统的差异导致老旧MIPS编译器报错,需将代码移至WSL的Linux目录下编译。最后详细描述了内核编译步骤,包括安装依赖库、复制配置文件并成功编译生成vmlinux和vmlinuz文件。整个过程展示了在WSL环
协方差公式推导cov(X,Y)=∑ni=1(Xi−X¯)(Yi−Y¯)n=E[(X−E[X])(Y−E[Y])] cov(X,Y)=\frac{\sum_{i=1}^{n}(X_i-\bar{X})(Y_i-\bar{Y})}{n}=E[(X-E[X])(Y-E[Y])]=E[XY−E[X]Y−XE[Y]+E[X]E[Y]] =E[XY-E[X]Y-XE[Y]+E[X]E[Y]]因为均值
简单地说:原始是JSP、Servlet+?+JDBCSSH是Struts +Spring+HibernateSSM是SpringMVC+Spring+MyBatis 本科毕业完,大致从事某些工作,就得学一些框架了。我们看到招工的时候,企业会要求同学们会Spring、Struts啊hibernate之类的。具体的流程很复杂,我这里做一个知识背