


- @swingwang


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
简单总结: BeeGFS的轻量级架构设计和对现在高性能计算中对Burst Buffer技术需求的精确把握,加上对开源趋势和势态的开怀拥抱将力助BeeGFS在商业上获得成功。此外,BeeGFS也具备丰富的企业级软件特性(后续分享)和强大的生态伙伴,这种种迹象表明,BeeGFS无疑将会是下一个高性能计算领域的Lustre。
不久前Red Hat公司发布了下一代开放软件定义存储平台Red Hat Ceph Storage 2。最新版本的 Red Hat Ceph Storage 基于 Ceph Jewel 发行版,在存储功能和OpenStack集成能力上做了增强。下面我们来讨论下本次Ceph版本更新功能和Ceph在OpenStack中的地位。
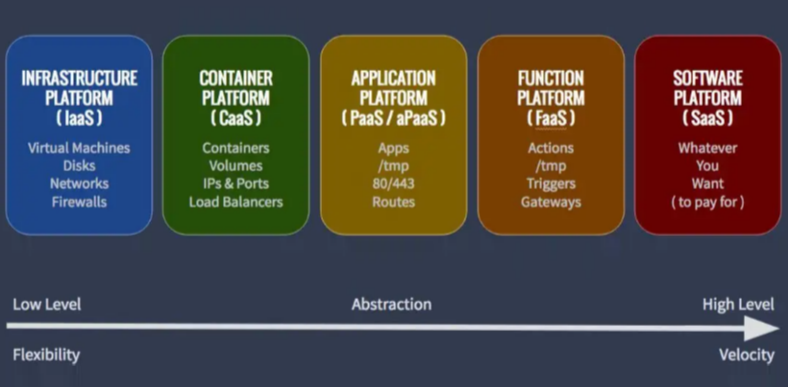
云计算主要分为 4 种类型:私有云、公共云、混合云和多云。同时,云计算服务主要有 3 种:基础架构即服务(IaaS)、平台即服务(PaaS)和软件即服务(SaaS)。
从千亿到万亿,不仅仅是数字的增加,更是模型理解、生成和推理能力的质变。“自主可控的万卡级算力集群,是发展国产万亿参数大模型的必由之路。此次会议集结了国内头部大模型厂商、算力基础设施提供商及专家学者,共同探讨国产“万卡大算力”与“万亿大模型”的协同发展路径,并正式启动联合攻关行动。与封闭式系统不同,开放架构允许不同厂商的硬件和软件组件在统一框架下协同工作,降低了生态锁定的风险,也为后续的技术迭代和生
【AI行业价格战全面爆发】DeepSeek-V4近日掀起降价风暴,Pro版价格降至首发价1/10,Flash版缓存命中价仅0.02元/百万token。此次降价源于技术突破:深度绑定华为昇腾950PR芯片,算力效率提升近3倍,成本降低73%。这标志着AI竞争进入效率战新阶段,RAG知识库、长文档分析等高成本场景将迎来商用爆发。官方暗示下半年将继续降价,预示着国产AI正通过"模型+算力+成本
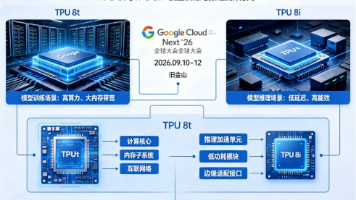
谷歌云发布第八代TPU系列,开创性推出专用于训练和推理的两款独立芯片:TPU8t主打大模型训练,性能提升3倍;TPU8i专注推理服务,延迟降低50%。该系列采用台积电2纳米制程,预计2026年下半年投入使用。谷歌同时宣布2026年将投入1750-1850亿美元用于AI基建,并透露75%的新代码由AI生成。此次发布标志着AI芯片进入专业化时代,挑战英伟达市场主导地位,推动AI产业加速发展。
一.什么是边缘计算边缘计算(Edge Computing)是相对数据中心提出的概念,它是指收集并分析数据的行为发生在靠近数据生成的本地设备和网络中,而不需要将数据传输到计算资源集中化的数据中心进行处理。边缘计算又被叫做分布式云计算、雾计算或第四代数据中心。二. 为什么需要边缘计算整个计算产业发展了进半个世纪,从专用的大型机、小型机到走进千家万户的x86通用服务器,服务器推动着整个...
摘要:DeepSeek-V4预览版突袭式发布,以1M上下文为标配刷新开源大模型天花板。该模型通过mHC多流约束残差、CSA+HCA混合稀疏注意力等创新架构,有效解决长上下文计算瓶颈,在编程、数学推理等任务中媲美闭源顶流。工程上采用Muon优化器、细粒度计算通信重叠等技术,实现高效推理。V4系列包含Pro和Flash两个独立预训练的MoE版本,证明开源模型通过架构创新可突破性能极限。
谷歌云发布第八代TPU系列,开创性推出专用于训练和推理的两款独立芯片:TPU8t主打大模型训练,性能提升3倍;TPU8i专注推理服务,延迟降低50%。该系列采用台积电2纳米制程,预计2026年下半年投入使用。谷歌同时宣布2026年将投入1750-1850亿美元用于AI基建,并透露75%的新代码由AI生成。此次发布标志着AI芯片进入专业化时代,挑战英伟达市场主导地位,推动AI产业加速发展。
摘要:DeepSeek-V4预览版突袭式发布,以1M上下文为标配刷新开源大模型天花板。该模型通过mHC多流约束残差、CSA+HCA混合稀疏注意力等创新架构,有效解决长上下文计算瓶颈,在编程、数学推理等任务中媲美闭源顶流。工程上采用Muon优化器、细粒度计算通信重叠等技术,实现高效推理。V4系列包含Pro和Flash两个独立预训练的MoE版本,证明开源模型通过架构创新可突破性能极限。