- @sinat_27016095


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
垂直拆分:从业务维度出发,将不同业务模块的表拆分到不同的库或者将一个表中的列拆分到不同的表中。垂直分库:例如,将电商系统中的用户库、商品库、订单库分开部署垂直分表:例如,将用户表中的基础信息和详细信息拆分为两个表水平拆分:保持表结构不变,按照某种规则(如数据范围)将数据分散到多个库或表中。水平分库:同一个表的数据分散到不同的数据库实例中水平分表:同一个表的数据分散到同一个库的多个表中拆分方式特点适
/ 针对特定大小的buffer池,避免sync.Pool的GC清理问题size int // buffer的初始容量max int // 池的最大容量max: max,return buf// 防止池无限增长在我们的API网关项目中,将请求处理中的临时buffer改为使用对象池后,每秒节省了约20万次内存分配,GC频率降低了70%,服务延迟从P99的120ms降至45ms。经过多个微服务项目的实战
经过这段分布式锁的探索之旅,我们从基础概念到高级应用,系统地梳理了Go语言实现分布式锁的方方面面。就像一位厨师逐渐掌握从基础刀工到精细烹饪的全套技能,我们现在已经掌握了分布式锁从原理到实践的完整知识体系。并发模型契合分布式场景:goroutine和channel天然适合处理分布式环境中的并发请求和超时控制标准库支持完善:context包提供超时和取消机制,简化分布式操作的控制流错误处理明确:显式的

在正式动手实现之前,我们先来了解一下GoFrame和Jaeger的基本情况。这就像在旅行前先看看地图,明确起点和终点,才能走得更顺畅。Jaeger是一个开源的分布式追踪系统,由Uber开发并开源。它通过记录请求在系统中的传播路径,帮助开发者理解服务间的调用关系。Span:一次请求中的单个操作,比如调用某个API。Trace:由多个Span组成的一个完整请求路径。:在服务间传递追踪上下文,确保Tra

还记得第一次写爬虫时的兴奋吗?几十行代码就能自动获取海量数据,仿佛掌握了互联网的钥匙。然而,当你尝试爬取更大规模的数据,单机爬虫的局限性便显露无遗——速度慢、效率低、容错性差。这就像用一把小铲子挖掘整座金矿,力不从心。从单机爬虫到分布式爬虫,这是数据采集领域的一次飞跃。单机爬虫就像独行侠,孤军奋战;而分布式爬虫则是组建了一支训练有素的特种部队,分工协作,高效执行。分布式爬虫系统在多个领域展现出巨大
在高并发、低延迟的现代系统架构中,Redis已经从一个简单的键值存储演变成了一个功能丰富的数据平台。作为一名与Redis共同成长了10年的开发工程师,我见证了它从3.0到7.0的每一次蜕变。每一个版本的更新都像是给这把"瑞士军刀"增加了新功能,而Redis 7.0无疑是近年来变化最为显著的一次升级。Redis早已不仅仅是一个缓存系统,它已经成为现代应用架构中不可或缺的基础设施。无论是作为分布式锁的
Kafka Connect支持两种运行模式:独立模式和分布式模式。独立(Standalone)模式所有组件运行在单个进程中适合开发、测试或小规模部署配置通过属性文件静态定义不提供自动容错和扩展能力分布式(Distributed)模式多个Worker节点组成集群支持自动负载均衡和故障转移通过REST API动态管理配置提供水平扩展能力和高可用性实践建议:虽然独立模式配置简单,但在生产环境中,强烈推荐
随着大数据和实时处理需求的不断演进,Kafka与Hadoop、Spark的集成方案也在持续发展。了解未来趋势,提前布局,才能在技术浪潮中保持领先。在Kafka与大数据生态集成的旅程中,我们分享了从基础概念到高级架构设计,从代码实践到性能优化的全方位知识。从小切入,循序渐进开始时选择非关键业务场景验证架构充分测试后再扩展到核心业务单一用例成功后再尝试复杂集成技术选型务实为先技术方案符合团队能力水平不
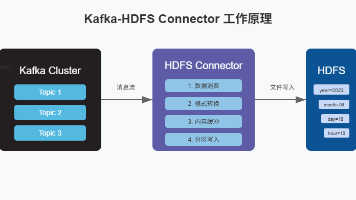
Kafka Connect支持两种运行模式:独立模式和分布式模式。独立(Standalone)模式所有组件运行在单个进程中适合开发、测试或小规模部署配置通过属性文件静态定义不提供自动容错和扩展能力分布式(Distributed)模式多个Worker节点组成集群支持自动负载均衡和故障转移通过REST API动态管理配置提供水平扩展能力和高可用性实践建议:虽然独立模式配置简单,但在生产环境中,强烈推荐
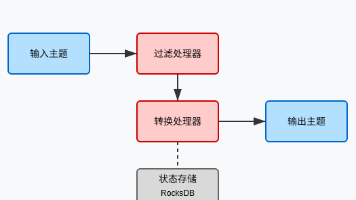
在Kafka Streams中,一切都以"流"为中心。流是一个无限的、持续的事件序列。想象一条永不停歇的河流,数据像水一样持续流动,你的应用则是沿途建立的各种处理站,对流经的水进行过滤、转换或聚合。数据源 --> [过滤] --> [转换] --> [聚合] --> 数据目的地Kafka Streams采用了处理-保存的流处理范式,每条记录都会被独立处理,应用的状态会在处理过程中被保存。📌核心理