


- @shuaiqi1997


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
一、什么是监督学习?监督学习是机器学习中最常见、最直观的学习范式之一。其核心思想是:利用带有“正确答案”(即标签)的训练数据,教会模型从输入到输出的映射关系。“监督”的含义:就像老师指导学生一样,每个训练样本都附带一个“标准答案”(标签),模型通过不断比对预测结果与真实标签来调整自身参数。
分类问题的目标是预测离散的类别标签。也就是说,模型需要判断一个输入样本属于哪一类预定义的类别。输出类型:离散值(如“是/否”、“猫/狗/鸟”、“高/中/低风险”)。典型例子判断一封邮件是否为垃圾邮件(二分类);识别手写数字是0到9中的哪一个(多分类);医学影像诊断:判断肿瘤是良性还是恶性。分类与回归是监督学习的两大支柱,理解它们的区别不仅有助于正确建模,还能避免因任务误判而导致的性能低下。在实际项
大模型 是指参数量巨大(通常在十亿(Billion)级别以上)、通过海量数据训练、具备强大泛化能力和通用任务处理能力的深度学习神经网络模型。大模型是一种通过海量数据和超大规模参数训练出的通用AI引擎,它能理解语言、生成内容、辅助决策,并正在成为企业智能化转型的新基础设施。简单来说,大模型是实现通用人工智能的一种有潜力、但目前尚不完整的路径或工具,而通用人工智能是最终的目标和愿景。自然语言:GPT-
深度学习模型架构、框架和并行计算平台构成了人工智能开发的三层体系:架构是“思考什么”,框架是“如何表达”,并行计算是“如何执行”。理解这三者的区别与联系,不仅能帮助您避免概念混淆,还能让您更好地利用每一层的优势,在AI学习之旅上稳步前行。随着您经验的积累,您将能够自如地在不同抽象层级间切换:用创新架构解决新问题,通过框架高效实现想法,并利用并行计算技术将方案扩展到实际应用中。| **变化频率**
大模型的参数的数量是在模型设计的时候就已经确定好了,在模型训练开始时这些参数都会被赋一个没有意义的猜测值(随机值),随着训练数据的输入通过前向传播模型可以计算出一个结果,这个结果与数据数据的准确答案进行对比,找出模型给出的答案与真实答案的差距(损失),再通过反向传播调整参数的值,一直到参数被调整到输出的答案与真实答案偏差非常小了,这个参数的值也就确定了。· 参数 是模型自身的“内在知识”或“可调旋
2026年,AI不再只是“会聊天”的助手。如果你还在用大模型干“问一句、复制粘贴、关掉窗口”这种事,那你可能已经落后了整整一个时代。真正改变游戏规则的,是 Agent Skills(智能体技能) —— 它正成为2026年最值得关注、最具实战价值的大模型使用方式。但与此同时,另一个概念也频繁出现在技术圈:MCP(Model Context Protocol)。很多人混淆二者,甚至误以为它们是竞争关系
摘要:大模型应用正从通用化转向专业化,形成智能体、Copilot和嵌入式三大核心模式。智能体模式实现自主决策,适用于复杂长链任务;Copilot模式强调人机协同,提升专业工作效率;嵌入式模式将AI能力融入现有系统,实现普惠智能。三种模式协同共生,构成分层协作、知识循环的统一平台。企业应结合场景需求选择适配形态,采取小步快跑策略,培养人机协作能力,构建智能生态体系。这场AI应用变革正重塑商业运作模式
它们通过在海量文本上进行预训练,学习语言的结构、语义和知识,从而能够理解并生成流畅、连贯、上下文相关的文本。从人工智能的宏大愿景,到机器学习的数据驱动范式,再到深度学习的表征能力,最终催生出能够“创作”的生成式AI与大语言模型——这条技术演进路径不仅体现了算法的进步,更反映了人类对“智能”理解的深化。传统AI和机器学习主要聚焦于“判别”任务(如分类、预测),而生成式人工智能(Generative
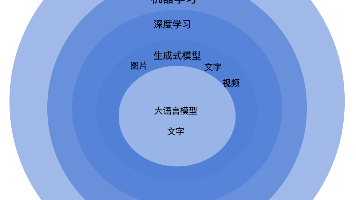
大模型 是指参数量巨大(通常在十亿(Billion)级别以上)、通过海量数据训练、具备强大泛化能力和通用任务处理能力的深度学习神经网络模型。大模型是一种通过海量数据和超大规模参数训练出的通用AI引擎,它能理解语言、生成内容、辅助决策,并正在成为企业智能化转型的新基础设施。简单来说,大模型是实现通用人工智能的一种有潜力、但目前尚不完整的路径或工具,而通用人工智能是最终的目标和愿景。自然语言:GPT-
深度学习模型架构、框架和并行计算平台构成了人工智能开发的三层体系:架构是“思考什么”,框架是“如何表达”,并行计算是“如何执行”。理解这三者的区别与联系,不仅能帮助您避免概念混淆,还能让您更好地利用每一层的优势,在AI学习之旅上稳步前行。随着您经验的积累,您将能够自如地在不同抽象层级间切换:用创新架构解决新问题,通过框架高效实现想法,并利用并行计算技术将方案扩展到实际应用中。| **变化频率**